
SignalReasoner: Avaliação de Modelos 3B para Raciocínio Matemático em Sinais
Estudo usa reforço com aprendizado para adaptar LLMs a problemas de processamento de sinais.
O que aconteceu
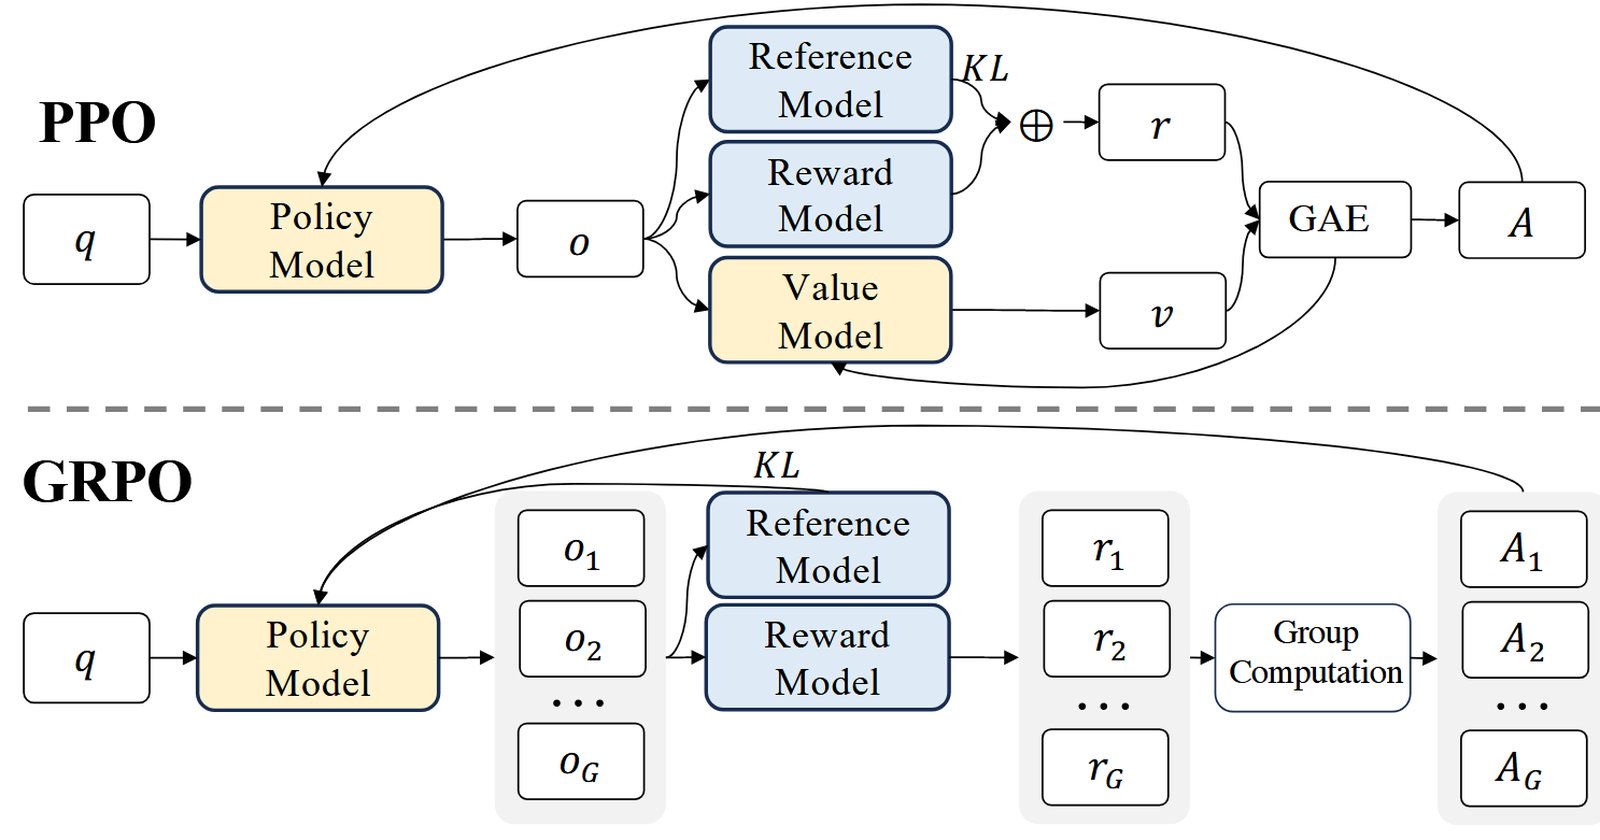
No dia 18 de agosto de 2026, foi publicado no arXiv o artigo "SignalReasoner: Assessing the Upper Bound of 3B Models for Signal Mathematical Reasoning" (arXiv:2608.17301v1). O estudo investigou estratégias de fine-tuning para adaptar o modelo Qwen2.5-3B-Base a problemas de raciocínio matemático de nível de pós-graduação em processamento de sinais, utilizando o benchmark WirelessMATHBench-XL. Foram testados dois paradigmas de treinamento: aprendizado por reforço (RL) direto com recompensas verificáveis, e ajuste supervisionado (SFT) em corpus de raciocínio do domínio wireless seguido da mesma etapa de RL. Os pesquisadores compararam métodos de otimização como GRPO, GSPO e GMPO. O melhor modelo alcançou uma acurácia geral de 39,12%, uma melhoria de mais de três vezes em relação ao modelo base, que atingiu 12,37%.
Contexto
Modelos de linguagem grandes (LLMs) têm visto melhorias significativas em raciocínio matemático graças a técnicas pós-treinamento, como ajuste supervisionado com raciocínio em cadeia (CoT) e aprendizado por reforço com recompensas verificáveis. No entanto, sua aplicação a problemas específicos de processamento de sinais permanece relativamente inexplorada. O SignalReasoner surge para preencher essa lacuna, avaliando se o ajuste supervisionado consciente do domínio pode servir como uma inicialização eficaz para etapas subsequentes de RL, e se métodos como GSPO ou GMPO oferecem vantagens em estabilidade ou precisão para tarefas de raciocínio em sinais.
Por que importa
O trabalho demonstra que modelos de pequeno porte, com apenas 3 bilhões de parâmetros, podem ser eficazes em domínios altamente técnicos quando devidamente treinados. Isso tem implicações práticas para empresas e desenvolvedores, pois reduz a necessidade de depender de modelos massivos para tarefas especializadas, cortando custos computacionais e energéticos. Para o mercado de telecomunicações, radar e processamento de sinais em geral, abre caminho para soluções de IA mais acessíveis e eficientes, que podem ser implantadas em tempo real com recursos limitados.
Impacto
No curto prazo, o estudo incentiva mais pesquisas em modelos pequenos e eficientes para aplicações de nicho, acelerando a inovação em IA para engenharia de sinais. No médio prazo, pode levar à deploy de sistemas baseados em IA em tarefas reais de processamento de sinais, otimizando operações em setores como telecom e defesa, além de influenciar estratégias de treinamento para LLMs de domínio específico.
O que muda
O SignalReasoner destaca a eficácia de combinar ajuste supervisionado com aprendizado por reforço na adaptação a domínios especializados. Embora o estudo foque na avaliação, os resultados sugerem que métodos como GSPO e GMPO podem oferecer estabilidade, embora mais dados sejam necessários para confirmar vantagens sobre o GRPO. Isso muda a abordagem para treinamento de IAs em nichos técnicos, priorizando otimizações direcionadas em vez de escala bruta.
O que vem agora
Os próximos passos incluem testar as estratégias em modelos maiores e em aplicações do mundo real, além de comparar com outros benchmarks e métodos de treinamento. A pesquisa abre caminho para estudos futuros que expandam o SignalReasoner para mais domínios de sinais, como imagem e áudio, e explorem a integração com hardware especializado para maior eficiência.