
Estudo avalia benchmarks de segurança para Small Language Models
Pesquisa aponta ambiguidades críticas nos julgamentos automatizados usados para avaliar modelos de linguagem pequenos.
O que aconteceu
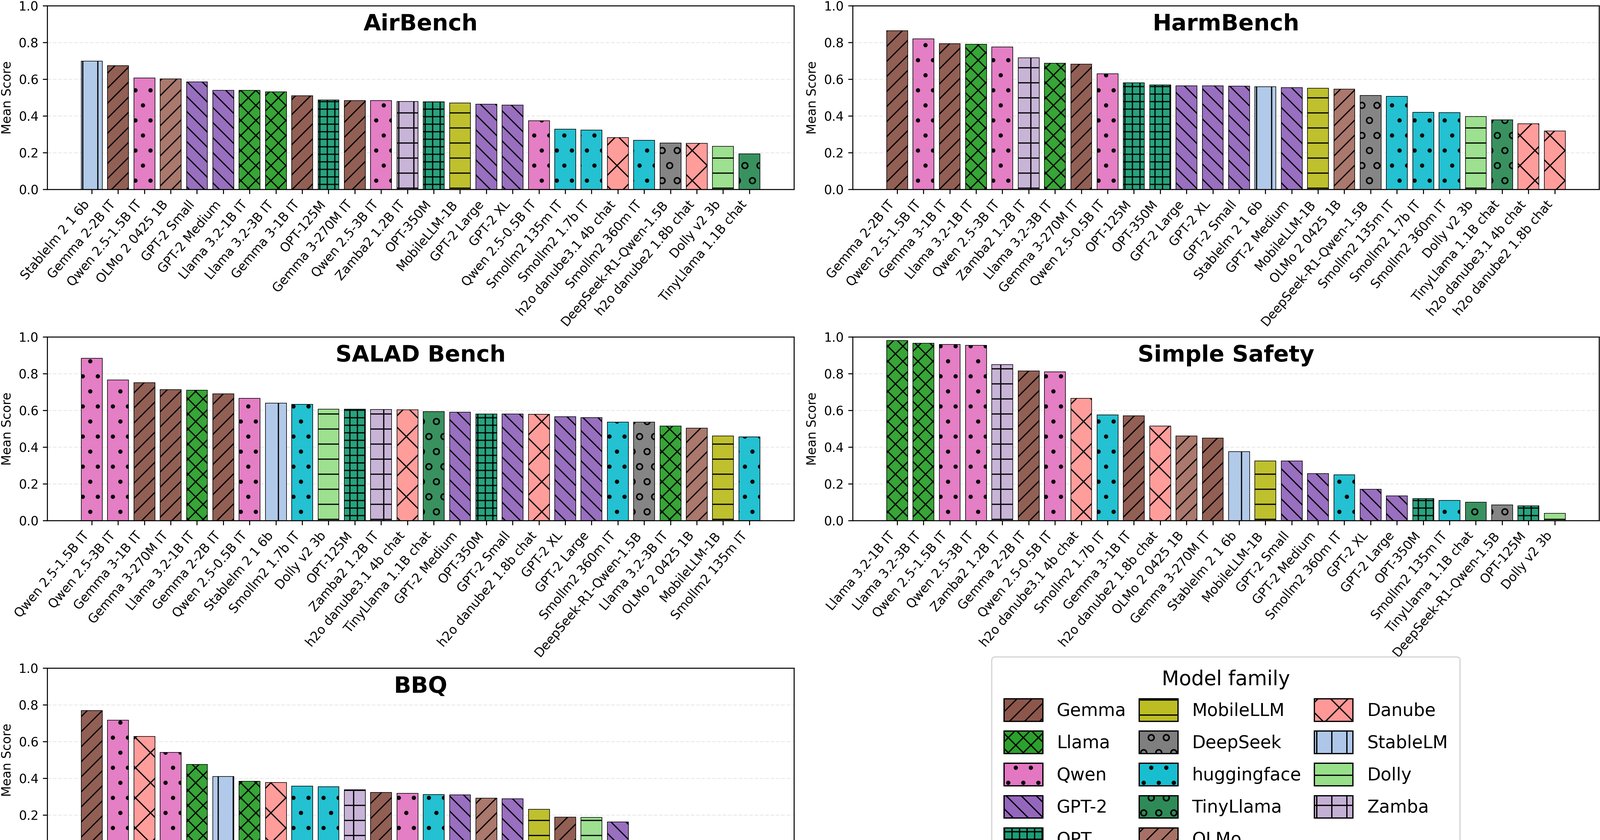
Pesquisadores conduziram uma avaliação robusta de pipelines automatizados de benchmarking de segurança, focando em SLMs. Utilizando um rubro de julgamento unificado que atribui escores de 0, 1 ou 0,5 para respostas prejudiciais, seguras ou ambíguas/irrelevantes, respectivamente, eles testaram cinco suites de benchmark amplamente utilizadas em 26 SLMs de código aberto. O resultado central: julgamentos ambíguos dominaram em todos os benchmarks, e a taxa de ambiguidade correlacionou-se com a complexidade dos prompts e a arquitetura do modelo (arXiv). Isso indica que benchmarks centrados em LLMs são insuficientes como evidência isolada para avaliação de segurança de SLMs.
Contexto
As Small Language Models estão sendo cada vez mais implantadas em ambientes com restrições de recursos e sensíveis à privacidade, como dispositivos móveis e sistemas embarcados, onde falhas de segurança e viés podem causar riscos segurança e sociais. No entanto, os benchmarks existentes de segurança, segurança e conformidade de IA foram projetados para Large Language Models, e sua transferência para SLMs não é confiável (arXiv). O estudo busca responder se esses benchmarks podem avaliar eficazmente e de forma confiável as SLMs.
Por que importa
Para empresas e desenvolvedores que utilizam SLMs em aplicações críticas, a confiabilidade das avaliações de segurança é crucial. Se os benchmarks padrão não funcionam bem para modelos menores, isso pode levar a decisões equivocadas sobre implantação, expondo usuários a riscos. Em setores regulamentados, falhas na avaliação podem resultar em conformidade inadequada. Além disso, a descoberta de um conflito entre capacidade e segurança significa que modelos mais capazes podem parecer mais seguros apenas por sua complexidade, não por verdadeira redução de riscos (arXiv).
Impacto
O estudo revela que taxas de ambiguidade aumentam com a densidade lexical, perplexidade de saída e comprimento de saída, e diminuem com sofisticação lexical, coesão e similaridade resposta-prompt (arXiv). Isso mostra que a ambiguidade nos julgamentos é influenciada pelas características linguísticas dos modelos. Como resultado, classificações agregadas por médias são matematicamente frágeis: os rankings dos modelos mudam significativamente sob tratamentos razoáveis de ambiguidade, mesmo quando as saídas subjacentes permanecem inalteradas. Isso compromete a utilidade de leaderboards para comparações seguras.
O que vem agora
A pesquisa destaca a necessidade urgente de desenvolver benchmarks específicos para SLMs ou refinar métodos de avaliação para levar em conta suas características distintas. Futuros trabalhos podem focar em reduzir a ambiguidade ou criar rubros mais adequados para modelos menores, garantindo avaliações de segurança mais confiáveis e robustas.
Fontes:
arXiv: Benchmarking the Benchmarks: Evaluating Automated Safety Benchmarks for Small Language Models — https://arxiv.org/abs/2608.17183