
Estudo avaliação LLMs em busca de informação multi-turno
Novo framework MT-InfoSeek mostra que modelos falham em saber o que perguntar e quando parar.
O que aconteceu
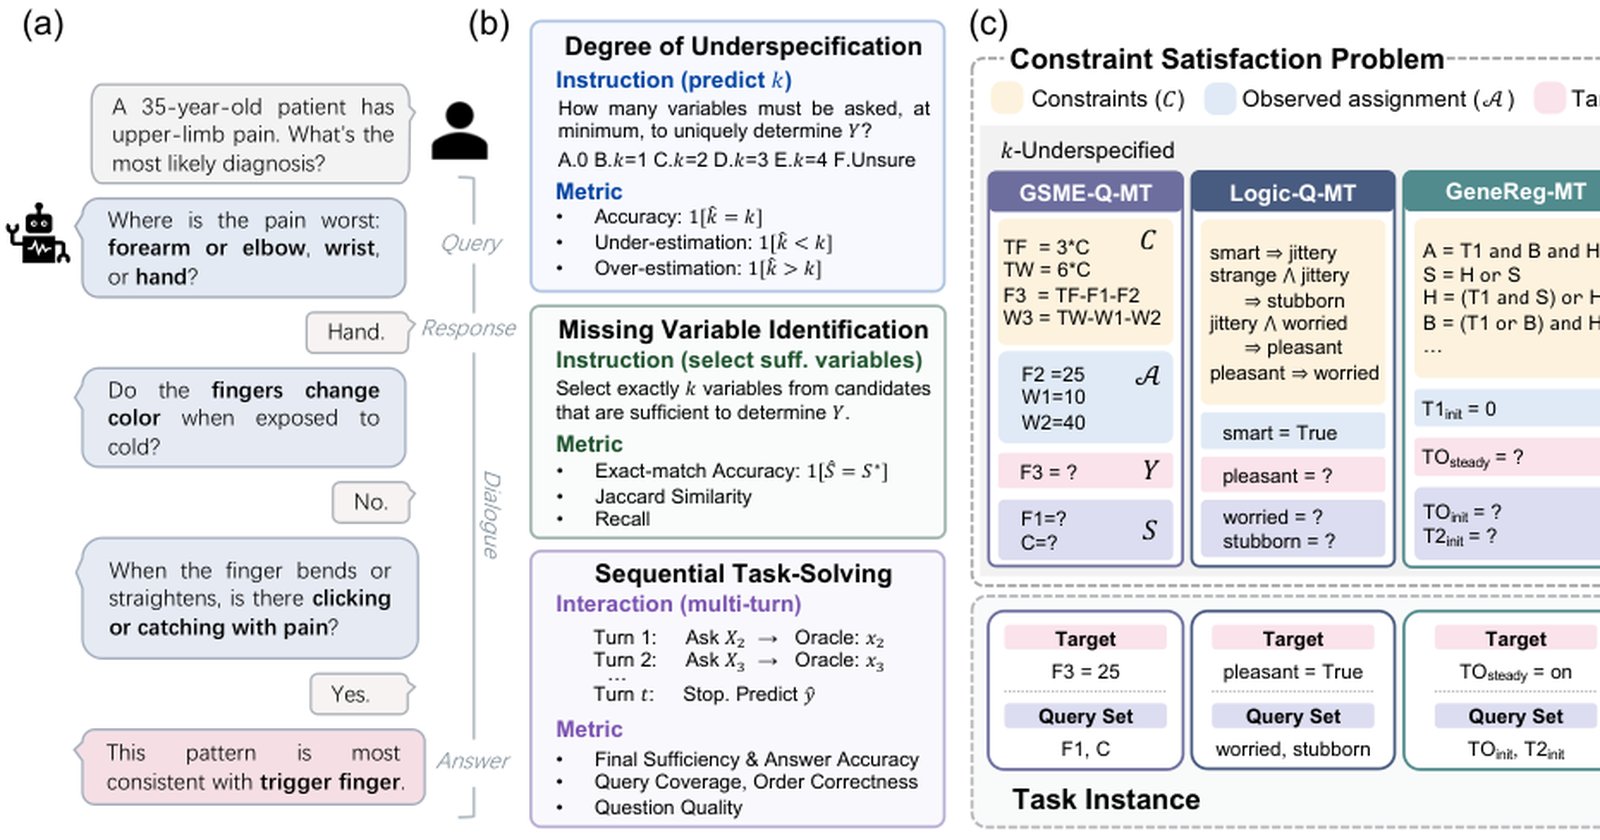
Pesquisadores formalizaram a busca de informação em múltiplas interações (multi-turn information seeking) como a resolução de um "problema de satisfação de restrições com k-variáveis não especificadas". Neste contexto, k representa o número de variáveis que um modelo precisa descobrir para determinar uma resposta única. A avaliação foi implementada no MT-InfoSeek, um conjunto controlado com 5.251 problemas e 9.006 instâncias de tarefas, abrangendo matemática, lógica, biologia, medicina e conhecimento geral (arXiv, 14/ago/2026).
Os modelos foram avaliados em três eixos: o que perguntam, quando perguntam e como a informação adquirida afeta a resposta final. O desempenho decai à medida que a subespecificação aumenta. Um achado central: em problemas de lógica com k=2, os modelos subpredizem o grau de informação faltante cerca de quatro vezes mais frequentemente do que o superpredizem. Eles também falham em identificar um conjunto mínimo e suficiente de perguntas.
Contexto
A capacidade de um assistente de IA reconhecer uma pergunta vaga, solicitar os dados faltantes e só então fornecer uma resposta precisa é fundamental para aplicações reais. Atualmente, as principais avaliações de LLMs focam na geração de respostas a prompts completos, não na busca ativa de informação. Este estudo propõe uma métrica separada, a "suficiência final", que mede se a informação coletada é suficiente para determinar o alvo, independentemente da geração da resposta final.
Por que importa
Os resultados indicam que a habilidade de buscar informação ao longo de várias interações é distinta da habilidade de gerar respostas e não é capturada pelas avaliações atuais. Isso tem implicações diretas para o uso de LLMs em profissões que dependem de perguntas de acompanhamento, como diagnóstico médico, consultoria técnica ou pesquisa de mercado, onde uma pergunta inicial incompleta é a regra, não a exceção.
Impacto
No curto prazo, o trabalho pressiona o desenvolvimento de novas métricas e benchmarks que priorizem a busca de informação, e não apenas a precisão factual em perguntas únicas. A médio prazo, pode direcionar o treinamento de modelos para melhorar a metacognição – a capacidade de avaliar o que não sabem e planejar estratégias de perguntas. Modelos que pararam de buscar informação antes do momento ideal tendem a fornecer respostas imprecisas ou impossíveis em cenários do mundo real.
O que muda
O paradigma de avaliação está sendo questionado. O estudo mostra que a precisão final (final accuracy) não captura diferenças entre modelos que a métrica de suficiência final revela. Isso sugere que modelos com desempenho similar em testes padrão podem ter capacidades muito diferentes de interação e resolução de problemas abertos. A ordem das perguntas também se mostrou crítica: uma sequência incorreta reduz a precisão final, mesmo que todas as informações necessárias sejam eventualmente adquiridas.
O que vem agora
A publicação do MT-InfoSeek como framework aberto (com problemas e instâncias disponíveis) deve catalisar novas pesquisas. Próximos passos lógicos incluem a expansão do conjunto para outros domínios, o desenvolvimento de modelos especializados em "agentes de perguntas" e a integração dessas métricas em avaliações corporativas. A pesquisa também aponta para a necessidade de treinar LLMs não apenas para responder, mas para planejar cadeias de perguntas eficientes e autônomas.