
Estudo do arXiv mapeia limites de sinais internos em LLMs como o Qwen3
Pesquisa mostra que sinais de estado em redes neurais podem ser úteis sem sustentar mapas de ação reutilizáveis
O que aconteceu
Pesquisadores submeteram em 13 de agosto de 2026 um artigo no arXiv intitulado "A Calibrated Test of Internal Action Maps: State Signals Without Global Affine Closure" (arXiv:2608.13626v1). O estudo conduziu uma série de testes controlados sobre "mapas de ação" internos – operações matemáticas que tentam descrever transições de estado dentro da rede neural – em um LLM pré-treinado.
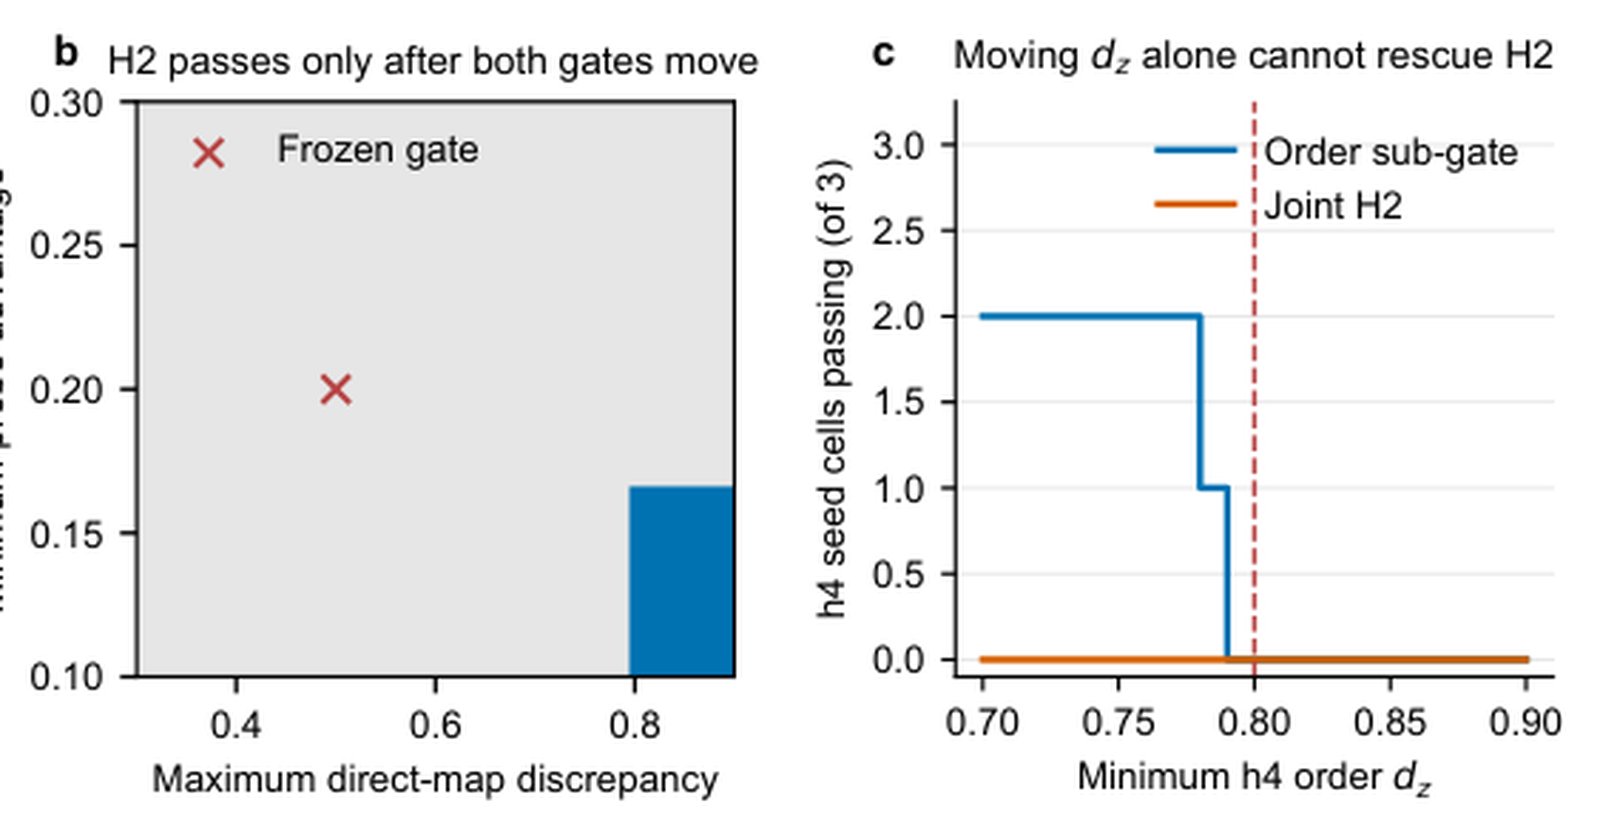
O ponto central é a verificação se esses mapas, treinados em um contexto (ou "fonte"), podem ser generalizados para contextos novos (ou "entidades" de teste) e se compõem de forma consistente. Os testes foram organizados como uma "lattice de evidência" e validados em um "mundo finito" conhecido (o grupo afim S_5). Os resultados foram claros: os mapas passaram testes básicos (como transição de um passo, inversão e comutatividade) no conjunto de dados de treino, mas sua performance degradou-se significativamente em dados não vistos.
No modelo Qwen3-4B, camadas específicas mostraram padrões distintos. Os mapas afim extraídos da camada h28 (penúltima camada do transformer) apresentaram um erro médio de 0.519 em entidades não vistas, contra 0.398 quando ajustados diretamente nos dados de teste. Experimentalmente, os pesquisadores descobriram que os "efeitos causais" dessas intervenções só se manifestaram claramente nas camadas profundas (h28 e h36).
Contexto
O campo da "interpribilidade" de redes neurais busca entender como e onde informações são representadas e transformadas dentro de um LLM. Uma hipótese recorrente é que modelos desenvolvem "módulos" internos com funções algebáricas específicas. Este estudo se insere nessa linha, mas com um foco crítico: testar a robustez desses módulos com um rigor formal, usando conceitos de álgebra abstrata para medir "closure" (fechamento operacional).
O modelo escolhido, Qwen3-4B, é uma LLM de 4 bilhões de parâmetros, oferecida pela Alibaba Cloud. A pesquisa se limitou a analisar camadas específicas (h4, h16, h28, h36) e funções de transição afim, o que delimita a abrangência das conclusões, mas aumenta o controle experimental.
Por que importa
A descoberta tem implicações diretas para a pesquisa em interpretabilidade e engenharia de prompts. Se os "mapas de ação" internos não são universalmente aplicáveis, isso sugere que as representações de conhecimento em LLMs podem ser mais contextualizadas e menos "modulares" do que o idealizado. Para desenvolvedores e pesquisadores, isso indica que intervenções cirúrgicas no estado interno de um modelo (técnicas como o "activation steering") podem não ser tão previsíveis ou transferíveis entre tarefas.
O estudo também valida metodologicamente uma abordagem rigorosa de teste, usando um "mundo finito" controlado para isolar variáveis, antes de aplicar a um modelo real-world. Isso fortalece a confiabilidade das conclusões dentro do escopo testado.
Impacto
No curto prazo, a pesquisa adiciona uma importante "reserva" técnica às alegações sobre a capacidade de "engenharia mecânica" de LLMs. Ela mostra que, mesmo quando um sinal de estado existe e é causalmente útil, ele pode não suportar operações composicionais complexas.
Para a comunidade de pesquisa, isso reforça a necessidade de testes de generalização rigorosos. O trabalho delimita claramente onde os sinais são robustos (transições simples) e onde falham (composição), fornecendo um roteiro para futuros estudos. Limita a narrativa de que LLMs "aprendem algoritmos universais" internamente.
O que muda
Os resultados indicam que, dentro dos limites do estudo (um modelo, duas "mundos finitos" e funções afim), quatro propriedades são separáveis: a disponibilidade de um sinal de estado, seu uso causal, sua geometria local e a capacidade de "fechamento algébrico" reutilizável. Essa separação sugere que avanços em uma dimensão (ex.: melhor decodificação) não garantem avanços em outra (ex.: composição robusta).
A pesquisa também destaca que camadas mais profundas (h28/h36) são as mais relevantes para intervenções causais, enquanto camadas intermediárias (h4/h16) se ajustam melhor a transições diretas, mas têm outras limitações (como decodificação fraca de estados de conflito).
O que vem agora
Os próprios autores reconhecem as limitações do trabalho: os resultados são baseados em um único modelo, camadas amostradas, dois mundos finitos e uma classe específica de funções (afim). Próximos passos óbvios incluem:
1. **Expansão do modelo:** Repetir os testes em outras arquiteturas e tamanhos de LLMs (ex.: modelos maiores, modelos de código aberto como Llama).
2. **Ampliação de funções:** Testar classes de funções mais complexas que as afim para mapeamento.
3. **Investigação causal mais profunda:** Usar técnicas de intervenção como o "activation patching" em escala maior para mapear os circuitos causais de forma mais granular.
4. **Estudo de "mundos" maiores:** Aumentar a complexidade e realismo dos conjuntos de dados "controlados" para testar a escalabilidade das conclusões.
A pesquisa se limita ao estudo publicado, sem especular sobre próximos passos não declarados pelos autores.