
Estudo identifica miscalibração estável em grandes modelos de linguagem
Pesquisa mostra que respostas erradas confiantes podem persistir sob pequenas perturbações
O que aconteceu
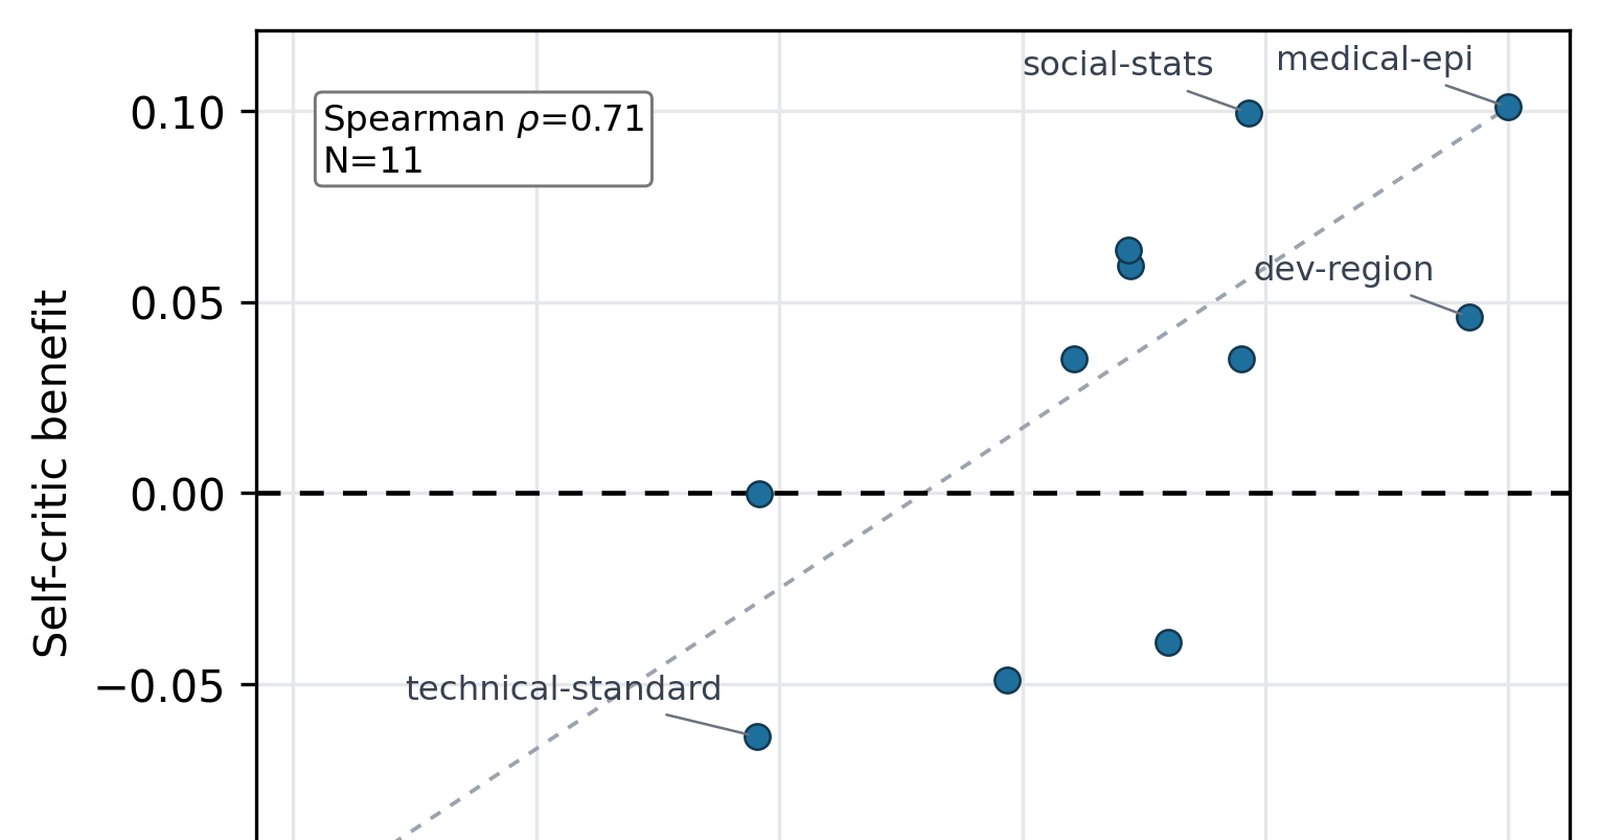
A pesquisa intitulada 'Stable Miscalibration in Large Language Models: A Practical View of High-Confidence Errors' foi submetida ao arXiv em 15 de julho de 2026. O estudo combina duas abordagens diagnósticas: uma auditoria de nível de saída, que classifica domínios por variação de confiança e erros sobrecarregados sob um baseline de resposta forçada, e uma sonda interna de sensibilidade que mede movimentos em camadas ocultas. Em um conjunto de auditoria factual binária multidomínio, os resultados indicam que o score de auditoria rastreia onde a autocrítica ciente de abstenção reduz a perda de decisão. Internamente, o prompting autocrítico reduz consistentemente a sensibilidade do estado oculto em três modelos de peso aberto, suportando uma estabilização local induzida por prompt. No entanto, isso não implica calibração: erros sobrecarregados definidos pela auditoria não são claramente mais sensíveis localmente do que respostas corretas confiantes, sugerindo que alguns erros de alta confiança são estáveis e miscalibrados.
Contexto
Tradicionalmente, quando LLMs como GPT erram com alta confiança, isso é interpretado como evidência de um raciocínio interno frágil, passível de correção com ajustes simples. No entanto, este estudo explora a miscalibração estável como uma alternativa, onde o modelo mantém uma resposta errada mesmo sob pequenas perturbações. Isso desafia a suposição comum de que erros confiantes são aleatórios ou facilmente corrigidos, trazendo uma nova perspectiva para a avaliação de falhas em sistemas de IA.
Por que importa
Para desenvolvedores, empresas e pesquisadores que utilizam LLMs em aplicações críticas, isso significa que a confiança do modelo por si só não é um indicador confiável de precisão. Erros estáveis podem persistir em sistemas automatizados, afetando decisões em áreas como saúde, finanças ou客户服务. A pesquisa sugere a necessidade de técnicas de auditoria mais refinadas, como o prompt de autocrítica, que reduz a sensibilidade interna e pode melhorar a detecção desses erros.
Impacto
No curto prazo, isso pode levar a uma revisão de métodos de validação e controle de qualidade para LLMs, com foco em estratégias de auditoria que considerem miscalibração estável. No médio prazo, poderia inspirar novas abordagens de segurança em IA, incentivando o desenvolvimento de ferramentas que identifiquem e mitiguem erros estáveis. Para startups e empresas brasileiras de tech, isso reforça a importância de testar robustez dos modelos em ambientes reais, além de confiar apenas em métricas de confiança.
O que muda
O estudo demonstra que o prompting autocrítico reduz a sensibilidade do estado oculto, apoiando uma estabilização local induzida por prompts. Isso abre caminho para técnicas de engenharia de prompts que mitiguem erros estáveis, melhorando a confiabilidade dos LLMs. Além disso, o score de auditoria proposto pode ser integrado em fluxos de trabalho para priorizar domínios com maior risco de miscalibração.
O que vem agora
Próximos passos incluem expandir a pesquisa para mais modelos e domínios, validar os diagnósticos em contextos aplicados, e desenvolver ferramentas práticas de auditoria que possam ser adotadas pela indústria. A comunidade de IA pode integrar essas descobertas em padrões de avaliação e segurança, promovendo LLMs mais robustos e transparentes.