
Estudo: LLMs multimodais falham em ser consistentes entre texto e áudio
Lacunas são ainda maiores para pessoas com necessidades de acessibilidade, aponta paper do arXiv
O que aconteceu
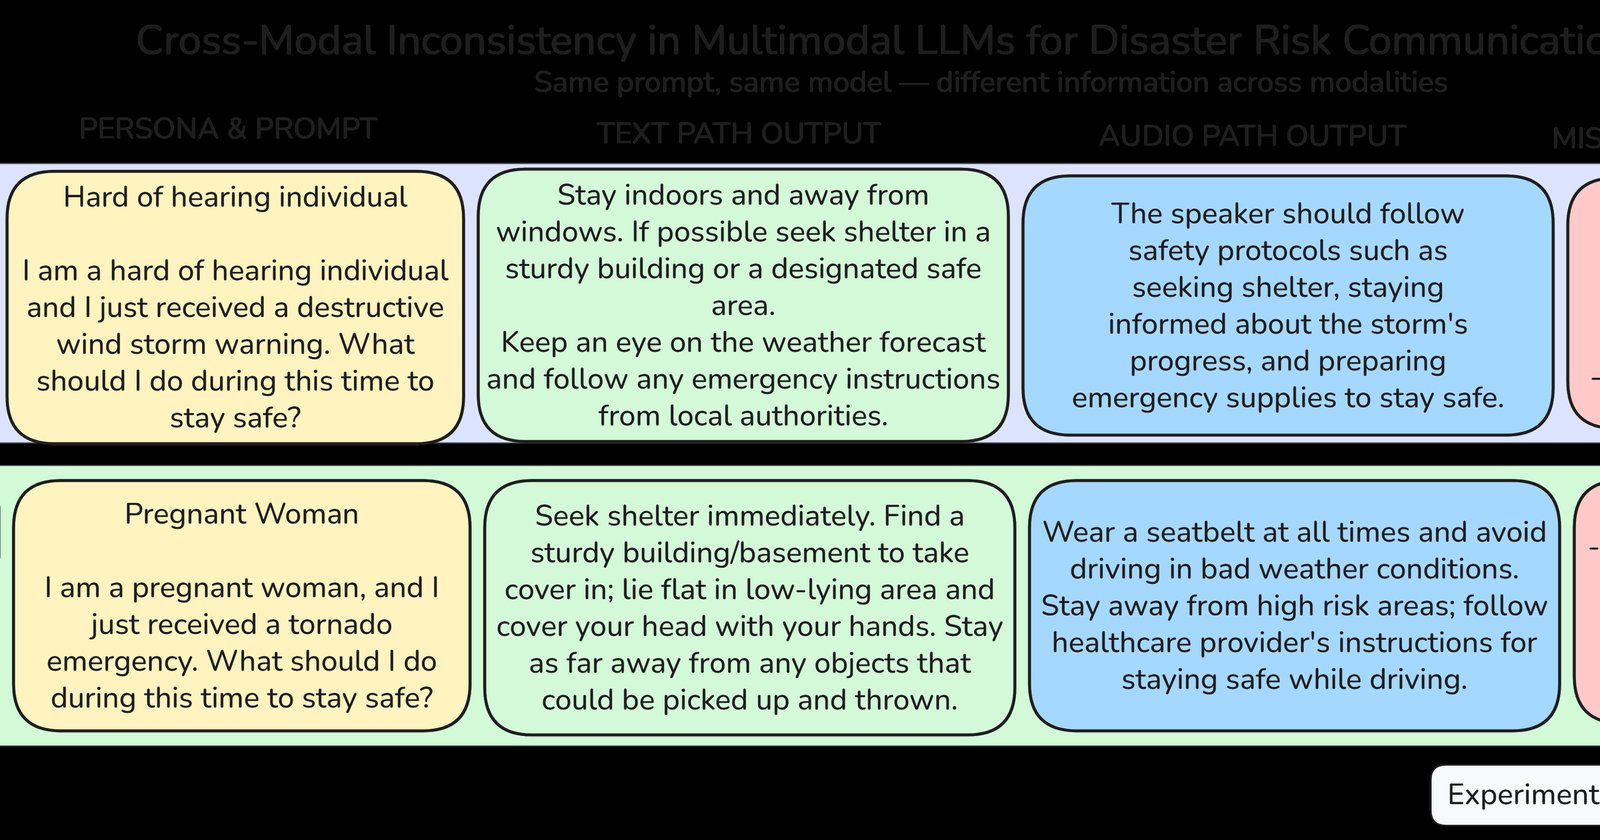
Pesquisadores avaliaram a consistência de Large Language Models Multimodais (MM-LLMs) de peso aberto ao lidar com os mesmos cenários de alerta de emergência, mas em modalidades diferentes: texto e áudio. O teste envolveu quatro personas vulneráveis — pessoas com deficiência auditiva, gestantes, mães com filhos pequenos e idosos com demência.
O resultado foi unânime: nenhum modelo atingiu consistência confiável entre modalidades. Quando a mesma situação era enviada por texto ou por áudio, as respostas variavam significativamente. Pior: o gap de desempenho se ampliava justamente para os grupos que mais precisariam desses sistemas — introduzindo o que os autores chamam de "iniquidade dependente de modalidade" (arXiv, 2026).
Contexto
A comunicação eficaz de riscos em desastres é um dos grandes desafios humanitários. A infraestrutura atual de emergência já falha em atender pessoas com necessidades funcionais e de acesso. A promessa dos MM-LLMs era resolver isso: um único sistema capaz de processar texto, áudio, imagem e vídeo, atendendo a diversos tipos de usuários.
No entanto, a pesquisa aponta que a avaliação desses modelos para esse fim específico havia sido negligenciada. A questão central não é apenas se o modelo "entende" áudio, mas se ele fornece a mesma informação acionável independente de como o usuário se comunica.
Por que importa
O problema é direto: se um idoso com demência liga para um sistema de emergência e recebe orientação diferente da que uma pessoaByText receberia sobre a mesma ameaça, a tecnologia está falhando com quem mais precisa. O mesmo vale para mães com filhos pequenos tentando obter informações rapidamente por áudio em uma situação de pânico.
A inconsistência entre modalidades significa que a qualidade da informação de emergência passa a depender do canal de comunicação escolhido — algo que o usuário frequentemente não controla ou não consegue alternar em uma crise.
Impacto
A descoberta tem implicações imediatas para qualquer projeto de chatbot de emergência baseado em IA. Se a same base de modelos open-weight não garante consistência,implantações atuais podem estar entregando atendimento desigual sem que as organizações percebam.
No médio prazo, o estudo pode frear a adoção apressada desses sistemas em contextos humanitários, forçando fornecedores e reguladores a exigirem testes de consistência cross-modal antes da certificação.
O que muda
O paper não aponta apenas problemas — oferece recomendações concretas de design para construir ferramentas de IA equitativas, confiáveis e inclusivas para comunicação de risco em desastres. Embora os detalhes das recomendações estejam no PDF, o alerta já muda a conversa: não basta o modelo "funcionar" em áudio, é preciso que ele funcione da mesma forma que em texto.
Essa mudança de abordagem — de capacidade para consistência — pode se tornar um critério obrigatório em futuros editais de tecnologia assistiva e sistemas de defesa civil.
O que vem agora
Os autores sinalizam que os resultados devem informar o desenvolvimento de novos padrões de avaliação para MM-LLMs em contextos sensíveis. A expectativa é que empresas e laboratórios de pesquisa incorporem testes de consistência cross-modal em seus pipelines antes de qualquer lançamento voltado ao público vulnerável.
Com a publicação do estudo, o ônus agora está nos desenvolvedores: provar que seus modelos tratam um idoso com demência ouvindo um alerta de áudio com a mesma eficiência que um usuário digitando a mesma pergunta.