
Estudo mostra que supervisionar 0,05% dos tokens basta para treinar raciocínio de LLMs
Pesquisa no arXiv desafia a premissa de que o pós-treinamento de modelos de linguagem precisa ser intensivo em tokens
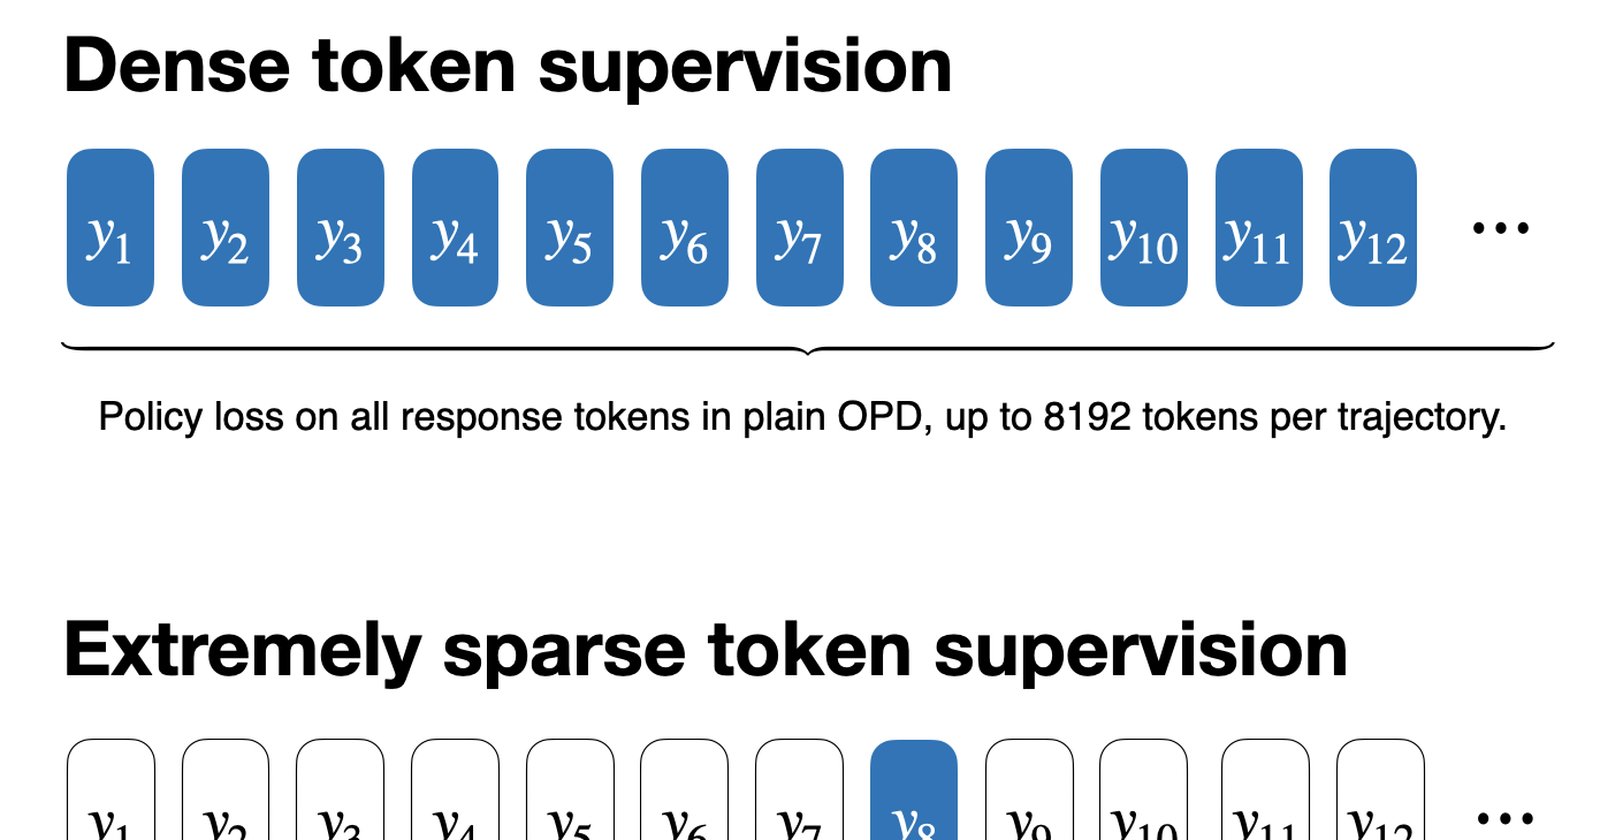
O que aconteceu
O artigo "Extremely Sparse Supervision Incentivizes Reasoning Ability", registrado no arXiv sob o número 2609.04565v1 e submetido em 3 de setembro de 2026, questiona uma premissa central do pós-treinamento de grandes modelos de linguagem (LLMs). Os métodos predominantes otimizam sobre quantidades massivas de tokens, partindo do pressuposto implícito de que aprendizado eficaz precisa ser intensivo em tokens.
Os pesquisadores revisitaram essa suposição no cenário de destilação on-policy (OPD, na sigla em inglês), que naturalmente permite supervisão densa do modelo professor em cada token gerado. Usando a família de modelos Qwen3, o estudo descobriu um fenômeno contraintuitivo: a capacidade de raciocínio pode ser incentivada por uma fração extremamente pequena dos tokens gerados. Bastam um ou dois tokens por trajetória de raciocínio, o equivalente a apenas 0,05% de todos os tokens.
O resultado mais surpreendente é que essa supervisão esparsa, na maioria dos casos, iguala ou supera o treinamento com todos os tokens na melhoria do raciocínio, mesmo excluindo a grande maioria dos tokens gerados do objetivo de treinamento.
Contexto
O pós-treinamento é a etapa que transforma um modelo de base em um modelo útil, e é nele que os atuais avanços em raciocínio foram construídos. A destilação on-policy é uma técnica em que um modelo professor, mais capaz, orienta o aprendizado de um modelo aluno durante a geração de texto. Como o professor acompanha cada token produzido, a prática comum era corrigir e supervisionar tudo, token por token.
O estudo testou se essa densidade toda era necessária. A resposta foi não. Os autores sugerem que a supervisão extremamente esparsa pode estar mais próxima do processo natural de aprendizagem: em vez de corrigir cada passo palavra por palavra, reflete-se sobre poucos passos críticos de raciocínio, atualiza-se a compreensão anterior e continua-se o processo de tentativa e erro, evitando microcorreções sem perder eficácia.
Por que importa
O fenômeno foi observado de forma consistente em nove configurações de pares professor-aluno, abrangendo diferentes escalas de modelo, em tarefas de raciocínio matemático. A validação não parou aí: os resultados se repetiram em tarefas de raciocínio para código, em modelos da família Llama e em aprendizado por reforço com recompensa verificável (RLVR) baseado em Proximal Policy Optimization (PPO).
A implicação prática é direta. Se 0,05% dos tokens bastam, o custo computacional do pós-treinamento pode cair drasticamente, porque a maior parte dos tokens gerados sai do objetivo de treinamento. Para laboratórios e empresas que treinam modelos, isso significa menos GPU, menos tempo e menos dinheiro para o mesmo ganho de raciocínio.
Impacto
No curto prazo, o achado da supervisão esparsa dá aos times de pesquisa uma alavanca concreta de eficiência: treinar com uma fração mínima dos tokens e comparar o resultado com o pipeline completo antes de gastar recursos. A robustez do resultado, comprovada em Qwen3, Llama, matemática, código e PPO, reduz o risco de ser uma peculiaridade de um único modelo ou domínio.
No médio prazo, o trabalho aponta para uma nova direção no desenho de algoritmos de pós-treinamento mais eficientes. A questão que se abre é identificar quais são os poucos tokens críticos que realmente importam em uma trajetória de raciocínio, e por que corrigi-los transmite mais aprendizado do que supervisionar tudo.
O que muda
Muda a premissa. Até agora, a indústria operava com a suposição de que pós-treinamento eficaz exige otimização sobre todos os tokens gerados. O artigo do arXiv demonstra que essa suposição não se sustenta: a supervisão em 0,05% dos tokens, distribuída em um ou dois pontos por trajetória, alcança desempenho equivalente ou superior ao treino completo na maioria dos casos testados.
O que vem agora
O artigo foi submetido ao arXiv em 3 de setembro de 2026 e está disponível na categoria de Inteligência Artificial (cs.AI). Como é comum nesse estágio, o trabalho ainda precisa passar pela revisão por pares e pela reprodução independente pela comunidade. Os próprios autores definem o caminho seguinte: entender e projetar algoritmos de pós-treinamento mais eficientes a partir dessa descoberta sobre supervisão esparsa.