
Estudo não encontra sinal universal para prever regressão em LLMs após atualização
Novo paper analisa como prever quando uma nova versão piora o desempenho em amostras específicas.
O que aconteceu
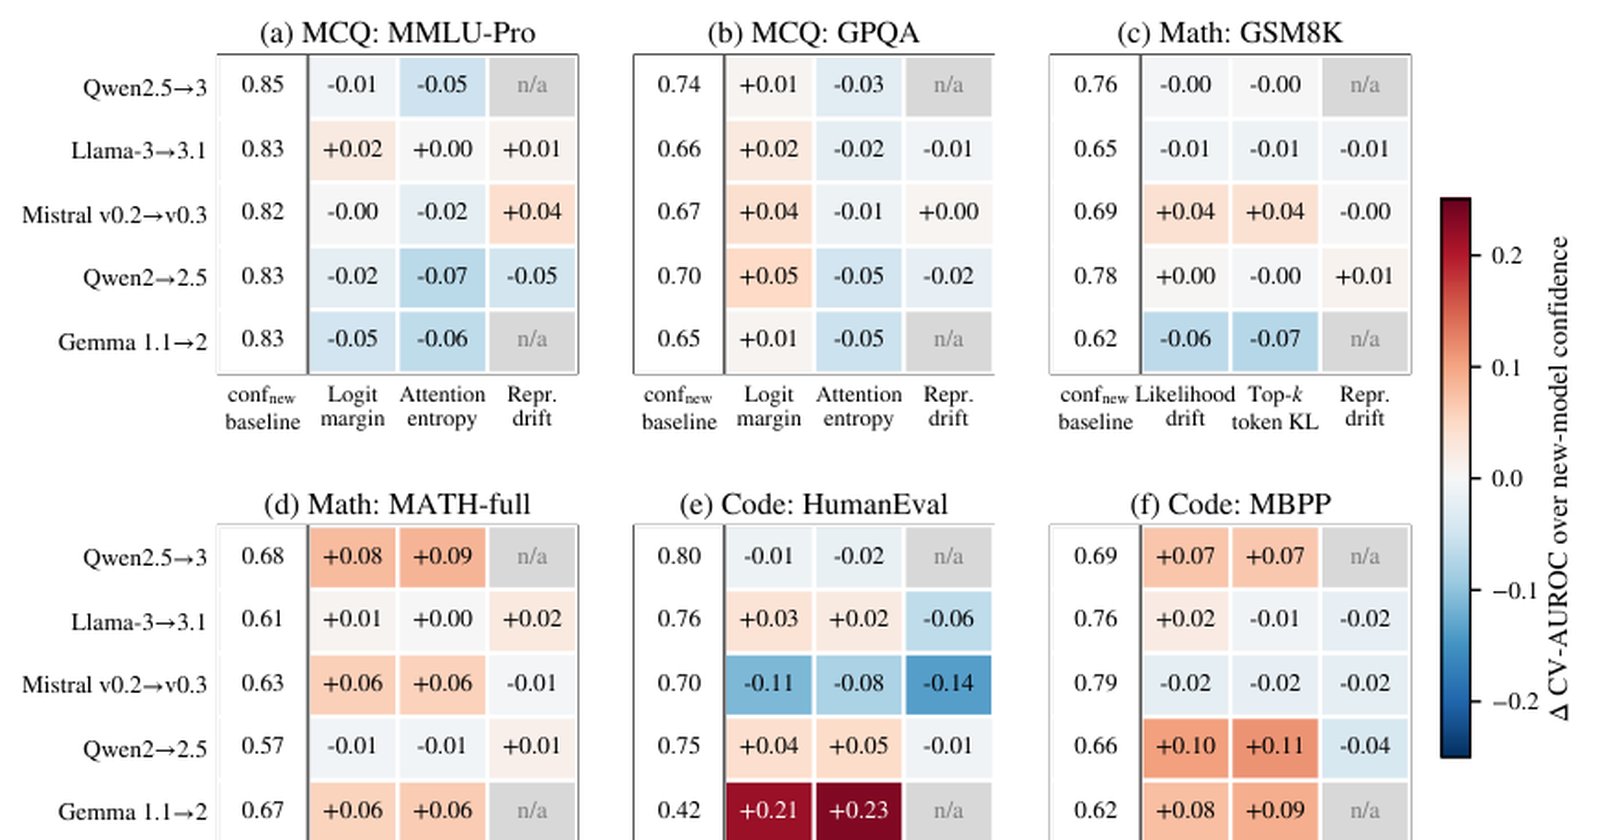
Em 11 de agosto de 2026, foi publicado no arXiv (arXiv:2608.13607v1) um paper intitulado "No Universal Signal Predicts Sample-Level LLM Regression under Version Updates". O estudo investigou como prever quando uma resposta correta sob o modelo antigo se torna incorreta em uma atualização. A equipe testou dois tipos de sinais: os de modelo único (como a "confiança" do próprio modelo) e os entre versões (como a divergência KL da saída). Eles conduziram testes unificados em seis benchmarks, abrangendo três famílias de tarefas (raciocínio matemático, geração de código e perguntas de múltipla escolha) e seis pares de atualização de modelos.
Os principais achados foram: (1) a eficácia do sinal depende da tarefa — a "confiança" é melhor em perguntas de múltipla escolha e matemática simples, enquanto sinais como likelihood/KL são mais úteis em matemática complexa e código; (2) nenhum sinal foi o melhor universalmente em todas as atualizações; e (3) alguns sinais entre versões continuam informativos mesmo quando a confiança falha, o que permite um conceito de "fallback" seletivo, redirecionando amostras de alto risco de volta ao modelo antigo.
Contexto
Modelos de linguagem de fronteira (frontier LLMs) são atualizados com frequência pelas empresas de tecnologia. Em geral, as versões novas superam as antigas em métricas médias. Contudo, esses ganhos agregados não garantem que todas as respostas individuais melhorem. A regressão em nível de amostra é um problema prático para desenvolvedores e empresas que dependem desses modelos em produção, pois pode gerar falhas inesperadas em fluxos automatizados. O paper busca oferecer ferramentas para identificar esse risco antes de uma implantação.
Por que importa
Para desenvolvedores e empresas que integram LLMs em seus sistemas, a ability de prever regressões é crítica para manter a confiabilidade. Uma atualização que piora respostas específicas pode causar erros em aplicativos, ferramentas de código ou sistemas de suporte. O estudo mostra que não existe um detector mágico. A escolha do sinal de alerta deve ser feita com base no tipo de tarefa que o sistema executa, o que exige uma avaliação técnica prévia da atualização.
Impacto
No curto prazo, equipes de engenharia de IA podem usar os padrões identificados (ex.: usar sinais KL para sistemas de código) para implementar verificações de regressão. No médio prazo, o trabalho reforça a necessidade de pipelines de avaliação robustos, testando não apenas o desempenho geral, mas também a estabilidade em amostras específicas. Isso pode aumentar a complexidade e o custo de validação de novos modelos antes da adoção em larga escala.
O que vem agora
O código-fonte para replicar os testes e os sinais está disponível no GitHub (https://github.com/jiashengsally/llm-regression-signals), permitindo que a comunidade aplique e refine a abordagem. A pesquisa abre caminho para estudos futuros que busquem combinar múltiplos sinais ou desenvolver modelos treinados especificamente para detectar essas regressões, tornando o processo de atualização de LLMs mais seguro e previsível.