
Estudo revela falha crítica em métricas usadas para avaliar agentes de código de IA
Artigo do arXiv diagnostica erro no uso do pass@k e propõe methodologia mais rigorosa
O que aconteceu
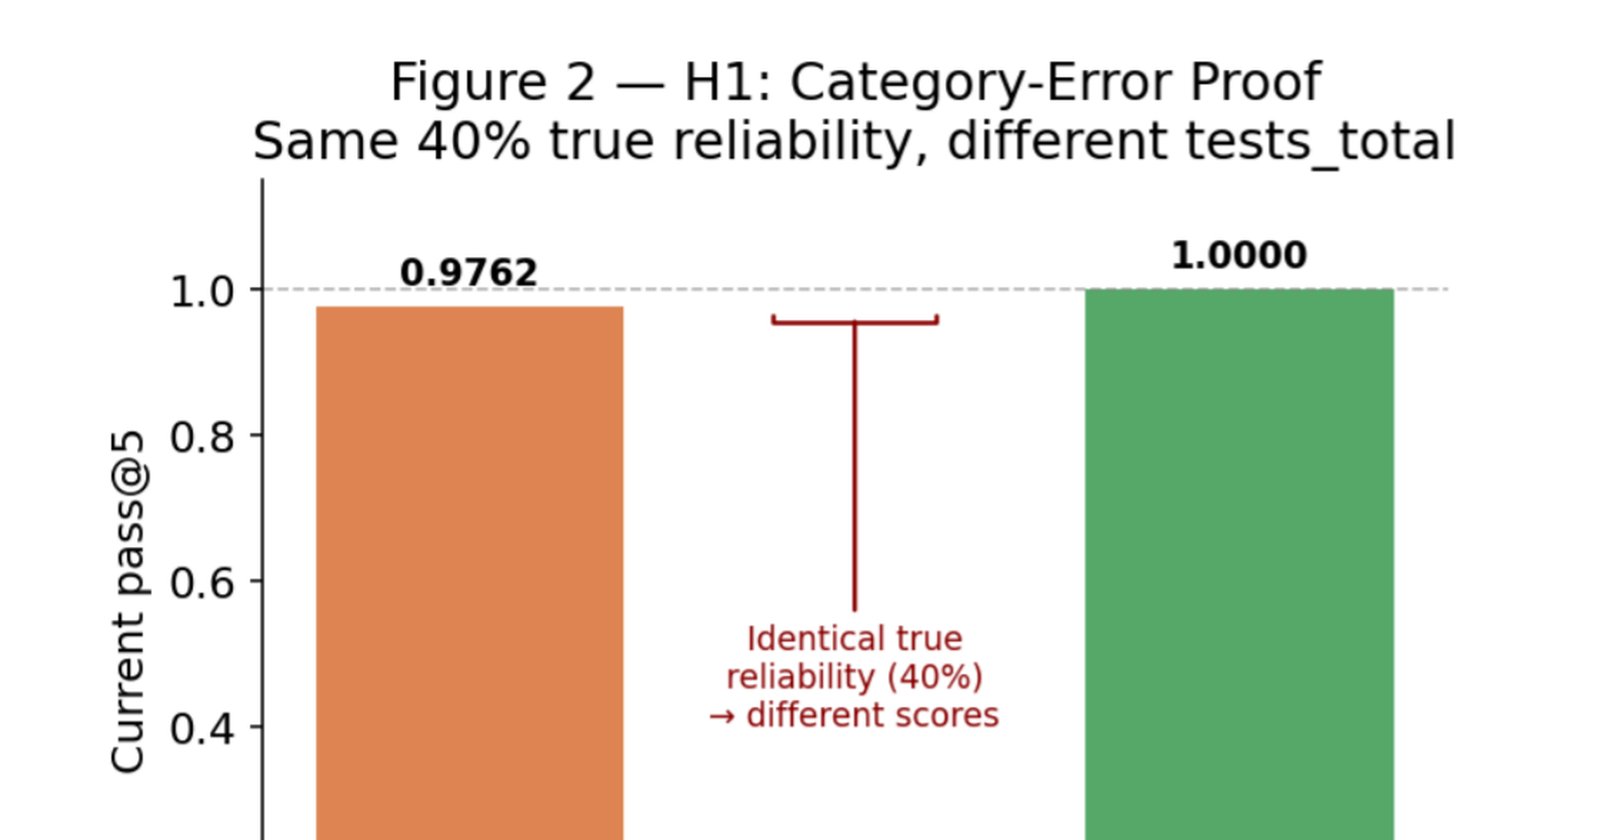
Um paper publicado no arXiv (arXiv:2608.14711) em 11 de agosto de 2026 diagnostica um erro operacional na aplicação do estimador pass@k, amplamente utilizado em benchmarks de agentes de código. O problema: as implementações atuais confundem o tamanho da suíte de testes (nº de unit tests) com o número de tentativas independentes de execução (rollouts).
Em um benchmark sintético, a métrica incorreta infla os escores reportados em 0,85 a 0,97 em termos absolutos (de 0,96-0,98 reportados para 0,00-0,12 corrigidos). O estudo também demonstra que um proxy barato de execução única não substitui a necessidade de múltiplas tentativas, com uma correlação de Spearman (ρ) de apenas 0,417.
Contexto
O pass@k é o padrão de mercado para avaliar se um agente de IA consegue gerar código funcional. A métrica original, proposta por Chen et al. em 2021, mede a probabilidade de ao menos uma das `k` tentativas independentes resolver um problema. O paper argumenta que a operacionalização atual erra ao tratar cada teste unitário como uma "tentativa", quando na verdade deveria ser contada a quantas vezes o agente foi executado de forma independente para a mesma tarefa.
Por que importa
Isso impacta diretamente a forma como empresas, pesquisadores e desenvolvedores confiam em rankings de ferramentas de IA para código. Se os benchmarks inflam os desempenhos, decisões de adoção tecnológica e investimentos podem ser baseadas em dados imprecisos. A pesquisa mostra que a correção muda drasticamente os números, colocando em dúvida a confiabilidade de muitos resultados publicados.
Impacto
Além de corrigir a métrica, os autores propõem o reliability@k (nº de rollouts independentes / c) e, motivados por evidências de que correção funcional não garante segurança, introduzem o security-adjusted reliability@k. Este último conta apenas execuções que são simultaneamente funcionais e livres de padrões inseguros de alta severidade. Em um teste preliminar com três agentes via API, a ajuste não alterou rankings, mas serve como lente complementar futura.
Um piloto com o SWE-bench Verified, usando 5 tarefas reais, reforça a preocupação: a taxa média de aprovação em testes ocultos foi de 0,80 (80%), enquanto a resolução estrita da tarefa foi de apenas 0,20 (20%).
O que muda
A pesquisa pode forçar uma revisão dos benchmarks e das práticas de avaliação da indústria. Agências de classificação e times de engenharia precisarão considerar o reliability@k como um novo padrão. A inclusão de uma lente de segurança também pode elevar o piso de qualidade exigido para que uma solução de código gerado por IA seja considerada pronta para produção.