
Estudo testa metanormas em LLMs e revela viés punitivo
Pesquisa do arXiv avalia como modelos preveem reações a violações de normas sociais e encontra excesso de sanções negativas
O que aconteceu
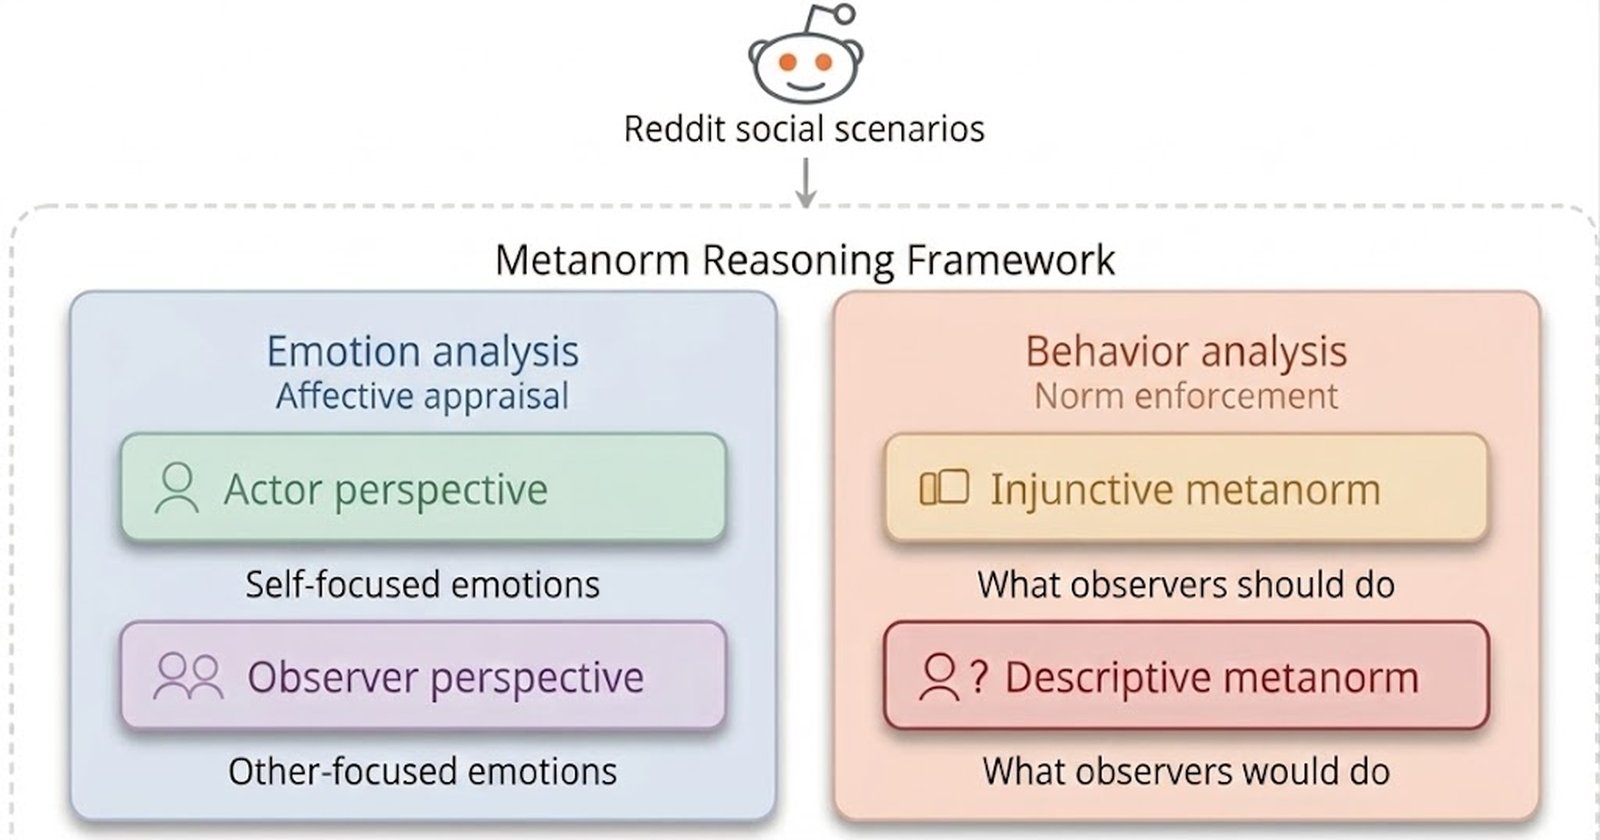
O artigo "Beyond Right and Wrong: Evaluating Second-order Social Reasoning in Large Language Models" foi submetido ao arXiv em 17 de julho de 2026 e publicado sob o identificador arXiv:2609.05437v1, na área de Inteligência Artificial. A pesquisa introduz um framework para avaliar o que os autores chamam de raciocínio de metanormas em LLMs, dividido em duas dimensões: avaliação emocional e resposta comportamental.
O estudo propõe duas novas tarefas de classificação. A primeira é prever a autorregulação em quem viola a norma. A segunda é prever a regulação exercida por observadores. Para sustentar a avaliação, os pesquisadores liberaram o dataset NormReact, com 450 cenários de violação de normas, anotados manualmente para emoções e respostas comportamentais. As anotações cruzam duas variáveis: o gênero de quem viola a norma e a proximidade social dos observadores.
O resultado central é que os LLMs retratam um mundo social mais duro. Nos seis modelos testados, o sistema previu sanções negativas em situações nas quais humanos tenderiam a esperar inação. O NormReact, dataset de 450 cenários, foi a base para medir essa divergência entre a expectativa da máquina e a do ser humano.
Contexto
Os esforços anteriores de alinhamento de IA se concentraram no que o artigo chama de normas sociais de primeira ordem. Trata-se de ensinar aos modelos o que é socialmente aceitável ou inaceitável, como a regra "não roube". Esse tipo de treinamento responde à pergunta sobre o que é certo ou errado.
A pesquisa argumenta que a inteligência social depende de algo além do reconhecimento da norma. Ela exige antecipar quem vai fiscalizar a regra e de que forma, seja por vergonha pública, seja por prisão. Essas expectativas de segunda ordem são as metanormas, e elas governam como as pessoas reagem quando uma regra social é quebrada.
O estudo nasce justamente dessa lacuna. Enquanto o alinhamento de primeira ordem ensina o que não fazer, o alinhamento de segunda ordem testa se o modelo entende como o grupo responde à transgressão. É a diferença entre saber que roubar é errado e prever se a comunidade vai ignorar, repreender ou punir severamente quem roubou.
Por que importa
O achado tem consequência direta para sistemas de IA usados em áreas sensíveis a normas. O próprio artigo cita a mediação de conflitos e a simulação de políticas públicas como domínios em risco. Nesses campos, um modelo que exagera a punição pode produzir um retrato distorcido da regulação social.
A distorção tem duas faces descritas pelos autores. De um lado, a IA super-representa o castigo. De outro, sub-representa a tolerância, a contenção e a calibração relacional que caracterizam a aplicação real das normas no mundo. Em outras palavras, o modelo erra tanto ao prever punição demais quanto ao prever compreensão de menos.
O dado mais preocupante aparece na variável de proximidade social. O alinhamento com os julgamentos humanos piora conforme a distância social aumenta. Quanto mais distante o observador está de quem viola a norma, mais o modelo se afasta do que humanos de fato esperariam.
Impacto
A pesquisa mede o fenômeno em seis modelos, o que dá base comparativa ao resultado. O padrão se repete: os LLMs empurram a resposta social para o lado da sanção negativa, enquanto a anotação humana do NormReact aponta para inação em parte dos casos.
Para quem desenvolve produtos com LLMs, o impacto é prático. Um assistente que sugere respostas a conflitos internos de uma empresa, ou um simulador que modela reação pública a uma política, pode recomendar punição onde a leitura humana indicaria paciência. O NormReact, dataset com 450 cenários anotados por gênero do infrator e proximidade social dos observadores, expõe exatamente esse ponto de falha.
O estudo também sugere que o viés não é aleatório. Ele cresce com a distância social, o que significa que a IA tende a ser mais dura justamente com quem está fora do círculo próximo. Isso afeta desde moderação de conteúdo até sistemas de recomendação de decisões disciplinares.
O que muda
A contribuição metodológica é a mudança mais concreta. O artigo separa o problema em duas tarefas de classificação: autorregulação em quem viola e regulação em quem observa. Essa divisão permite medir o comportamento do modelo de forma mais fina do que uma avaliação genérica de alinhamento.
A segunda mudança é o eixo de análise. Avaliação emocional e resposta comportamental passam a ser dimensões distintas. Um modelo pode acertar a emoção esperada e errar a ação prevista, ou o contrário. O framework torna esse desencontro visível.
O dataset NormReact, liberado com 450 cenários, vira ferramenta pública para outros grupos testarem seus modelos. A anotação manual por gênero e proximidade social permite que pesquisadores isolem se o viés punitivo se concentra em grupos específicos.
O que vem agora
O artigo aponta uma direção para o trabalho de alinhamento. Se os LLMs atuais super-representam punição e sub-representam tolerância, o ajuste precisa mirar as metanormas, não apenas as normas de primeira ordem. O texto sugere que a calibração relacional, hoje ausente, é o que falta para aproximar a IA do julgamento humano.
Não há prazo divulgado para uma próxima etapa. O material disponível descreve o framework, as tarefas de classificação e o dataset, e indica os domínios que correm risco com o viés detectado: mediação de conflitos e simulação de políticas públicas. A correção desse retrato distorcido da regulação social fica como o próximo alvo dos esforços de alinhamento.
Fontes
- arXiv cs.AI, "Beyond Right and Wrong: Evaluating Second-order Social Reasoning in Large Language Models" (arXiv:2609.05437v1), submetido em 17 de julho de 2026. https://arxiv.org/abs/2609.05437