
FaithSieve usa Lean e GPT-5.4 para avaliar provas matemáticas com precisão de 84,5%
Framework do arXiv avalia provas informais com evidência formal e supera julgamento direto de modelos
O que aconteceu
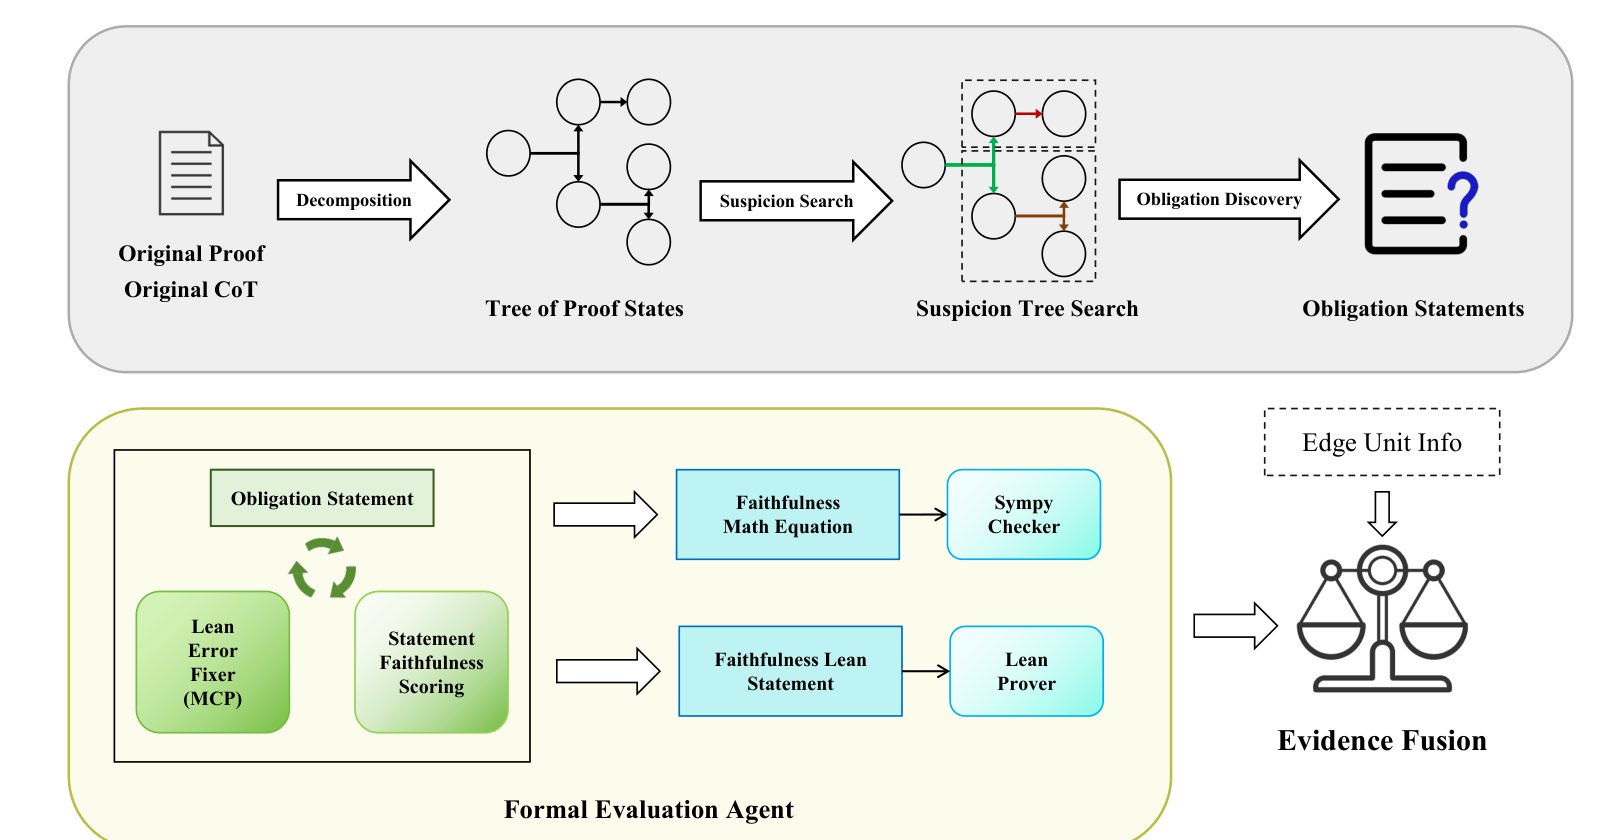
Um time de pesquisadores publicou no arXiv (arXiv:2608.26310) o artigo "FaithSieve: Fine-Grained Evaluation of Math Proofs with Faithful Formal Evidence", submetido em 26 de agosto de 2026. O framework FaithSieve usa o provador formal Lean para verificar provas matemáticas escritas em linguagem natural, decompondo passos grossos em unidades locais de raciocínio e extraindo obrigações de prova tipadas. Um agente de avaliação formal faz a verificação, mas a validação formal é controlada por um escore de alinhamento semântico, para que a evidência do Lean só seja incorporada quando a declaração formal preserva fielmente o contexto, os objetos e a forma lógica da afirmação original.
O sistema foi testado em dois conjuntos de dados validados por especialistas. No ProofLoc-Olympiad, com 350 problemas, o FaithSieve com backbone GPT-5.4 alcançou 81,43% de precisão exata na localização do primeiro erro, contra 72,29% do julgamento direto. No ProofLoc-University, com 200 problemas de seis domínios avançados, o FaithSieve atingiu 84,5% de precisão exata, superando os 75,0% do julgador direto.
Contexto
Modelos de linguagem de grande porte, ou LLMs, já geram provas matemáticas complexas e de múltiplos passos, mas verificar a correção dessas provas segue um desafio crítico. Métodos tradicionais de avaliação dependem de julgamentos em linguagem natural feitos por modelos, que frequentemente ignoram falhas locais no raciocínio. Provadores formais como o Lean oferecem verificação rigorosa, mas aplicá-los a texto informal exige resolver incompatibilidades de localidade e semântica: um provador pode contornar uma falha local ao provar um alvo amplo demais, ou validar uma afirmação auto-formalizada que se afasta da intenção matemática original.
O FaithSieve ataca esses dois problemas. Ele decompõe provas em unidades de raciocínio locais, extrai obrigações de prova tipadas e usa o escore de alinhamento semântico para filtrar casos em que a versão formal não representa fielmente a afirmação original.
Por que importa
A capacidade de localizar o primeiro erro lógico em uma prova tem impacto direto em áreas que dependem de raciocínio verificável, como matemática assistida por IA, verificação de software e sistemas de tutoria inteligente. Para estudantes e pesquisadores, isso significa que um modelo pode apontar exatamente onde uma cadeia de raciocínio quebra, em vez de apenas dizer que a prova está errada. O FaithSieve também reduz o risco de falsos positivos gerados por provadores formais, já que a evidência do Lean só entra quando há alinhamento semântico real.
Impacto
No curto prazo, o framework oferece um padrão mais confiável para avaliar a qualidade de raciocínio de LLMs em matemática. Os números do estudo mostram ganho consistente: 81,43% contra 72,29% no Olympiad, e 84,5% contra 75,0% no universitário. No médio prazo, a abordagem de decompor provas em unidades locais e ancorá-las com evidência formal pode ser adaptada para outros domínios de raciocínio estruturado, como lógica, ciência da computação teórica e até raciocínio jurídico. O ProofLoc-University cobre seis domínios avançados, o que sugere que a técnica generaliza para contextos além de olimpíadas.
O que muda
O FaithSieve muda o padrão de avaliação de provas geradas por IA. Em vez de confiar exclusivamente em julgamento textual de modelos, agora há um caminho para incorporar verificação formal, desde que a formalização seja fiel. Isso eleva a exigência sobre os modelos: eles precisam gerar provas que sobrevivam à decomposição em unidades locais e à verificação formal assistida por Lean. Para os desenvolvedores de LLMs, a métrica de precisão do primeiro erro se torna uma ferramenta útil para comparar modelos, já que o GPT-5.4 da OpenAI aparece como backbone no estudo.
O que vem agora
Os pesquisadores disponibilizaram os conjuntos de dados ProofLoc-Olympiad e ProofLoc-University, mas não anunciaram prazo para liberação pública do código do FaithSieve. Os próximos passos prováveis incluem expandir o framework para outros provadores formais, aumentar a escala dos benchmarks e testar backbones adicionais além do GPT-5.4. O artigo está disponível na página do arXiv e a comunidade de provadores formais e de avaliação de LLMs deve acompanhar os resultados.