
FlashDrive acelera inferência de modelos VLA para direção autônoma
Framework reduz latência de 717ms para 151ms em GPU única sem perda relevante de precisão
O que aconteceu
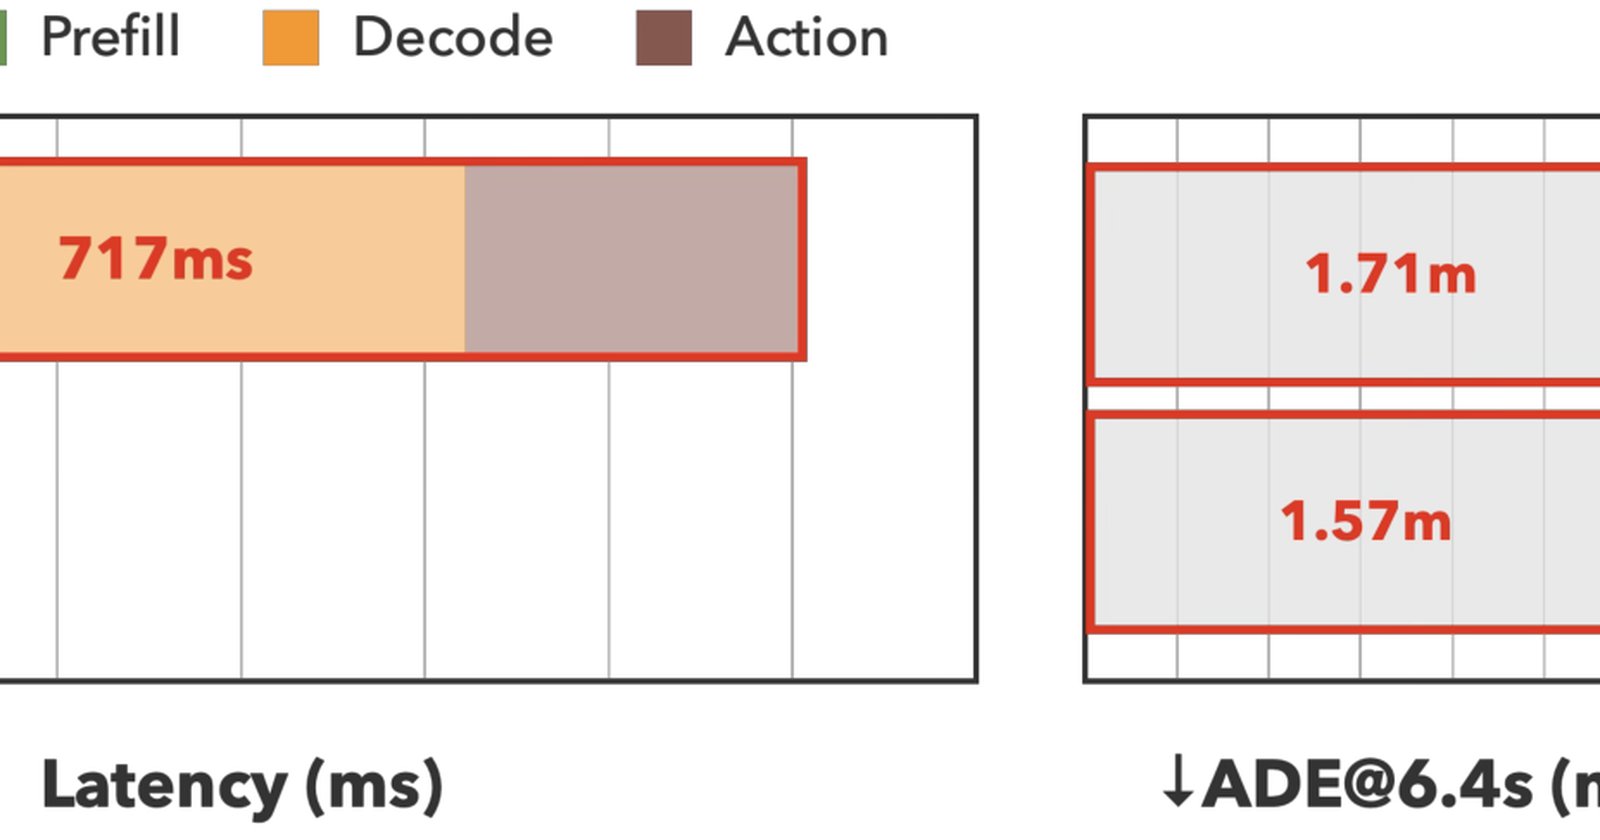
Pesquisadores publicaram no arXiv o FlashDrive, um framework de co-design entre algoritmo e sistema para acelerar a inferência de modelos Vision-Language-Action (VLA) em direção autônoma. O artigo (arXiv:2608.12932), submetido em 13 de agosto de 2026, descreve a aplicação da técnica ao modelo Alpamayo 1.5-10B com quantização W4A8: a latência de ponta a ponta caiu de 717ms para 151ms (4,7x), e a frequência de processamento subiu de 1,4 Hz para 6,6 Hz em uma única GPU. A precisão ficou praticamente intacta — o erro [email protected] variou apenas 0,08m, o minADE1 melhorou e as taxas de colisão e saída de pista melhoraram em simulação.
Contexto
Modelos VLA combinam percepção visual, linguagem e geração de ação para permitir raciocínio de ponta a ponta na direção autônoma. Na prática, porém, o custo computacional impede o controle em tempo real. O diagnóstico central do artigo é que a inferência VLA não tem um único gargalo, mas quatro em cascata: a codificação visual desperdiça computação em quadros de vídeo sobrepostos; o prefill do modelo de linguagem recomputa contexto que poderia ser reaproveitado do passo anterior; os tokens de raciocínio são gerados em série apesar da baixa entropia; e o denoising por flow-matching aplica computação uniforme a um campo de velocidade não uniforme. Atacar apenas uma dessas etapas deixa as demais intocadas.
Por que importa
A direção autônoma end-to-end depende de reagir ao ambiente em milissegundos. A 1,4 Hz, um modelo de raciocínio de 10 bilhões de parâmetros não sustenta o ritmo de decisões exigido pelo trânsito real. O FlashDrive mostra um caminho para operar esse tipo de modelo a 6,6 Hz em uma GPU — faixa compatível com controle em tempo real — sem sacrificar a qualidade das decisões. Para a indústria, isso reduz a dependência de clusters de alto custo e aproxima a viabilidade comercial de arquiteturas que integram percepção, linguagem e ação.
Impacto
As acelerações vêm de atalhos específicos para cada gargalo: reutilização de KV-cache em streaming entre quadros, um diffusion drafter não autorregressivo para speculative decoding baseado na baixa entropia do raciocínio de direção e cache adaptativo de passos no campo de velocidade — que é acentuado nas extremidades e plano no meio — concentrando computação onde importa. Por cima, entram compilação CUDA Graph e fusão de kernels. As técnicas são compostas, e a manutenção da acurácia indica que a aceleração não veio de um trade-off simples.
O que muda
O artigo trata a inferência como um problema de sistema, não como um gargalo isolado. Isso tem implicação direta para o desenho de futuros modelos VLA: otimizações de algoritmo e de sistema precisam ser co-projetadas desde o início, em vez de aplicadas depois. Para equipes que trabalham com direção autônoma, a abordagem oferece um caminho replicável para reduzir latência sem trocar a arquitetura do modelo.
O que vem agora
O trabalho é apresentado como resultado de simulação, e os autores não divulgam cronograma para testes em veículos reais. Os próximos passos esperados incluem validação em outros modelos VLA e em hardware diferente, além de avaliação em cenários de direção mais amplos. No Brasil, onde a adoção de veículos autônomos ainda depende de avanços regulatórios e de infraestrutura, a queda no custo computacional é um fator que pode tornar essas tecnologias viáveis localmente.
Fonte: arXiv (https://arxiv.org/abs/2608.12932)