
FlavourBench: novo benchmark de IA usa gastronomia para ranquear modelos de fronteira
Benchmark automatizado usa ground truth culinário executável para avaliar modelos de fronteira sem depender de juízes humanos.
O que aconteceu
Em 20 de agosto de 2026, o pesquisador Josef Liyanjun Chen submeteu ao arXiv o artigo "FlavourBench: Ranking Frontier Language Models with Executable Culinary Ground Truth", classificado na área de Inteligência Artificial (arXiv:2608.20574v1). O trabalho propõe um benchmark automatizado em que um sistema culinário versionado, chamado Epicure, fornece ground truth denso e executável. Em cada tarefa, o modelo recebe oito ingredientes e precisa montar um portfólio de três. Antes da execução do modelo, o Epicure pontua todas as 56 combinações possíveis de três ingredientes. Isso gera uma referência objetiva que não depende de um juiz humano nem de outro modelo.
Foram avaliados 27 endpoints de modelos de fronteira em um núcleo idêntico de 534 tarefas, divididas em substituição, pareamento e composição restrita. Segundo o abstract do paper, cada modelo ranqueado tem exatamente 89 respostas válidas por painel e família, totalizando 14.418 células modelo-tarefa. Essa padronização elimina a missingness diferencial, um problema comum em leaderboards nos quais alguns modelos não respondem a certas tarefas.
Contexto
A maioria dos benchmarks abertos de linguagem herda um juiz: um painel de preferência humana, outro modelo usado como avaliador ou uma chave de correspondência exata, que costuma ser frágil. O FlavourBench propõe uma alternativa com pontuação determinística e executável. O sistema Epicure, versionado, fornece mapas de pontuação congelados para cada tarefa, o que permite reconstruir qualquer resultado. Essa abordagem reduz o viés de subjetividade que afeta comparações entre modelos.
O FlavourBench foi apresentado como uma forma de resolver o problema da falta de ground truth confiável em avaliações de final aberto. Em vez de perguntar a um humano ou a outro modelo o que é uma boa resposta, o benchmark define previamente o valor de cada portfólio de ingredientes. Assim, a avaliação se torna reprodutível e auditável.
Por que importa
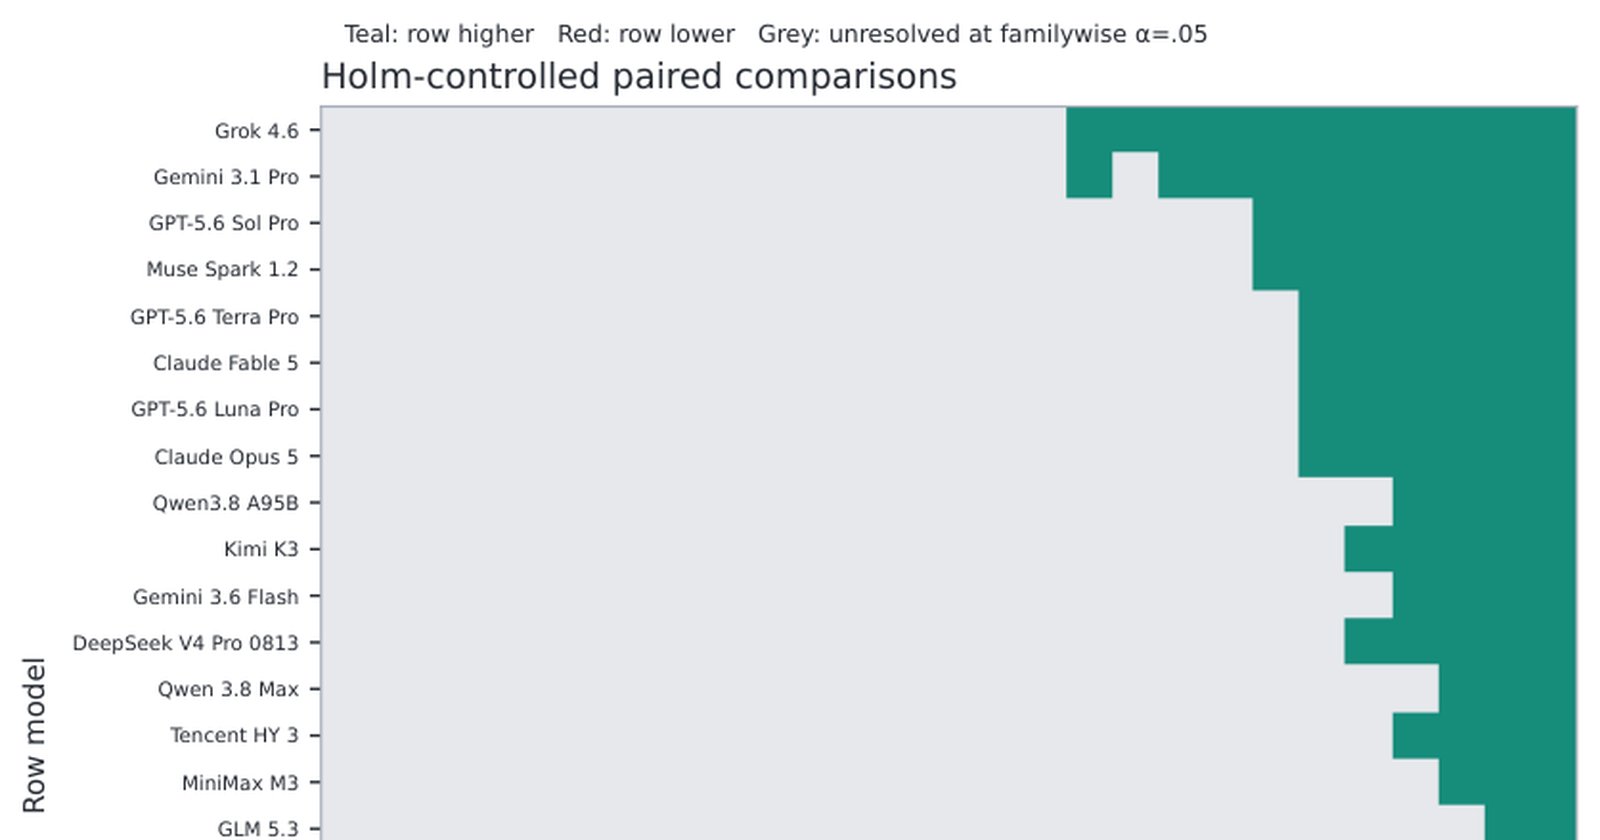
O FlavourBench Score é calculado como a média igual por família das pontuações congeladas das tarefas. Para garantir significância estatística, os autores usaram 50.000 réplicas bootstrap de cluster âncora para construir bandas simultâneas de 95% de confiança. Também realizaram 100.000 simulações de inversão de sinal para os 351 contrastes pareados entre modelos, com controle de Holm para múltiplas comparações. Os dois painéis de tarefas, compilados de forma independente, correlacionam em r = 0,89 (rho de classificação = 0,80), o que indica consistência interna do método.
Na prática, isso significa que o ranking produzido pelo FlavourBench é estatisticamente mais sólido do que a maioria das avaliações atuais, que costumam usar apenas médias simples sem controle de erro.
Impacto
O modelo Grok 4.6 obteve a maior estimativa pontual, com 65,1 pontos, dentro de um intervalo de confiança simultâneo de 95% entre 61,0 e 69,2. A pontuação de Grok 4.6, de 65,1, coloca o modelo à frente dos demais endpoints avaliados. Dos 351 pares de modelos comparados, 101 foram resolvidos com diferença estatisticamente significativa. Ou seja, mesmo com um método rigoroso, cerca de 71% das comparações entre pares não apresentaram diferença conclusiva. Isso sugere que muitos modelos de fronteira têm desempenho similar nas tarefas culinárias, e que o benchmark precisa de mais poder estatístico ou tarefas mais discriminativas.
O release completo do FlavourBench inclui prompts, mapas de pontuação de portfólio, respostas brutas, rotas exatas, hashes de conteúdo e um verificador offline que reconstrói cada resultado. Essa transparência permite que outros grupos repliquem a avaliação sem depender do sistema original.
O que muda
O FlavourBench, portanto, não é apenas um ranking. Ele estabelece uma infraestrutura verificável para avaliação de modelos de linguagem. A ausência de juízes humanos ou de modelos avaliadores elimina parte do ruído que afeta benchmarks como o Chatbot Arena ou o HELM. Para a comunidade brasileira de IA, isso representa uma alternativa concreta para comparar modelos de forma auditável, mesmo em domínios não técnicos como a gastronomia.
O que vem agora
O próximo passo esperado é a adoção do FlavourBench pela comunidade de pesquisa e a ampliação do conjunto de tarefas. O paper foi disponibilizado em 20 de agosto de 2026, e o verificador offline já permite que terceiros validem os resultados. Também é possível que os autores ampliem a base de modelos avaliados, incluindo versões mais recentes, e que outros domínios com ground truth executável, como química ou música, inspirem benchmarks semelhantes.