
Fortunate Recall reduz confabulação em memória de LLMs
Camada de política classifica fatos pessoais em ontologia de 10+1 tipos e atinge 76,9% no LifecycleBench
O que aconteceu
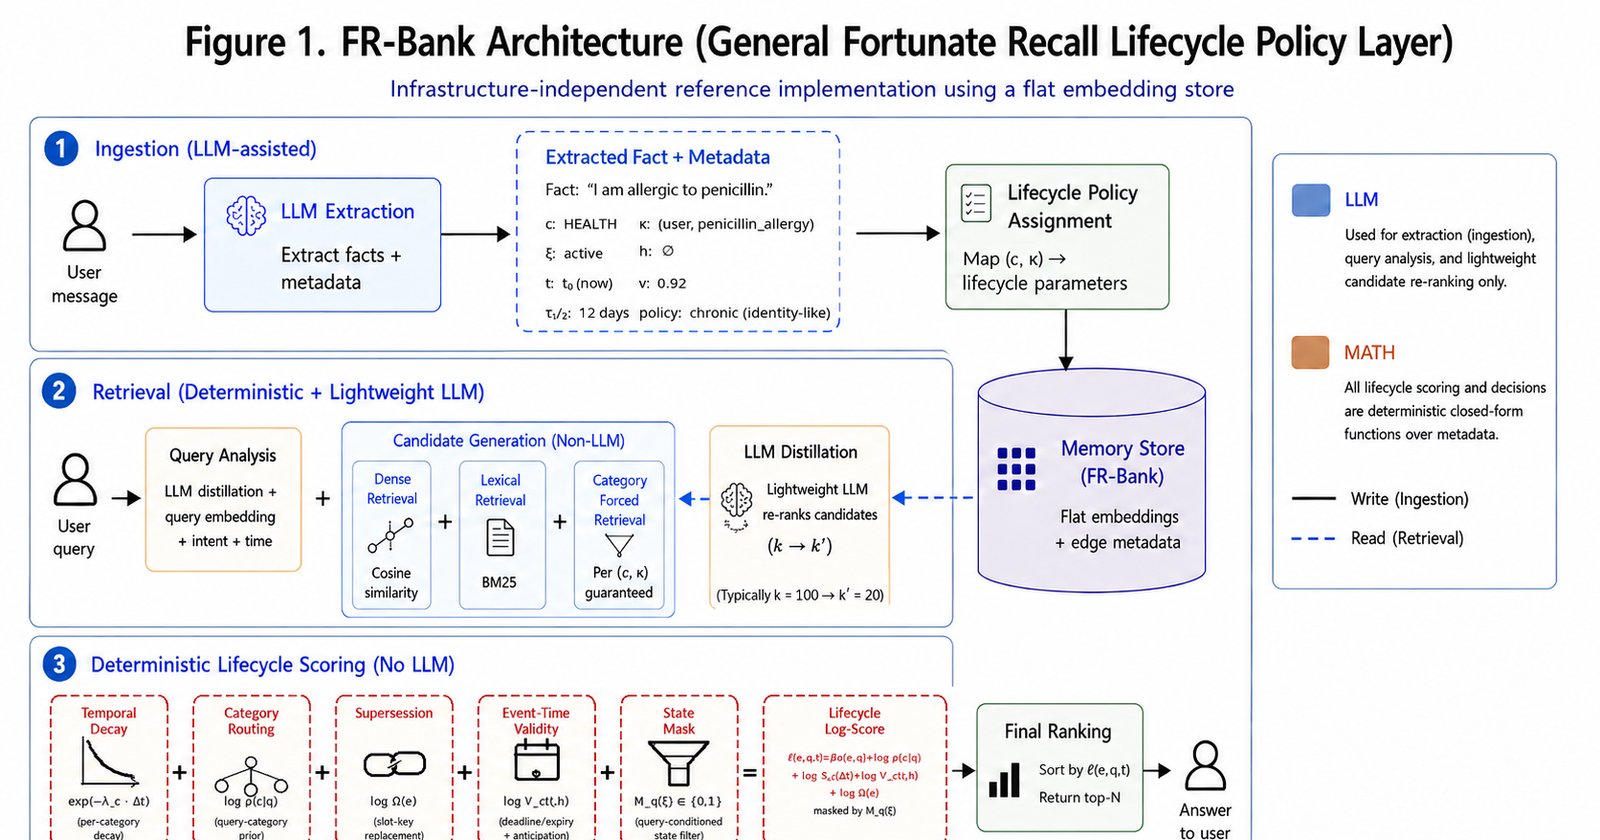
Um artigo depositado no arXiv em 9 de setembro de 2026 (arXiv:2609.10413v1, em Computer Science > Artificial Intelligence) apresenta o Fortunate Recall (FR), uma camada de política composável para memória de LLMs. O Fortunate Recall classifica fatos pessoais em uma ontologia comportamental de 10+1 tipos e aplica políticas de ciclo de vida específicas por categoria: decaimento temporal diferencial, supersessão por chave de slot, validade por tempo de evento e roteamento de recuperação sensível à categoria. Todas operam como funções determinísticas sobre metadados extraídos pelo próprio LLM.
O FR-Bank, implementação do Fortunate Recall independente de infraestrutura, alcançou 76,9% de acerto no LifecycleBench, benchmark novo de 516 questões dedicado a desambiguação temporal. O resultado coloca o FR-Bank à frente de Mem0, A-MEM, Memory-R1 e MemoryOS, sistemas que ficaram entre 61% e 70,5% no mesmo teste. No LongMemEval-S completo, sob o protocolo canônico do juiz de Wu et al., o FR-Bank marcou 75,2%.
Contexto
Sistemas de memória de LLM tratam hoje todos os fatos pessoais de forma idêntica. O efeito é conhecido: os repositórios crescem sem limite e a precisão de recuperação degrada conforme mais informação entra. O artigo define o problema central como gerenciamento de ciclo de vida, isto é, decidir quais memórias devem persistir, quais devem ser substituídas e em que ritmo, condicionado ao tipo comportamental de cada fato.
O Fortunate Recall rompe com a lógica de armazenamento homogêneo. Em vez de aplicar uma única regra de expiração a tudo, a camada separa os fatos por comportamento e trata cada grupo de forma distinta. O desempenho de 75,2% no LongMemEval-S, benchmark consolidado de memória de longo prazo, indica que as políticas de ciclo de vida não impõem custo mensurável à recuperação padrão. O ganho vem sem sacrificar o que os sistemas já faziam bem.
Por que importa
O número que mais pesa é a confabulação, quando o modelo inventa informação que não está na memória. O FR-Bank corta esse índice dos 45,1% do Mem0 para 22,4% nas consultas efetivamente respondidas, e dos 32,2% para 13,0% no conjunto de todas as consultas. Ao mesmo tempo, responde mais corretamente: 31,2% contra 18,6% do Mem0. O sistema acerta mais e inventa menos, combinação que costuma ser difícil de obter ao mesmo tempo.
Para quem constrói assistentes pessoais, agentes com histórico de usuário ou aplicações de atendimento com memória persistente, isso muda a conta. Memória maior deixou de ser sinônimo de memória melhor. A pergunta que o artigo coloca na mesa é qual fato merece sobreviver no banco e por quanto tempo.
Impacto
Uma ablação pré-registrada localiza de onde vêm os ganhos. Ao substituir a camada tipada por três primitivas genéricas de ciclo de vida, a correção fica estatisticamente igual (-1,7 ponto percentual, intervalo de confiança de 95% entre -6,0 e +2,7). Ou seja, os metadados genéricos de ciclo de vida carregam a vantagem de acerto, enquanto a ontologia comportamental carrega a calibração, cortando pela metade a confabulação downstream (12,0% contra 24,2%, p<0,001).
A decomposição se transfere para o BEAM, benchmark construído de forma independente: 46,8% de acerto contra 32,9% do Mem0 em 280 questões. Nesse teste, o benefício da ontologia se concentra na resolução de contradições e satura perto de sete agrupamentos de política. O ranking se replica no Kimi K2.5, modelo de pesos abertos, o que indica que o efeito não depende de um LLM fechado específico.
O que muda
Os autores liberaram a ontologia, o benchmark e o código. O LifecycleBench, com suas 516 questões de desambiguação temporal, passa a ser uma referência pública para comparar sistemas de memória, ao lado do LongMemEval-S e do BEAM. A ablação pré-registrada também eleva o padrão de evidência da área, ao separar o que cada componente do sistema contribui para acerto e para calibração.
O que vem agora
O artigo não anuncia cronograma de produto nem plano comercial. Os próximos passos dependem da comunidade que adotar os artefatos liberados: replicação em outros modelos, ampliação da ontologia de 10+1 tipos e testes em bases de memória de produção. A saturação perto de sete agrupamentos de política indica que adicionar categorias novas tende a trazer retorno decrescente. O caminho mais provável é a integração das políticas de ciclo de vida a sistemas de memória já em uso, como Mem0, que aparece no estudo como a linha de base a ser batida.
FONTES
- arXiv cs.AI: Fortunate Recall: Ontology-Driven Memory Lifecycle Management for Persistent Coherence in LLMs (arXiv:2609.10413v1) — https://arxiv.org/abs/2609.10413