
Framework usa percepção ativa para robôs desambiguarem tarefas sem pedir ajuda
Pesquisa publicada no arXiv propõe que robôs mudem sua observação física antes de pedir esclarecimento humano
O que aconteceu
Pesquisadores publicaram no arXiv (11/08/2026) um framework chamado "Active Perception for Embodied Disambiguation". O sistema propõe resolver um problema comum em robótica: quando um robô não consegue identificar qual objeto o usuário está se referindo, ele tende a pedir esclarecimento imediatamente.
O novo framework inverte essa lógica. Antes de perguntar ao usuário, o robô usa observação ativa — mudando posição, ângulo ou zoom — para tentar recuperar evidências visuais que estejam ausentes por causa de obstruções, ângulos limitados, textos ilegíveis ou alvos fora do campo de visão.
Um modelo de visão e linguagem (VLM) analisa as evidências acumuladas e decide se deve continuar observando, solicitar esclarecimento ou confirmar a seleção do alvo.
Contexto
A ambiguidade de alvos em ambientes corporificados não vem apenas da intenção do usuário. Ela também surge quando o robô simplesmente não enxerga o objeto correto. Métodos interativos existentes resolvem isso basicamente perguntando à pessoa qual objeto pretende.
Porém, há situações onde perguntar não é suficiente ou eficiente: o objeto pode estar atrás de outro, a etiqueta pode estar ilegível, ou o robô pode estar de costas para o item correto. O framework proposto incorpora esses cenários ao processo de desambiguação.
Por que importa
Para robôs domésticos, de logística ou de assistência, a capacidade de "pensar antes de perguntar" melhora a experiência do usuário. Em vez de ouvir três vezes "qual objeto?", o robô pode se reposicionar e resolver a tarefa com menos interrupções.
Isso também tem implicações para situações onde o usuário não está disponível ou tem dificuldade de comunicação, como idosos ou pessoas com deficiência.
Impacto
O framework mostra uma direção concreta para robótica cognitiva: integrar percepção ativa e linguagem natural em um único processo decisório. Se validado em escala, pode reduzir significativamente o número de perguntas que robôs fazem aos usuários em ambientes reais.
A abordagem também pode acelerar a adoção de robôs em contextos onde a precisão de identificação de objetos é crítica, como hospitais, depósitos ou residências com muitos itens similares.
O que muda
A distinção principal entre este framework e abordagens anteriores é a autonomia do robô na aquisição de informação. Em vez de depender exclusivamente de interação humana, o sistema combina duas fontes de dados: observação física e esclarecimento verbal.
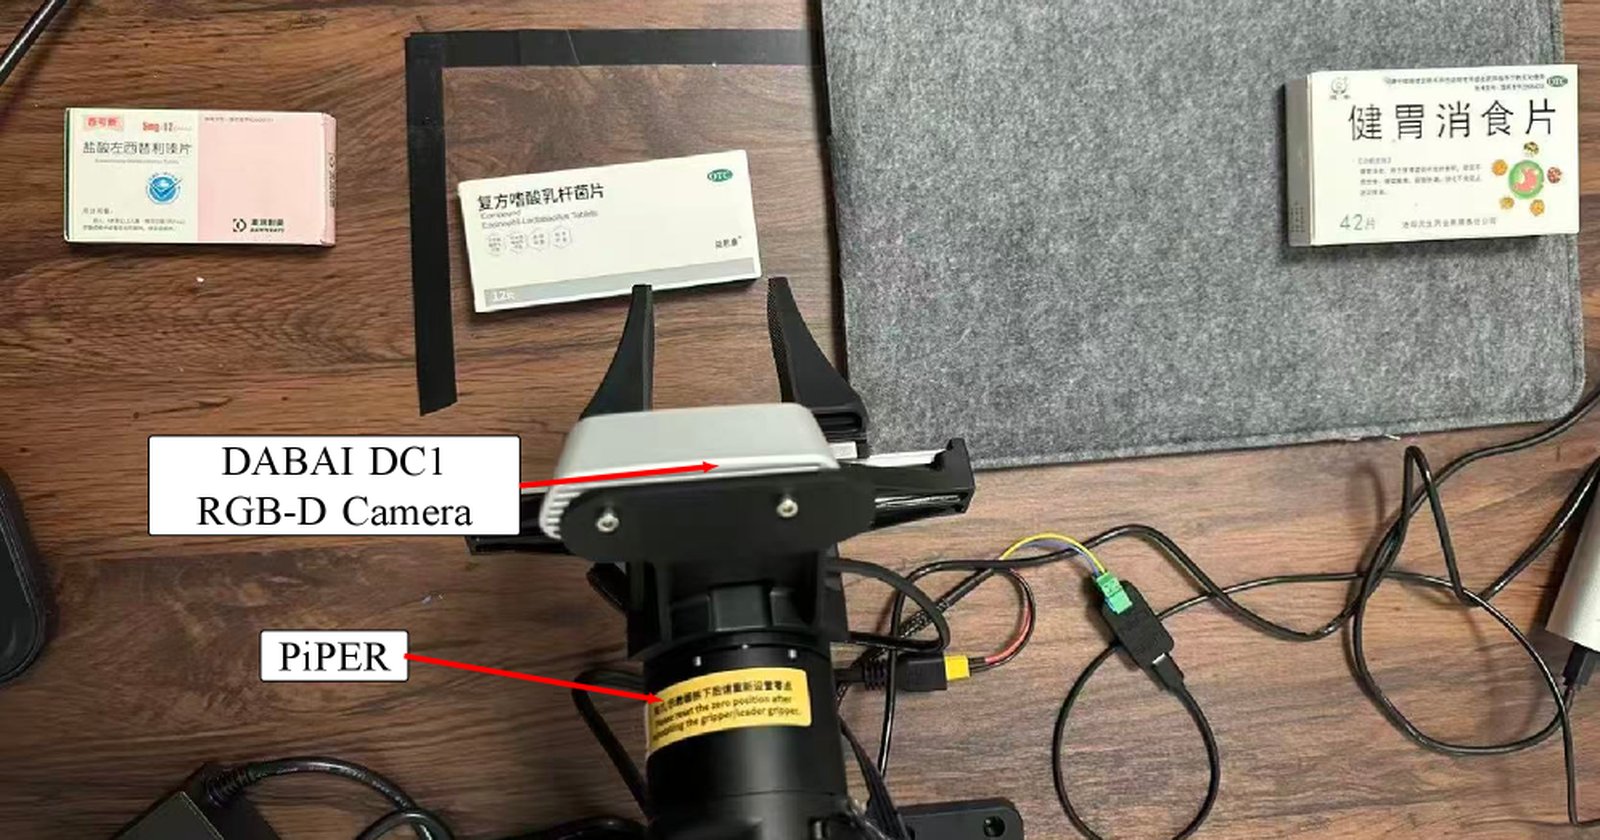
Experimentos com robôs reais demonstraram que essa combinação funciona em um processo unificado de desambiguação, sem necessidade de trocar entre módulos separados.
O que vem agora
O paper está disponível no arXiv como pré-print desde agosto de 2026, na área Computer Science > Artificial Intelligence. Os autores não especificaram prazos para revisão por pares ou implementação em produtos comerciais.
O código e os dados dos experimentos não foram disponibilizados publicamente até o momento da publicação desta matéria.