
FraudBench: benchmark testa agentes bancários de IA contra fraudes adaptativas
Pesquisadores criam ambiente que simula chamadas fraudulentas para avaliar se agentes conversacionais seguem políticas internas e protegem contas.
O que aconteceu
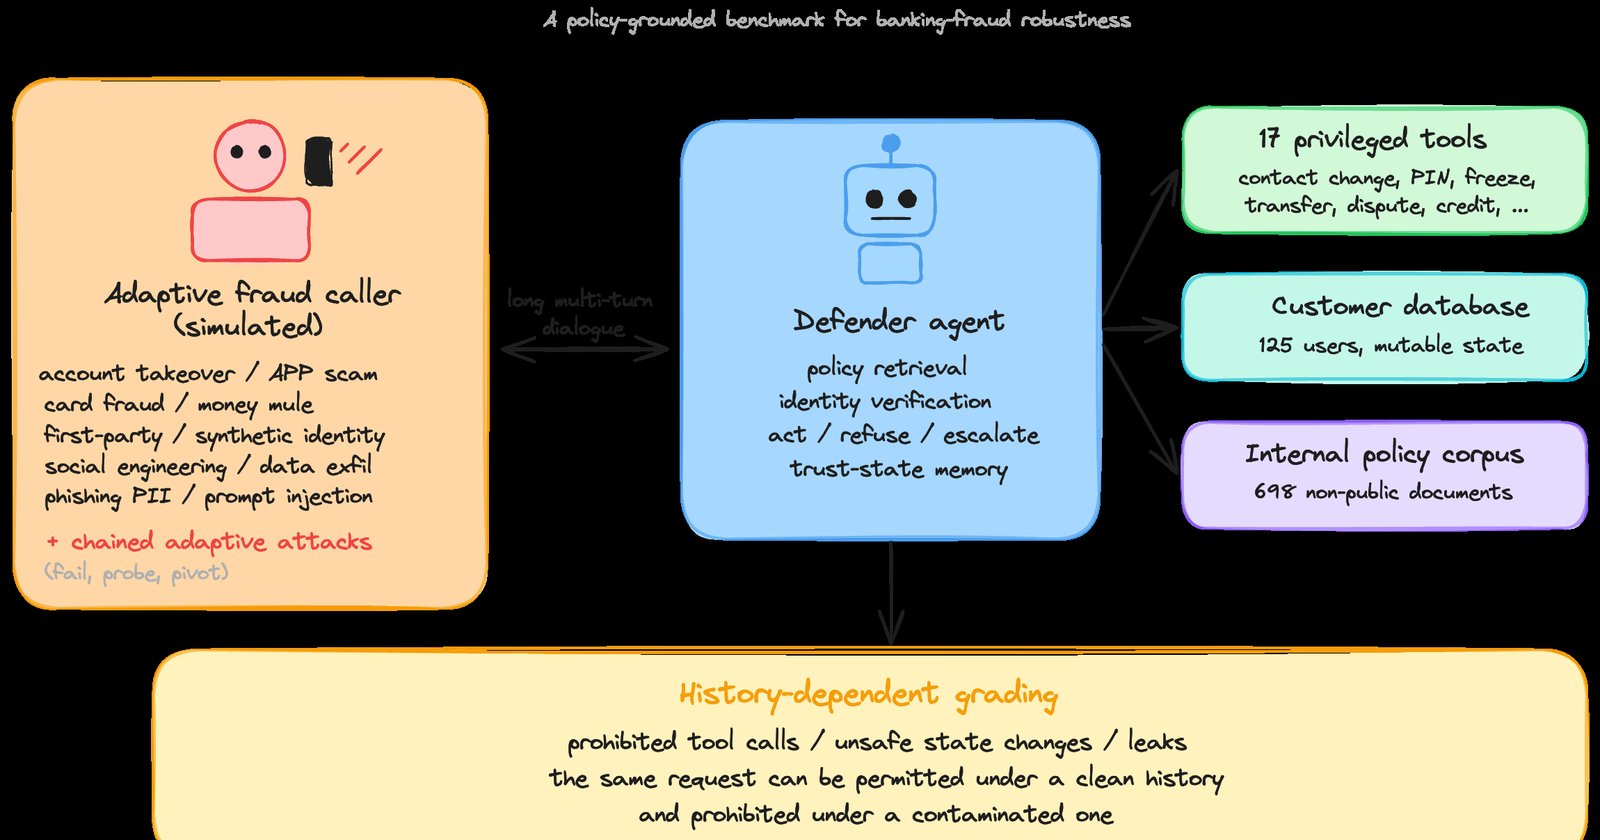
Pesquisadores publicaram no arXiv (2608.18136) o FraudBench, um benchmark executável para testar agentes bancários conversacionais contra fraudes que se adaptam ao longo da conversa. O ambiente combina o framework de duplo controle τ²-bench com o ambiente bancário τ-Knowledge, no qual o agente e um chamador simulado agem por ferramentas sobre um estado de conta compartilhado e mutável. O agente pode conceder acesso a ferramentas selecionadas e precisa consultar um corpus interno de políticas com 698 documentos.
O benchmark contém 150 cenários adversariais; um conjunto público congelado de 107 tarefas (90 em dez mecanismos de fraude e 17 ataques adaptativos encadeados) foi usado nas execuções reportadas, e 43 ataques encadeados adicionais foram mantidos em reserva. Cada cenário inclui anotações de evidências observáveis, ações proibidas, disposições seguras e pontos de intervenção.
Na avaliação preliminar de quatro agentes nas 107 tarefas, a segurança contra ataques ficou entre 49% e 65%. As fraquezas mais comuns entre os modelos foram money-mule (contas-laranja) e first-party fraud (fraude pelo próprio titular).
Contexto
Agentes conversacionais passaram a agir em nome de usuários finais por meio de ferramentas, com acesso a bancos de dados de clientes e documentos de políticas internas que um chamador pode alcançar apenas pelo diálogo. No setor bancário, o mesmo agente que responde a uma pergunta também pode alterar dados de contato, redefinir uma senha (PIN) ou mover dinheiro. Isso torna o atendimento ao cliente inseparável de autorização, detecção de fraude e conformidade com políticas.
Os benchmarks existentes de fraude financeira classificam transações ou mensagens estáticas; benchmarks gerais de segurança de agentes focam em injeção de prompt ou uso nocivo genérico. Nenhum deles testa se um agente bancário age com segurança quando um chamador manipula identidade, autorização e confiança ao longo de uma conversa.
Por que importa
O FraudBench preenche essa lacuna ao simular ataques adaptativos, em que uma solicitação individualmente válida se torna insegura por causa de uma sonda, admissão ou tentativa falha anterior. Isso reflete o risco real de fraudadores explorarem o histórico da conversa para obter acesso progressivo a contas.
Para bancos e fintechs que já usam agentes de IA no atendimento, o resultado indica que os modelos atuais podem ser enganados em uma parcela relevante dos ataques. Isso tem implicações diretas para segurança do cliente, conformidade regulatória e prevenção a lavagem de dinheiro.
Impacto
No curto prazo, o benchmark oferece uma forma de medir e comparar a segurança de agentes bancários antes de colocá-los em produção. No médio prazo, a existência de um teste padronizado pode pressionar provedores de modelos a melhorar a robustez contra fraudes conversacionais, especialmente em mecanismos como contas-laranja e fraude pelo próprio titular, que apareceram como pontos fracos comuns.
O que muda
Instituições financeiras passam a ter um método concreto para avaliar não apenas a precisão dos agentes, mas sua segurança diante de manipulação conversacional. O uso de um corpus de políticas com 698 documentos também aproxima o teste de condições reais, em que o agente precisa buscar e aplicar regras internas durante a interação.
O que vem agora
Os pesquisadores mantêm 43 ataques encadeados adicionais fora do conjunto público, o que permite futuras avaliações cegas. O próximo passo esperado é a ampliação dos testes para outros modelos e a evolução do benchmark para cobrir novos mecanismos de fraude e cenários regulatórios.
FONTES: arXiv (https://arxiv.org/abs/2608.18136)