
Benchmark revela falhas no grounding visual interativo de LVLMs
Pesquisa submetida em agosto de 2026 mostra que modelos de visão-linguagem perdem para humanos em quatro contextos e quatro protocolos.
O que aconteceu
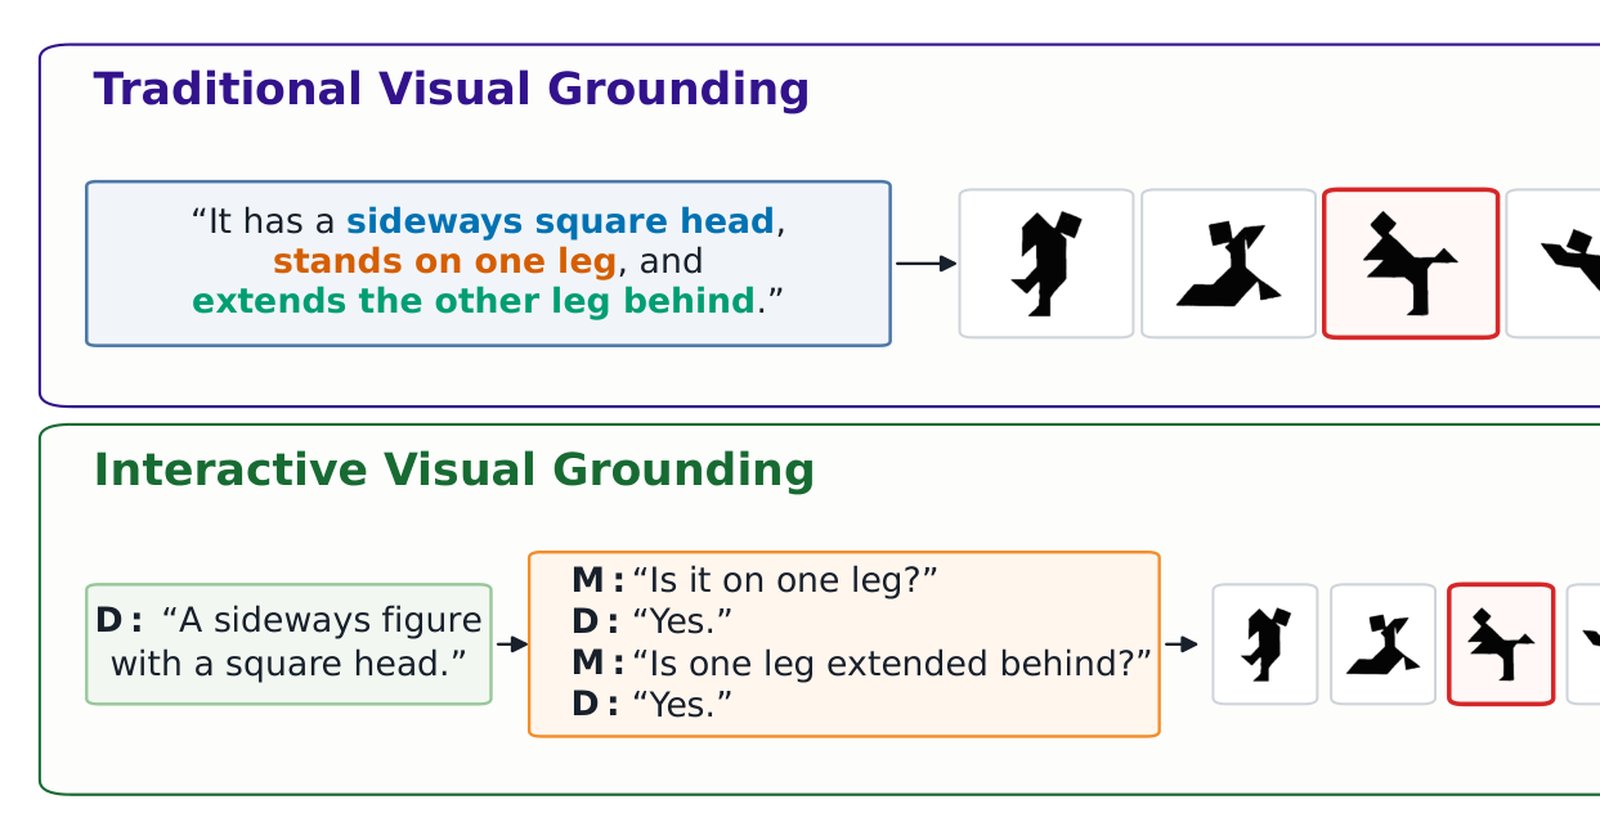
O artigo "When Seeing Is Not Enough: Benchmarking Interactive Visual Grounding in LVLMs" foi submetido ao arXiv em 25 de agosto de 2026, sob o identificador arXiv:2608.23978v1. Os pesquisadores introduziram um framework controlado para avaliar o grounding visual interativo, variando quanta informação sobre o alvo é fornecida de antemão e quanta precisa ser adquirida por meio de diálogo. O estudo testou os modelos em quatro contextos visuais fundamentados em humanos e quatro protocolos de interação.
Os resultados indicam que os LVLMs atuais performam significativamente abaixo das linhas de base humanas no nível de tarefa. A interação pode ajudar quando perguntas de acompanhamento refinam ou reparam uma descrição inicial do alvo. Porém, o desempenho é mais baixo quando nenhuma descrição inicial é fornecida e a informação precisa ser obtida por perguntas, apontando que o grounding orientado por perguntas proativas continua difícil.
Além disso, os LVLMs são mal calibrados, frequentemente reportando confiança que excede sua precisão empírica. Estudos de acompanhamento confirmam esses padrões em diferentes fontes de descrição (humanas versus IA), esforços de raciocínio, interações repetidas, provedores de descrição e contextos visuais.
Contexto
O grounding visual tradicionalmente é avaliado como um mapeamento de uma única expressão de referência informativa para um alvo visual. Essa formulação ignora uma propriedade central da referência no mundo real: a informação sobre o alvo costuma ser incompleta, ambígua e estabelecida por meio de interação. O novo benchmark busca preencher essa lacuna, medindo não apenas o reconhecimento visual, mas a capacidade de buscar e sintetizar informações ao longo de um diálogo.
Esse movimento reflete esforços recentes da área para avaliar habilidades mais próximas do uso prático, em vez de tarefas isoladas. O estudo também investiga como a origem da descrição (humana ou gerada por IA) afeta o desempenho, um fator relevante para aplicações reais.
Por que importa
Para assistentes de IA, robôs e sistemas de acessibilidade, a capacidade de interagir sobre referências visuais é essencial. Um usuário pode apontar para um objeto sem dar uma descrição completa, e o modelo precisa fazer perguntas para entender o que está sendo solicitado. O estudo mostra que os LVLMs atuais não conseguem fazer isso de forma confiável, o que limita o uso em cenários do mundo real.
Os números e contextos do estudo fornecem uma base concreta para cobrar melhorias. Se um modelo reporta confiança alta mas erra com frequência, isso é um risco em aplicações críticas, como navegação autônoma ou suporte a pessoas com deficiência visual, onde um erro de interpretação pode ter consequências graves.
Impacto
O impacto é duplo. Primeiro, o benchmark expõe uma deficiência estrutural dos LVLMs: a dificuldade em adquirir informação proativamente por perguntas. Isso indica que os modelos dependem de descrições iniciais relativamente informativas, o que não é realista em muitas situações.
Segundo, a má calibração da confiança é um problema para a confiabilidade do sistema. Se o modelo não sabe quando não sabe, o mecanismo de fallback humano ou de outro sistema não é acionado corretamente. Isso afeta a adoção em ambientes regulados, onde a transparência e a previsibilidade são obrigatórias.
Além disso, a consistência dos resultados em diferentes fontes de descrição e contextos sugere que o problema não é pontual, mas generalizado. Isso pressiona a comunidade a repensar as métricas de avaliação atuais, que podem superestimar a capacidade real dos modelos.
O que muda
O estudo propõe que o grounding visual interativo seja considerado um desafio à parte, exigindo habilidades de correspondência visual, busca de informação e síntese. Isso pode influenciar o desenvolvimento de novos benchmarks e a criação de conjuntos de treinamento que incluam interações dialógicas.
Também abre espaço para investigar métodos que melhorem a calibração e a capacidade de fazer perguntas. Ainda não há um direcionamento claro de como implementar isso, mas o estudo oferece uma base métrica para medir progresso.
O que vem agora
Os autores indicam que estudos de acompanhamento já confirmaram os padrões em variações de descrição, raciocínio e interações repetidas. O próximo passo natural é usar o framework para avaliar novos modelos e técnicas, comparando resultados ao longo do tempo.
A publicação no arXiv, em 25 de agosto de 2026, está disponível para acesso da comunidade. Espera-se que outros grupos adotem o benchmark ou desenvolvam variações, contribuindo para um retrato mais realista da capacidade interativa dos LVLMs.