
Harbor Adapters e Harbor-Index: infraestrutura aberta para avaliar agentes de IA
Novo trabalho publicado no arXiv padroniza mais de 80 benchmarks de agentes e lança um meta-dataset curado de 82 tarefas
O que aconteceu
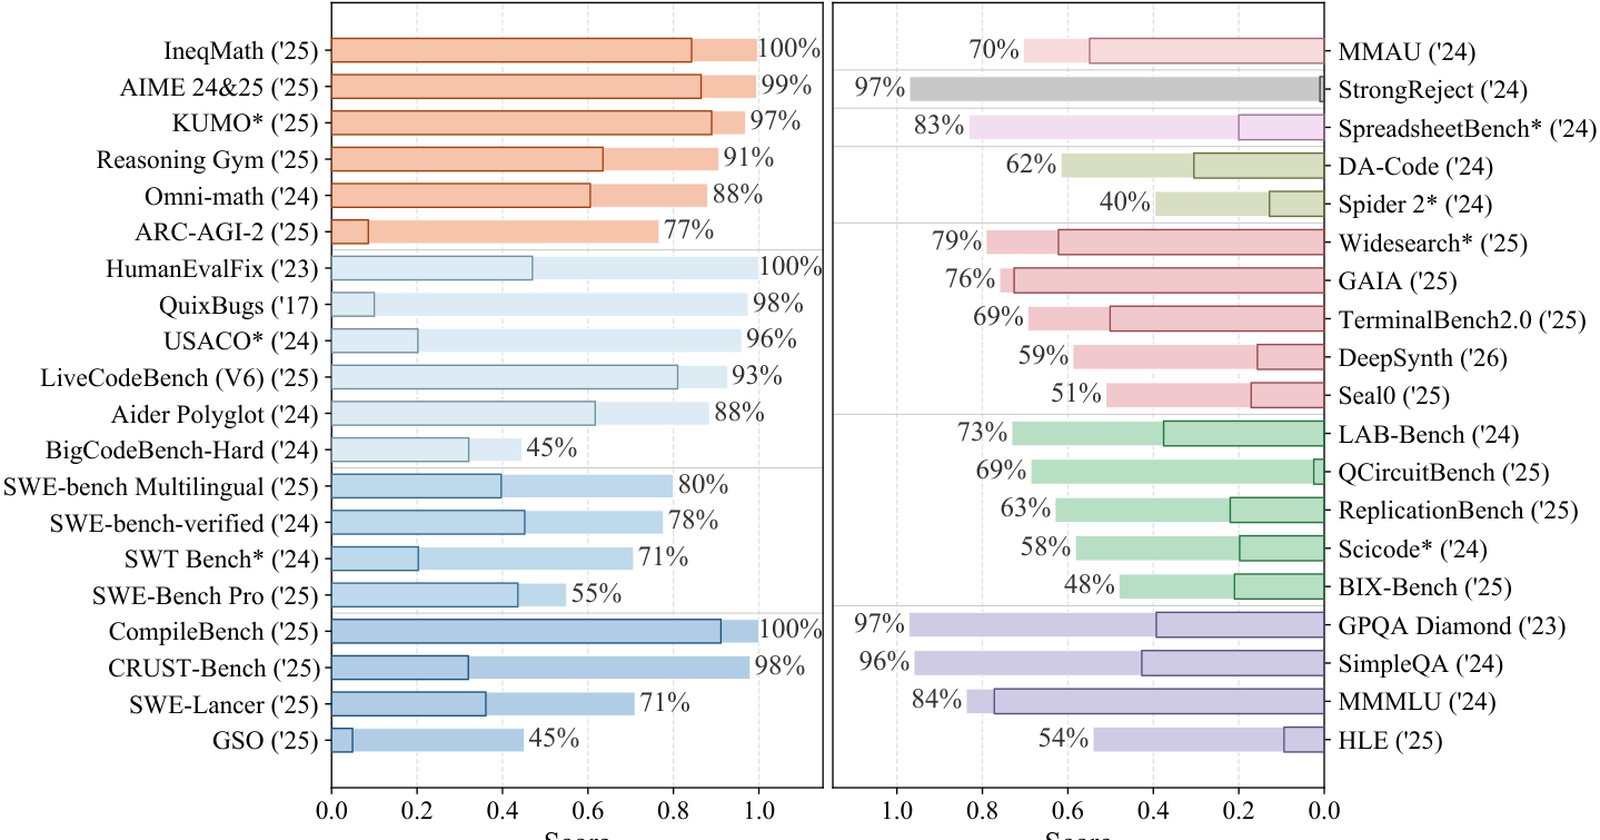
O Harbor Adapters é uma infraestrutura unificada de avaliação de benchmarks agênticos apresentada no artigo "Harbor Adapters and Harbor-Index: Infrastructure and a Curated Meta-Dataset for Large-Scale Agentic Evaluation", submetido ao arXiv em 3 de setembro de 2026 (arXiv:2609.04298). O Harbor-Index, por sua vez, é um meta-dataset curado derivado dessa infraestrutura, com 82 tarefas difíceis extraídas de 29 benchmarks.
O trabalho se sustenta em três contribuições. A primeira são os adapters de benchmark: mais de 80 benchmarks foram portados para avaliar agentes arbitrários, com validação por revisão rigorosa de código e experimentos de paridade. A segunda é uma avaliação em larga escala: 8 modelos, abrangendo diferentes níveis de capacidade, rodaram em 54 benchmarks, cada um executado com o Terminus-2 e com um de 3 harnesses nativos. A terceira contribuição é o próprio Harbor-Index, refinado a partir do conjunto adaptado por filtragem de dificuldade, auditoria por IA e por humanos, e um ciclo de auditoria e correção.
O número que resume o estado da arte: nenhuma combinação de modelo e harness avaliada ultrapassou 30% de taxa de aprovação no Harbor-Index. A configuração mais forte, o GPT-5.5 com Codex, alcançou 28,0%.
Contexto
Avaliar agentes de IA em benchmarks agênticos sempre foi um problema prático. Cada benchmark costuma exigir ambientes complexos e integrações específicas de agente, o que torna comparações entre modelos caras e fragmentadas. Um laboratório que quisesse testar seu modelo em dezenas de benchmarks precisaria construir integrações separadas para cada um.
Os adapters do Harbor atacam exatamente esse gargalo. Ao portar mais de 80 benchmarks para uma infraestrutura única, o projeto permite que qualquer agente seja avaliado de forma consistente em todo o conjunto. A validação por code review e experimentos de paridade existe para garantir que o port não distorça os resultados originais de cada benchmark.
O Harbor-Index nasce como resposta a outro problema: rodar a suíte completa é caro. O meta-dataset preserva o desafio e a amplitude das avaliações em larga escala, mas a um custo acessível, segundo os autores.
Por que importa
O dado mais revelador do trabalho é o teto de desempenho. O GPT-5.5 com Codex, a configuração mais forte entre as avaliadas, atinge 28,0% no Harbor-Index. Isso significa que as tarefas mais difíceis e bem auditadas ainda derrubam os melhores modelos disponíveis, com mais de 70% de falha.
Para quem desenvolve agentes, o Harbor Adapters reduz drasticamente o custo de comparar sistemas. Em vez de integrar cada benchmark separadamente, é possível rodar a mesma bateria em qualquer agente. Para quem consome benchmarks em comunicados de imprensa, o Harbor-Index oferece um contraponto: um conjunto curado, auditado por humanos e por IA, em que os números são difíceis de inflar.
Impacto
No curto prazo, a liberação em código aberto dos adapters, dos resultados de avaliação e da análise detalhada deve facilitar que grupos acadêmicos e laboratórios menores repliquem avaliações antes restritas a quem tinha infraestrutura própria. A análise dos modos de falha, viabilizada pela avaliação de 8 modelos em 54 benchmarks, dá material concreto para orientar o desenvolvimento de agentes.
No médio prazo, um benchmark curado em que o estado da arte fica em 28% tende a se tornar referência de dificuldade. Se as taxas subirem rápido, o Harbor-Index funcionará como termômetro do progresso real dos agentes, além do ruído dos benchmarks saturados.
O que muda
A mudança central é metodológica. A avaliação de agentes deixa de depender de integrações ad hoc por benchmark e passa a contar com uma camada comum, validada, que roda modelos com o Terminus-2 e com harnesses nativos. O Harbor-Index, da mesma iniciativa, mostra que é possível manter rigor e diversidade sem o custo de uma suíte gigante.
O que vem agora
Os autores liberaram os adapters, os resultados das avaliações, a análise em profundidade e o Harbor-Index como artefatos open-source. O próximo capítulo depende da comunidade: novos modelos serão medidos contra o teto de 28,0% estabelecido pelo GPT-5.5 com Codex, e o ciclo de auditoria e correção do índice deve continuar refinando as 82 tarefas conforme os agentes evoluem.