
IA em licitações: XML nas instruções derruba qualidade de 74% para 48%
Pesquisa avalia sistema real contra propostas humanas e revela assimetria entre leitura e escrita
O que aconteceu
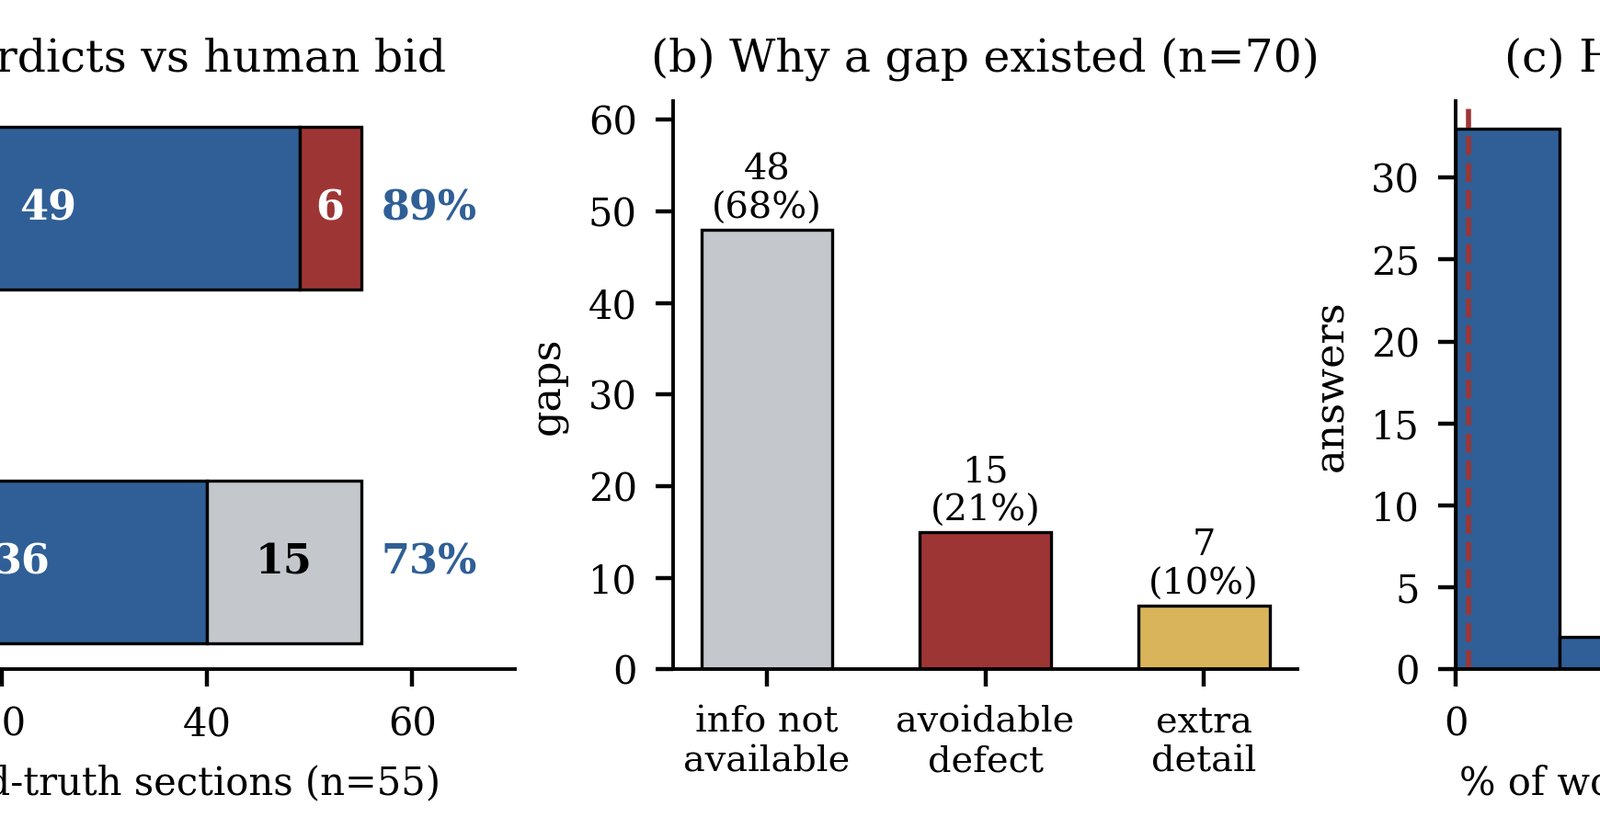
O estudo "Structure for Reading, Prose for Writing: Asymmetric Structural Conditioning in Multi-Agent Document Authoring" foi submetido ao arXiv em 21 de agosto de 2026 (arXiv:2608.20786v1). A pesquisa reporta um sistema de resposta a licitações em produção, que roda um modelo de pesos abertos sob restrições de soberania. Em uma comparação cega contra propostas escritas por humanos da mesma organização, um juiz LLM considerou as respostas da IA pelo menos tão boas quanto as humanas em 40 das 55 seções, melhores em 4, sem nenhuma lacuna de resposta, e sinalizou apenas uma alegação sem suporte.
A análise das lacunas identificadas mostra que 68% delas eram conteúdo ausente das fontes do próprio sistema. Isso aponta que o problema não era a qualidade da escrita, mas sim a disponibilidade da informação. A pesquisa classifica os 15 veredictos adversos: apenas 6 envolvem uma deficiência que o sistema poderia ter evitado.
Contexto
A premissa do artigo é sólida: renderizar documentos como markup estruturado melhora a extração. Essa premissa foi reproduzida em três tarefas de leitura. O problema surge na condição de escrita. Quando a equipe converteu o material de instrução de uma proposta de prosa para XML aninhado, a qualidade da resposta caiu drasticamente de 74% para 48% em uma comparação pareada. A estruturação, que ajuda o modelo a ler, atrapalha quando ele precisa escrever.
Nomear explicitamente uma construção proibida no prompt também se mostrou contraproducente. Dos defeitos sobreviventes, 96% estavam concentrados exatamente nas duas formas que o prompt mencionava. A instrução de evitação cria um viés de atenção no modelo, que passa a produzir justamente o erro que deveria evitar.
Por que importa
Para empresas que automatizam respostas a editais no Brasil, o resultado é um alerta direto sobre arquitetura de pipeline. O estudo demonstra que a divergência da verdade básica é muitas vezes um resultado de indisponibilidade de informação, e não de qualidade de escrita. A distinção é crucial em mercados regulados. A conclusão dos autores é clara: estrutura pertence à leitura; prosa e testes autoaplicáveis pertencem à escrita.
A pesquisa também expõe um erro comum em avaliações de sistemas de IA. Se o benchmark não separa a falta de conhecimento da falta de habilidade de escrita, ele subestima o sistema. No caso analisado, apenas 6 das 15 avaliações negativas representavam um erro que a pipeline poderia ter corrigido.
Impacto
O impacto prático se manifesta em duas frentes. Na primeira, engenheiros de IA precisam rever a prática de forçar XML em prompts de instrução para tarefas generativas, pois a qualidade do texto despenca. Na segunda, o estudo mostra que acoplar uma anotação estocástica a uma função de janelamento determinística reduz a contagem de requisitos extraídos de 68 para 51 em um arquivo byte-idêntico. Na prática, isso significa que tentar padronizar demais o processo de extração pode fazer a IA perder detalhes críticos do edital.
Para o Brasil, onde a Lei 14.133 regula as licitações, um requisito mal identificado pode eliminar uma proposta inteira. O sistema avaliado, rodando com modelo de pesos abertos e restrições de soberania, é um exemplo direto de arquitetura que empresas públicas e estatais buscam adotar para atender à LGPD e evitar dependência de API estrangeira.
O que vem agora
O arXiv:2608.20786 aponta para um novo princípio de design para pipelines multiagente: o condicionamento estrutural assimétrico. A expectativa é que novas pesquisas explorem como aplicar testes autoaplicáveis durante a geração de texto, e não apenas na etapa de leitura. O estudo sugere que a abordagem de janelamento determinístico precisa ser substituída por alternativas que preservem a eficiência da extração.
A própria existência de um sistema em produção avaliado contra propostas humanas reais estabelece um precedente para benchmarks mais honestos no setor. O artigo deixa um recado prático: dobre a atenção ao que o modelo consome, mas deixe a escrita fluir em linguagem natural.
Fontes
arXiv: "Structure for Reading, Prose for Writing: Asymmetric Structural Conditioning in Multi-Agent Document Authoring" (arXiv:2608.20786v1). Link: https://arxiv.org/abs/2608.20786