
Iris: agentes de busca open-source batem recordes em benchmarks de pesquisa na web
Paper no arXiv detalha pipeline de dados e o método SFT-RL climbing por trás dos dois modelos
O que aconteceu
Um grupo de pesquisadores apresentou no arXiv, em 3 de setembro de 2026, o paper "Iris: Climbing to the Search Frontier" (arXiv:2609.04304). O trabalho descreve dois agentes de busca, Iris-mini e Iris-pro, treinados nas escalas 35B-A3B e 397B-A17B, ou seja, 35 bilhões de parâmetros totais com 3 bilhões ativos no mini e 397 bilhões totais com 17 bilhões ativos no pro.
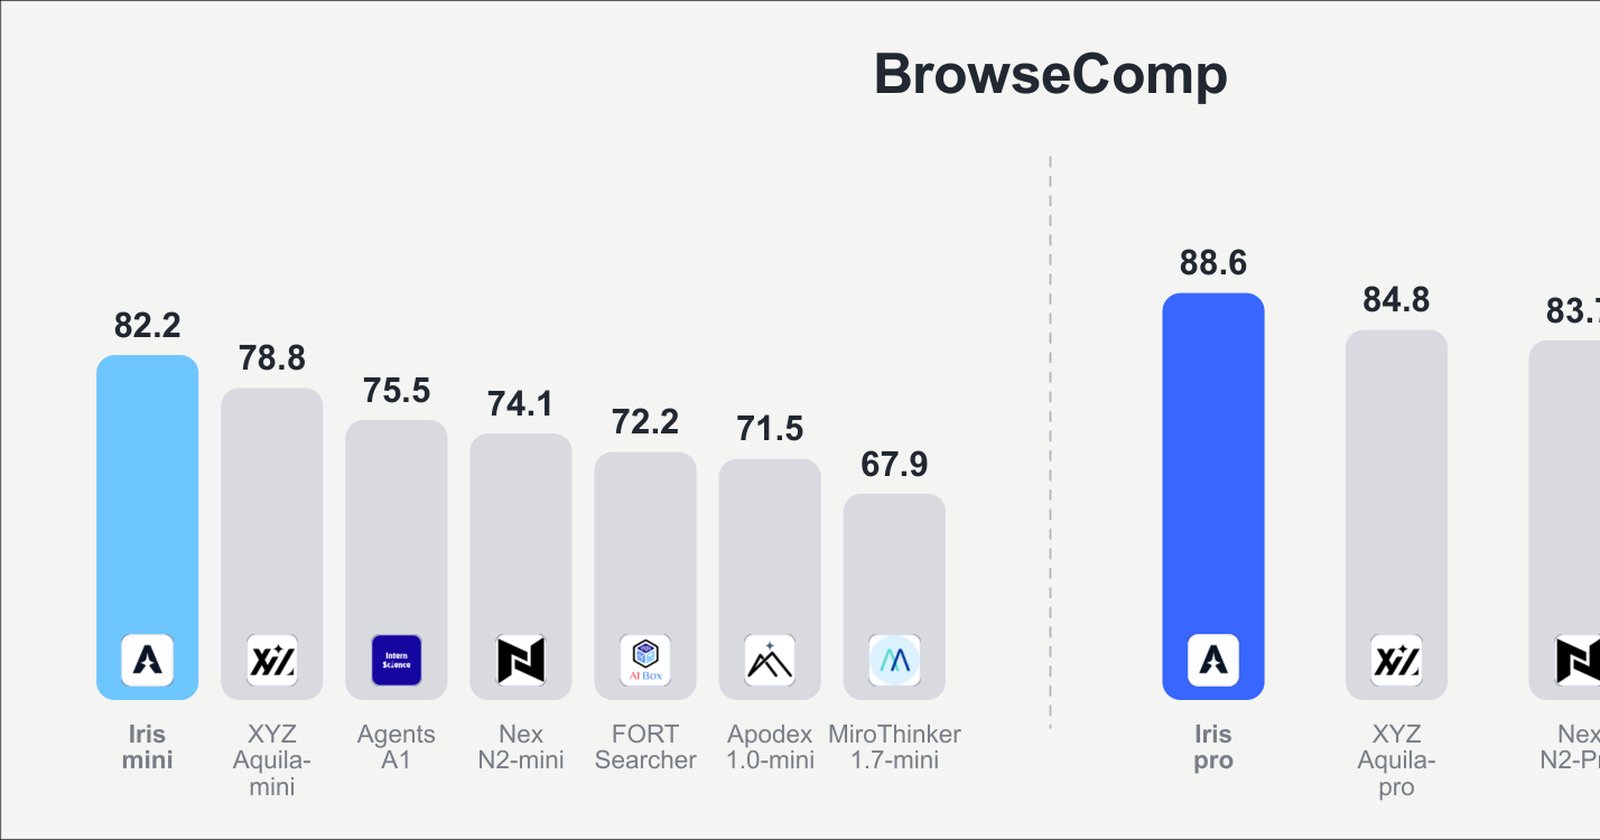
Os números são fortes. Com gerenciamento de contexto habilitado, Iris-mini atingiu 82,2 no BrowseComp, 84,8 no BrowseComp-ZH, 86,9 no DeepSearchQA e 52,3 no HLE. Iris-pro, o modelo maior, alcançou 88,6 no BrowseComp, 85,1 no BrowseComp-ZH, 92,9 no DeepSearchQA e 56,4 no HLE. Segundo o paper, esses são os melhores resultados gerais entre agentes de busca open-source em suas respectivas faixas de parâmetros.
Os autores do Iris planejam liberar os pesos dos modelos junto com a receita completa de construção de dados, treinamento e avaliação.
Contexto
A construção dos dados de treinamento é o ponto mais interessante do trabalho. As tarefas são construídas de forma reversa a partir da estrutura de hyperlinks de um corpus da web. Os pesquisadores criam cadeias multi-hop sobre um grafo de entidades destilado de uma página semente e seus links de saída.
O detalhe que separa o Iris de trabalhos anteriores: cada entidade que não é a resposta é reescrita como uma referência descritiva. Assim, nenhuma pista pode ser resolvida por simples correspondência de strings. Só entram no conjunto perguntas que um modelo de referência erra sem consulta (closed-book) mas acerta quando a evidência de suporte é fornecida.
O treinamento alterna duas etapas. Primeiro, as perguntas viram trajetórias filtradas nos níveis de trajetória e de turno antes do SFT (supervised fine-tuning). Depois, a política é otimizada por RL (reinforcement learning) contra busca ao vivo, com o juiz de recompensa e o resumidor de observações rodando dentro do próprio cluster de treinamento. Rollouts muito longos são interrompidos no nível de requisição e retomados do prefixo já confirmado no passo seguinte.
A alternância das duas etapas recebeu o nome de SFT-RL climbing: os rollouts mais difíceis resolvidos e mais eficientes de cada rodada de RL retornam para a próxima passada supervisionada.
Por que importa
O paper faz uma advertência que muda a leitura de benchmarks do setor. Segundo os autores, o gerenciamento de contexto em tempo de inferência vale mais nesses benchmarks do que a maioria das diferenças reportadas entre sistemas. Por isso, o Iris foi avaliado com e sem esse gerenciamento, mantendo fixos o conjunto de ferramentas, o limite de contexto e o juiz.
Outro ponto relevante: todos os resultados vêm de um único agente ReAct, sem sub-agentes e sem verificação em tempo de teste. Isso significa que o desempenho não depende de orquestração complexa de múltiplos modelos, uma arquitetura mais barata de rodar e mais fácil de replicar.
Impacto
Se os pesos e a receita completa forem realmente liberados, equipes que hoje dependem de APIs fechadas para busca profunda na web ganham uma alternativa open-source com desempenho de ponta. O Iris-mini, com apenas 3 bilhões de parâmetros ativos, é o candidato natural para rodar em infraestrutura modesta. O Iris-pro, com 17 bilhões ativos, mira os casos mais difíceis.
A transparência sobre o método de avaliação, com e sem gerenciamento de contexto, também pressiona outros laboratórios a reportar números nas mesmas condições, o que facilita comparações honestas entre sistemas.
O que muda
Para o mercado de agentes de busca, o Iris-mini e o Iris-pro estabelecem um novo piso de desempenho open-source nas faixas de 35B-A3B e 397B-A17B. O método SFT-RL climbing, que recicla os rollouts mais difíceis de cada rodada de RL para o próximo estágio supervisionado, pode ser adotado por outros grupos assim que a receita completa for publicada.
O que vem agora
O próximo passo anunciado pelos autores é a liberação dos pesos dos dois modelos junto com o pipeline completo de construção de dados, treinamento e avaliação. O paper não traz data específica para o release. Até lá, os números do arXiv servem como referência, mas a verificação independente pela comunidade só será possível quando os modelos estiverem disponíveis.