
Jalapeño: chip da OpenAI estreia com velocidade líder em inferência de IA
Chip desenvolvido pela OpenAI para inferência de IA foca em velocidade e economia de energia
O que aconteceu
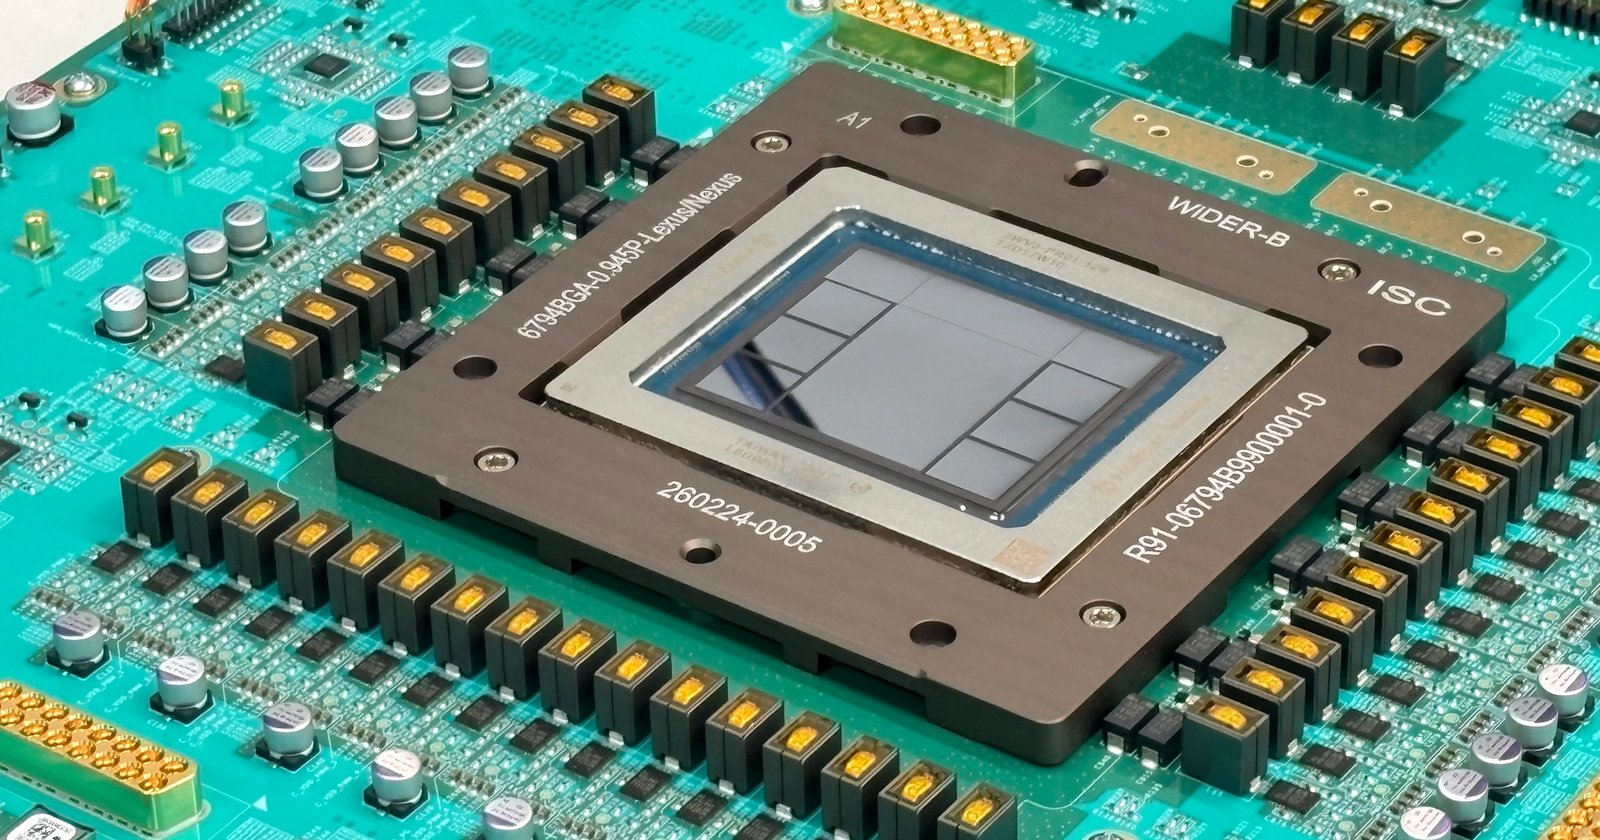
Em 25 de agosto de 2026, a OpenAI publicou em seu blog oficial um post intitulado "Jalapeño’s first results show industry-leading speed and efficiency in AI inference". No texto, a empresa revela que o Jalapeño é um chip de inferência customizado, projetado internamente, que se destaca por oferecer inferência de IA mais rápida e com menor consumo de energia. A OpenAI afirma que o chip proporciona maior throughput (taxa de processamento de dados) e menor latência (tempo de resposta) para modelos modernos. O anúncio não traz especificações técnicas exatas, como quantidade de transistores ou teraflops, mas o tom é claro: resultados "líderes do setor" em velocidade e eficiência. O chip Jalapeño, segundo a OpenAI, foi desenhado para atender à crescente demanda por inferência, etapa de execução de modelos já treinados. O post não informa prazos de produção em escala nem valores de custo, apenas indica que os primeiros testes superaram as expectativas internas.
Contexto
A OpenAI é mais conhecida por seus modelos de linguagem, como o GPT, que alimentam o ChatGPT e outras ferramentas. Mas a empresa vem investindo pesadamente em infraestrutura própria. O desenvolvimento de chips customizados para inferência é um movimento estratégico. Empresas como Google já usam TPUs (Tensor Processing Units) em seus data centers, e Amazon desenvolveu o chip Inferentia para AWS. A Nvidia domina o mercado de GPUs para IA, mas com a escalada dos custos e o gargalo de oferta, grandes players buscam alternativas. O Jalapeño se insere nesse contexto. Ao controlar o hardware, a OpenAI pode otimizar o desempenho de seus próprios modelos, reduzir custos operacionais e, potencialmente, oferecer preços mais competitivos aos clientes de sua API. Além disso, modelos mais eficientes em termos energéticos são uma preocupação crescente, tanto por questões ambientais quanto de custo de eletricidade.
Por que importa
Para desenvolvedores e empresas que usam APIs de IA da OpenAI, a promessa de maior throughput e menor latência significa respostas mais rápidas e maior capacidade de processamento por custo. Se o Jalapeño for integrado à infraestrutura da OpenAI, isso pode se traduzir em tempos de resposta menores em aplicações como chatbots, assistentes virtuais e análise de dados em tempo real. Para o mercado de chips, a entrada da OpenAI acirra a competição. A Nvidia, que domina o segmento de treinamento e também é forte em inferência, pode ver a OpenAI como um cliente que está se tornando concorrente. Para os investidores, a diversificação da OpenAI em hardware próprio é um sinal de maturidade e de busca por margens maiores. No Brasil, empresas que usam soluções de IA baseadas nos modelos da OpenAI podem se beneficiar de menor latência e custos mais baixos, embora o impacto direto dependa da disponibilização do chip em data centers locais.
Impacto
No curto prazo, os primeiros resultados do Jalapeño devem chamar atenção de empresas de tecnologia que buscam reduzir custos com IA. A maior eficiência energética também é um atrativo, especialmente em um momento em que data centers consomem cada vez mais eletricidade. No médio prazo, se o Jalapeño for massivamente adotado, pode pressionar os preços de GPUs e forçar a Nvidia a acelerar suas inovações. A OpenAI, por sua vez, ganharia independência e controle sobre sua própria pilha tecnológica. No Brasil, o impacto mais imediato seria para startups e empresas que dependem de APIs de IA para escalar produtos, já que a redução de latência e custo pode viabilizar novos casos de uso, como atendimento ao cliente em tempo real e processamento de imagens em larga escala.
O que vem agora
A OpenAI não divulgou detalhes sobre quando o Jalapeño estará em produção em escala ou em seus data centers. O anúncio traz apenas os "primeiros resultados", sugerindo que novos testes e benchmarks serão divulgados em breve. Especula-se que a empresa possa apresentar o chip em conferências de tecnologia ou em seu próximo evento de desenvolvedores, mas nada foi confirmado. A expectativa é que a OpenAI detalhe as especificações técnicas, como consumo de energia em watts por inferência e comparações com GPUs de mercado, para comprovar a liderança em eficiência. Também não há informações sobre se o chip será vendido a terceiros ou se será usado exclusivamente nos servidores da OpenAI. A empresa deve apresentar um roteiro mais claro no próximo trimestre, conforme o avanço das testagens internas.