
KVBoost acelera inferência de LLMs em 4,49x com cache reutilizável
Sistema de cache em chunks da arXiv reduz tempo até o primeiro token de 639,1 ms para 142,4 ms no Qwen2.5-3B
O que aconteceu
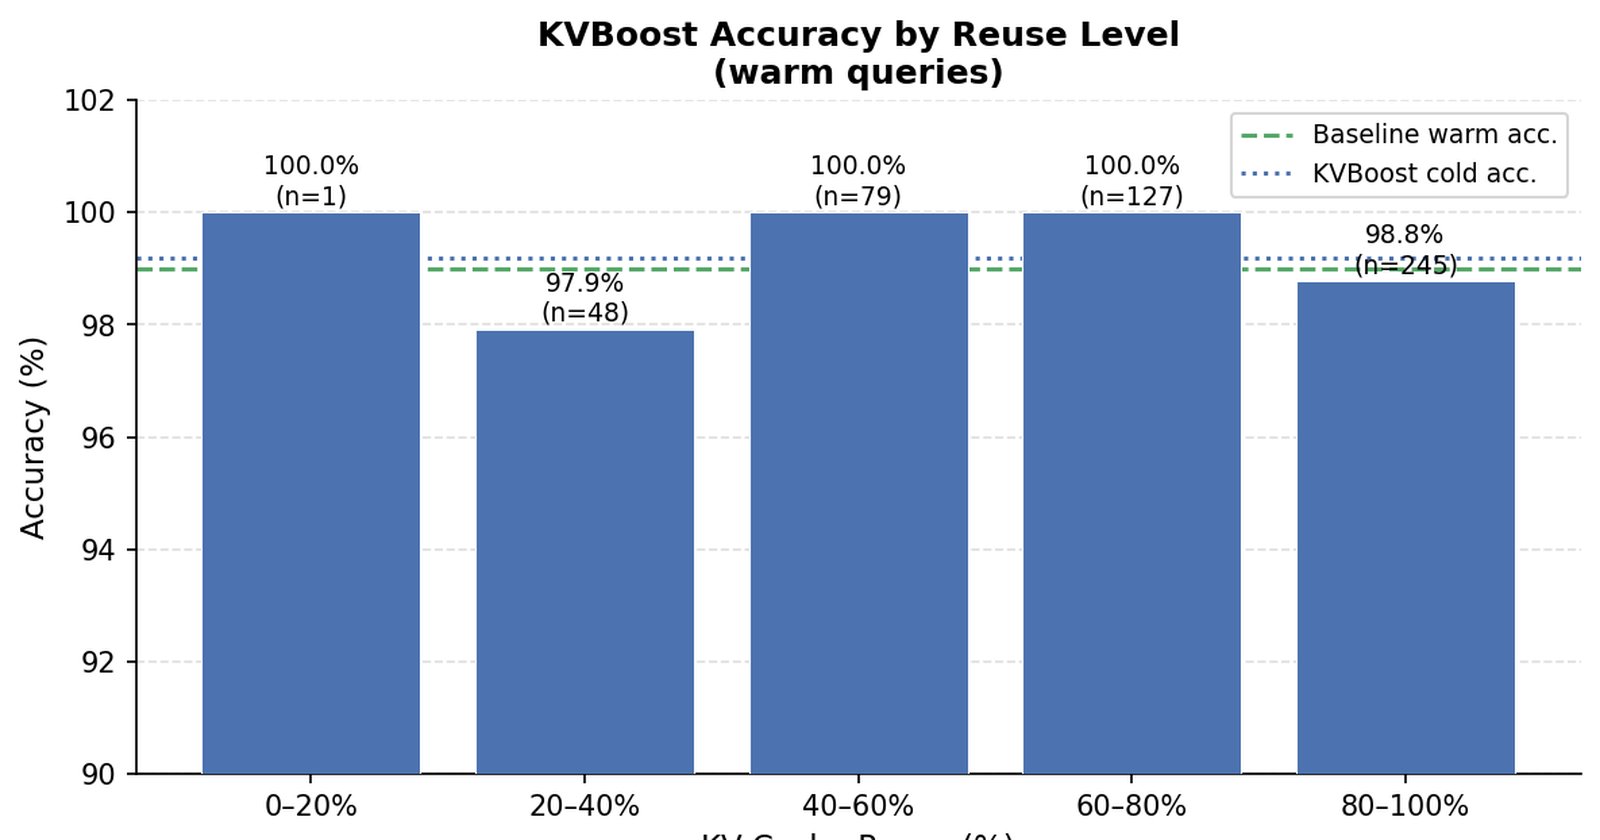
O KVBoost, um sistema de reutilização de cache de chave-valor (KV) em nível de chunk, foi apresentado em um artigo científico submetido à plataforma arXiv em 21 de maio de 2026, com ID arXiv:2608.21362. O sistema, desenvolvido para modelos decodificadores compatíveis com Hugging Face, permite reutilizar o cache de KV mesmo quando o conteúdo compartilhado aparece em posições arbitrárias dentro do prompt. Nos testes, o KVBoost reduziu o tempo até o primeiro token (TTFT) de 639,1 ms para 142,4 ms, uma queda de 4,49 vezes, conforme os autores. O modelo avaliado foi o Qwen/Qwen2.5-3B, usando 1.000 amostras de localização de bugs. O KVBoost superou o prefix caching em 16% nessa métrica, com acurácia de 99,2% contra 99,1% da abordagem tradicional.
Contexto
Modelos de linguagem baseados em Transformers, como os da família Qwen, sofrem alta latência de prefill porque os tensores de chave-valor precisam ser recomputados para cada requisição. Sistemas de prefix caching existentes reduzem esse custo, mas exigem que os prompts compartilhem um prefixo contíguo no início da sequência. Isso limita a eficácia quando o conteúdo reutilizável aparece em outras posições. O KVBoost, proposto no artigo submetido ao arXiv, resolve essa limitação ao trabalhar com chunks independentes, permitindo reuso independentemente da posição do conteúdo.
Por que importa
O KVBoost acelera a inferência de modelos Qwen, compatíveis com Hugging Face, sem modificar a arquitetura do modelo. Para empresas que operam LLMs em produção, isso significa custo menor e resposta mais rápida em tarefas como análise de código, localização de bugs e atendimento automatizado. O sistema adota um esquema de hash duplo que separa identidade posicional (prefix hash) de identidade de conteúdo (content hash), suportando correspondências exatas e aproximadas no cache. Esse desenho permite que o KVBoost funcione com modelos baseados em RoPE, como o Qwen2.5-3B, sem alteração estrutural.
Impacto
O KVBoost usa duas estratégias de reparo para lidar com erros de borda de atenção, que surgem quando chunks são cacheados independentemente: o SelectiveRecompute, que recodifica regiões de borda, e o CacheBlendRecompute, que identifica e recomputa tokens de alta divergência após uma passagem de sondagem. Além disso, o sistema incorpora quantização KV assimétrica (int8/int4), divisão adaptativa de fronteiras de chunk e evicção baseada em importância dentro de um orçamento de memória fixo. O resultado prático: o KVBoost atinge 142,4 ms de TTFT contra 639,1 ms da linha de base, mantendo acurácia de 99,2% em tarefas de localização de bugs, conforme o artigo.
O que muda
A reutilização de cache em nível de chunk, implementada no KVBoost, muda o paradigma atual de otimização de inferência. Diferente do prefix caching, que exige prefixos contíguos, o KVBoost permite reuso parcial e em posições variadas. Isso beneficia cargas de trabalho como revisão de código e debugging, onde trechos de código se repetem em contextos diferentes. O paper mostra que é possível acelerar a inferência do Qwen2.5-3B em 4,49x com memória limitada, graças à quantização int8/int4 e à evicção por importância, sem exigir alteração arquitetural.
O que vem agora
O artigo, submetido ao arXiv em maio de 2026, ainda não divulgou código público nem testes em outros modelos além do Qwen2.5-3B. A pesquisa foi reportada na página arXiv em agosto de 2026, e os autores indicam que o KVBoost foi projetado como uma camada de aceleração de inferência para modelos de decodificação. Próximos passos esperados incluem validação em modelos maiores, comparação com outras técnicas de cache e possível disponibilização via bibliotecas como Hugging Face. O sistema é apresentado como prático e limitado por memória, o que sugere viabilidade para implantação em servidores reais.
O que é o KVBoost
O KVBoost é um sistema de reutilização de cache de chave-valor em nível de chunk, apresentado no artigo arXiv:2608.21362. Ele combina dual-hash, recomputação guiada por desvio e quantização KV para acelerar a inferência de LLMs. Os pesquisadores avaliaram o KVBoost no modelo Qwen/Qwen2.5-3B, da família Qwen, usando 1.000 amostras de localização de bugs, e relataram 4,49x de redução no TTFT. A técnica do KVBoost gerencia o cache com hash de conteúdo e hash de prefixo, permitindo correspondências exatas e aproximadas. Com isso, o KVBoost oferece uma camada de aceleração compatível com RoPE e Hugging Face, conforme o resumo do artigo.