
LearnActCoder: memória de erros adapta agentes de codificação clínica
Novo framework Learn-Then-Act converte erros de um pequeno lote rotulado em base de conhecimento e direciona lições a Coder e Judge
O que aconteceu
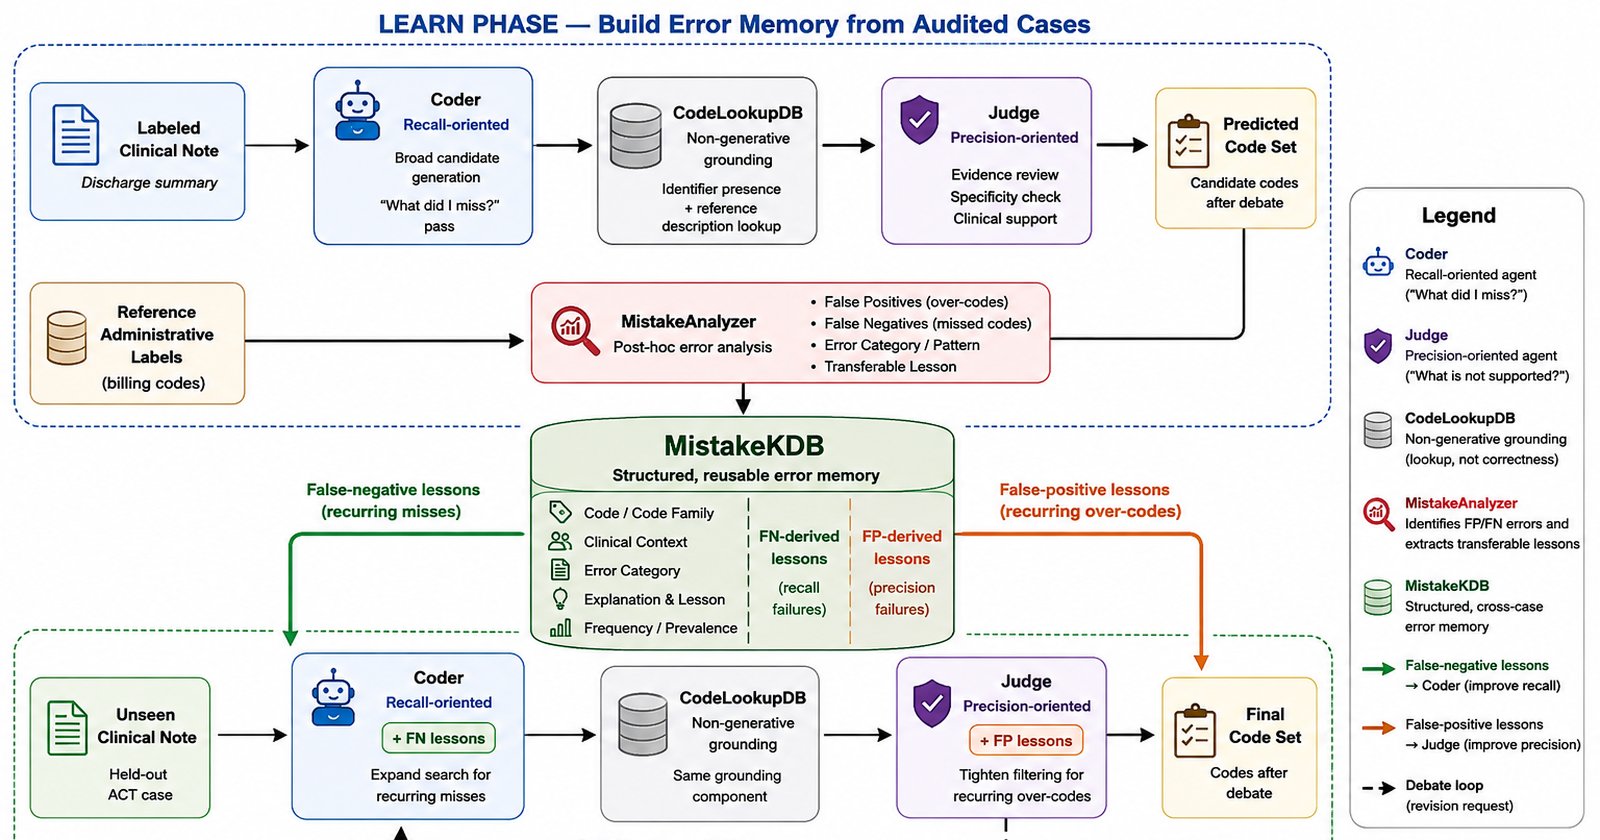
Um estudo publicado no arXiv em 17 de setembro de 2026 apresentou o LearnActCoder, sistema que aplica o framework Learn-Then-Act para adaptar agentes de codificação clínica a partir dos seus próprios erros. O artigo, identificado como arXiv:2609.19721v1, descreve uma abordagem de adaptação em tempo de inferência que converte os erros de um pequeno lote rotulado, chamado de LEARN, em uma base estruturada conhecida como Mistake Knowledge Database (MistakeKDB).
A arquitetura do LearnActCoder é um pipeline Coder-Judge com ancoragem em tabelas de consulta (lookup-table grounding) quando disponível. No LearnActCoder, as lições de falsos negativos são roteadas para um Coder orientado a recall, enquanto as lições de falsos positivos seguem para um Judge orientado a precisão. A base MistakeKDB, criada pelo framework Learn-Then-Act, centraliza essas lições de erro.
Os testes usaram 150 notas MIMIC-III pareadas. Nesse conjunto, a MistakeKDB estruturada melhorou o F1 de CPT em 5,9 pontos percentuais. Memórias no estilo de exemplos brutos e no estilo de reflexão permaneceram próximas da linha de base sem memória. A melhora em ICD-9 não foi estatisticamente significativa.
Em uma coorte pareada de MIMIC-IV, a memória deslocou a codificação ICD-10 para maior precisão, com custo de recall, deixando o F1 estatisticamente inalterado. Aplicar a mesma memória a 1.000 notas MIMIC-III mantidas fora da amostra preservou um ponto operacional estável de ICD, o que fornece evidência de escala e estabilidade.
Contexto
Agentes de codificação clínica repetidamente encontram os mesmos modos de falha. O artigo lista quatro: códigos sem suporte, condições documentadas que passam despercebidas, erros de especificidade e incompatibilidades com convenções de codificação de procedimentos. Esses erros se repetem caso após caso, e é essa recorrência que o Learn-Then-Act ataca.
A ideia central do framework Learn-Then-Act é separar o aprendizado da ação. Em vez de ajustar pesos, o sistema extrai lições de um lote pequeno e rotulado e as organiza em uma memória estruturada, a MistakeKDB. O LearnActCoder instancia esse framework em um fluxo com dois papéis distintos, Coder e Judge, cada um recebendo o tipo de lição compatível com seu objetivo.
A ancoragem em lookup-table grounding, quando disponível, dá suporte factual ao pipeline. O resultado geral descrito no artigo é consistente com a utilidade de uma memória de erros estruturada e derivada de feedback para adaptar o comportamento de codificação clínica entre casos, sem atualização de pesos e sem mudanças no fluxo de trabalho subjacente.
Por que importa
Codificação clínica é uma tarefa sensível: cada código atribuído afeta faturamento, relatórios e, em última análise, o que se sabe sobre um atendimento. O LearnActCoder importa porque mostra que um agente pode melhorar seu comportamento sem retreinar o modelo por trás dele. A memória de erros do LearnActCoder é o mecanismo que permite essa adaptação, e a MistakeKDB é a peça central.
Os números ajudam a dimensionar: 5,9 pontos percentuais de ganho em F1 de CPT nas 150 notas MIMIC-III pareadas são o resultado mais forte relatado. Ao mesmo tempo, o próprio artigo reconhece limites. O desempenho absoluto em CPT/HCPCS permanece baixo, e o sistema foi avaliado retrospectivamente, não em implantação clínica.
Isso significa que a promessa é de método, não de produto pronto. Um agente de codificação que aprende com erros estruturados e mantém estabilidade em escala é uma base de pesquisa. Um sistema clínico em produção exige validação prospectiva, que o artigo não faz.
Impacto
O impacto imediato do LearnActCoder está na direção de pesquisa de adaptação em inferência. O framework Learn-Then-Act sugere que dá para separar dois tipos de correção, recall e precisão, e entregá-los a papéis diferentes dentro do mesmo pipeline. O Coder do LearnActCoder absorve lições de falsos negativos. O Judge do LearnActCoder absorve lições de falsos positivos.
Em termos práticos, a coorte MIMIC-IV mostrou que a memória empurra a codificação ICD-10 para mais precisão, abrindo mão de recall, sem mudança estatística no F1. Já o teste com 1.000 notas MIMIC-III mantidas fora da amostra manteve o ponto operacional de ICD estável. Para quem desenvolve agentes clínicos, isso aponta um caminho que evita retreinar modelos a cada correção.
O contraponto é o teto de desempenho. F1 de CPT melhorou 5,9 pontos, mas o desempenho absoluto em CPT/HCPCS continua baixo, e a melhora em ICD-9 não foi significativa. Quem espera substituir codificadores humanos com este sistema ainda não encontra base no artigo.
O que muda
Muda a forma de tratar erro em agentes clínicos. No LearnActCoder, erros deixam de ser sinal descartável e viram ativo estruturado na MistakeKDB. O framework Learn-Then-Act mostra que memórias no estilo de exemplos brutos ou de reflexão não reproduzem o ganho observado com memória estruturada. Nas 150 notas MIMIC-III, essas abordagens alternativas ficaram perto da linha de base sem memória.
A distinção entre papéis também muda o desenho. Um Coder orientado a recall e um Judge orientado a precisão recebem lições opostas, o que evita que uma correção anule a outra. O LearnActCoder operacionaliza essa divisão com lookup-table grounding onde há tabelas disponíveis.
O que vem agora
O artigo não anuncia implantação clínica nem cronograma. A avaliação do LearnActCoder foi retrospectiva. Os próximos passos naturais apontados pelo próprio texto são superar o desempenho absoluto baixo em CPT/HCPCS e validar o sistema em uso clínico real, algo que o estudo ainda não fez.
A evidência de escala e estabilidade vem de 1.000 notas MIMIC-III mantidas fora da amostra, com ponto operacional de ICD estável. É esse o patamar que o Learn-Then-Act alcançou até agora. Ampliar isso para CPT/HCPCS com ganho consistente é o obstáculo que fica em aberto.