
LLM gera heurísticas dinâmicas para acelerar álgebra linear de alta performance
Pesquisadores do projeto SmartSolve, da DARPA e do MIT, usam modelo de linguagem para automatizar a escolha de algoritmos em bibliotecas de cálculo numérico.
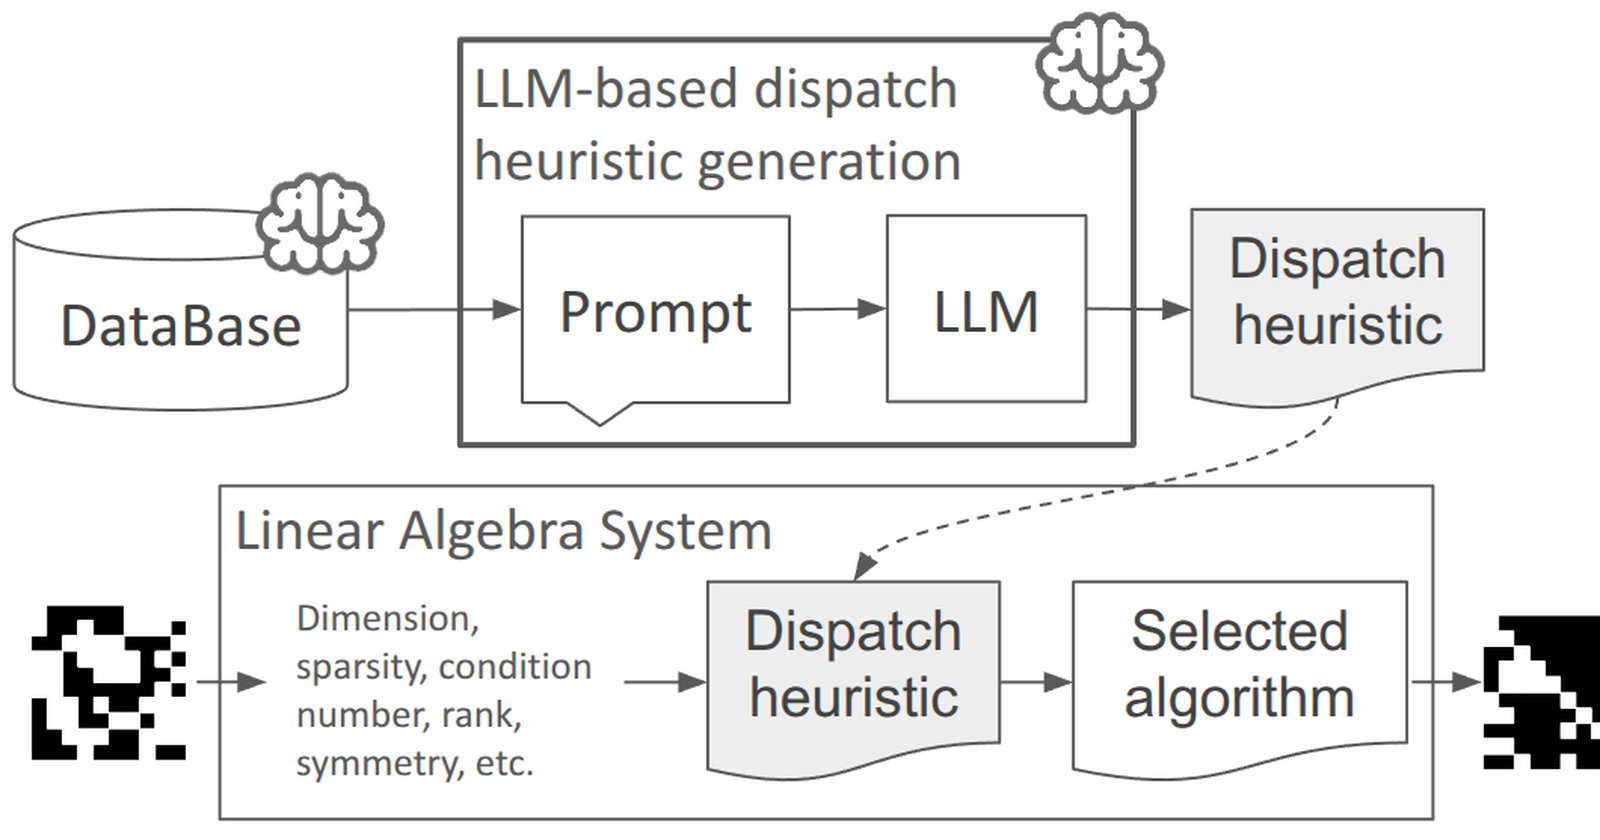
O que aconteceu
O artigo arXiv 2608.21584, intitulado "Data-Driven Dynamic Algorithm Dispatch with Large Language Models", foi disponibilizado na plataforma arXiv em 21 de agosto de 2026, na categoria cs.AI. O trabalho, desenvolvido no âmbito do projeto DARPA-MIT SmartSolve, propõe uma abordagem baseada em grandes modelos de linguagem (LLMs) para gerar heurísticas de dispatch algorítmico dinâmico em álgebra linear de alta performance. O modelo LLaMA 3, combinado a técnicas de prompt engineering e a um banco de dados de desempenho curado, aprende a sintetizar heurísticas de seleção que exploram padrões estruturais para identificar escolhas algorítmicas rápidas.
A equipe conduziu um caso de estudo sobre fatoração LU, método clássico de decomposição de matrizes amplamente usado em simulações científicas e engenharia. Os resultados mostraram que o LLaMA 3, guiado pela base de dados e pelos prompts, foi capaz de replicar estratégias que especialistas humanos haviam projetado manualmente. Em outras palavras, o sistema aprendeu a decidir, em tempo de execução, qual variante de algoritmo usar, sem depender de regras fixas escritas por programadores.
Outro ponto central: a iniciativa não é apenas acadêmica. O projeto SmartSolve, financiado pela DARPA (Defense Advanced Research Projects Agency, agência de pesquisa do Departamento de Defesa dos EUA), envolve o MIT (Instituto de Tecnologia de Massachusetts) e tem objetivo de acelerar a resolução de problemas matemáticos complexos com uso de inteligência artificial. O paper, submetido em agosto de 2026, é um dos resultados públicos dessa colaboração.
Contexto
A escolha de algoritmos em bibliotecas numéricas, como BLAS e LAPACK, sempre foi um campo artesanal. Especialistas analisam características da matriz, como tamanho, densidade e estrutura, para selecionar, entre dezenas de rotinas, aquela que será mais rápida em determinada arquitetura de hardware. Esse processo, chamado de dispatch ou seleção de rotina, é tradicionalmente feito por regras if-else codificadas à mão ou por autotuning empírico, que testa combinações em runtime.
O movimento agora é outro: usar LLMs como o LLaMA 3, da Meta, para descobrir essas heurísticas automaticamente. Em vez de programar regras, o modelo analisa dados de desempenho históricos e gera heurísticas que capturam padrões estruturais invisíveis para o programador. A fatoração LU, alvo do estudo, é um exemplo típico: diferentes estratégias de pivotamento e de blocking podem mudar o desempenho em ordens de magnitude, dependendo do hardware.
O contexto do projeto SmartSolve, da DARPA-MIT, reforça a aposta. A agência americana quer reduzir o tempo entre o surgimento de um problema matemático e a sua solução computacional. Este paper mostra uma aplicação concreta dessa visão: a IA não apenas resolve ou otimiza funções, mas aprende a tomar decisões algorítmicas de baixo nível.
Por que importa
O impacto prático é direto para quem desenvolve e usa bibliotecas numéricas de alto desempenho, desde simulação de clima até inteligência artificial. Hoje, adaptar um solver para um novo chip ou arquitetura exige semanas de trabalho de especialistas em código otimizado. Com o método proposto, um LLM treinado em dados de performance poderia gerar novas heurísticas de dispatch de forma quase automática, reduzindo esse esforço.
Além disso, o desempenho de aplicações científicas depende de escolhas algorítmicas que mudam com o hardware. Uma heurística fixa, escrita em 2020, pode ser subótima em uma GPU de 2026. O dispatch dinâmico, guiado por LLM, permite que o software se adapte à máquina em que está rodando.
Para o setor de softwares científicos, o custo de manutenção de bibliotecas como LAPACK pode cair. E para a indústria de chips, o método oferece um atalho: em vez de otimizar cada biblioteca para cada novo processador, bastaria fornecer dados de performance ao modelo.
Impacto
No curto prazo, o estudo demonstra que LLMs conseguem, com dados e prompts bem construídos, alcançar resultados comparáveis aos de especialistas humanos em pelo menos um caso clássico: a fatoração LU. Isso valida a direção de pesquisa e deve estimular novos trabalhos com outras decomposições, como Cholesky e QR.
No médio prazo, se o método escalar, bibliotecas numéricas podem passar a incorporar componentes de IA para decidir qual algoritmo executar a cada chamada. Isso impacta diretamente o desempenho de supercomputadores, onde milissegundos economizados em operações de álgebra linear se acumulam em horas de tempo de cálculo.
O contraste com o método tradicional também traz consequências para a formação de profissionais. Se máquinas aprendem a gerar heurísticas, o foco de engenheiros de performance pode migrar de escrever regras para curar dados de treinamento e validar resultados.
O que muda
A principal mudança é o papel do especialista. Em vez de codificar heurísticas manualmente, o profissional passa a criar bases de dados de desempenho e a supervisionar o que o LLM gera. O dispatch algorítmico, antes estático ou autotunado por tentativa e erro, torna-se um problema de aprendizagem de máquina.
A segunda mudança é de paradigma no desenvolvimento de software científico: o LLaMA 3, modelo aberto da Meta, é citado no trabalho como o motor de geração das heurísticas, o que sugere que a técnica pode ser replicada sem depender de modelos proprietários caros.
Para o usuário final, o ganho é transparência: a IA não apenas escolhe, mas pode explicar, via linguagem natural, qual padrão estrutural identificou, algo impossível com autotuning clássico.
O que vem agora
O próximo passo natural é expandir o caso de estudo para outras operações de álgebra linear e para arquiteturas distintas, como GPUs e aceleradores. O paper não divulga roadmap, mas a origem no projeto DARPA-MIT SmartSolve indica que há um programa maior em andamento, com possíveis resultados em outras áreas de matemática computacional.
No lado da comunidade, o trabalho deve circular em conferências como SC, ICS ou NeurIPS, e abrir discussão sobre padrões de avaliação: como medir se uma heurística gerada por LLM é de fato melhor que a de um humano em escala. Até lá, o artigo deixa claro que o próximo front da computação de alta performance não é apenas hardware, mas também a automação inteligente das decisões de software.