
LLM standalone vs pipeline agêntico para explicar mortalidade na UTI
Estudo de viabilidade no eICU Demo mostra troca entre fidelidade ao SHAP e ancoragem em diretrizes
O que aconteceu
Um estudo de viabilidade submetido ao arXiv em 21 de maio de 2026 comparou dois formatos de explicação para previsões de mortalidade em UTI. O artigo arXiv:2608.26109, classificado na área de Computer Science > Artificial Intelligence, avaliou um LLM standalone frente a um pipeline agêntico pré-especificado de quatro etapas. Os dois formatos foram testados sobre o conjunto de dados eICU Demo, com 2.353 internações e mortalidade de 8,1%.
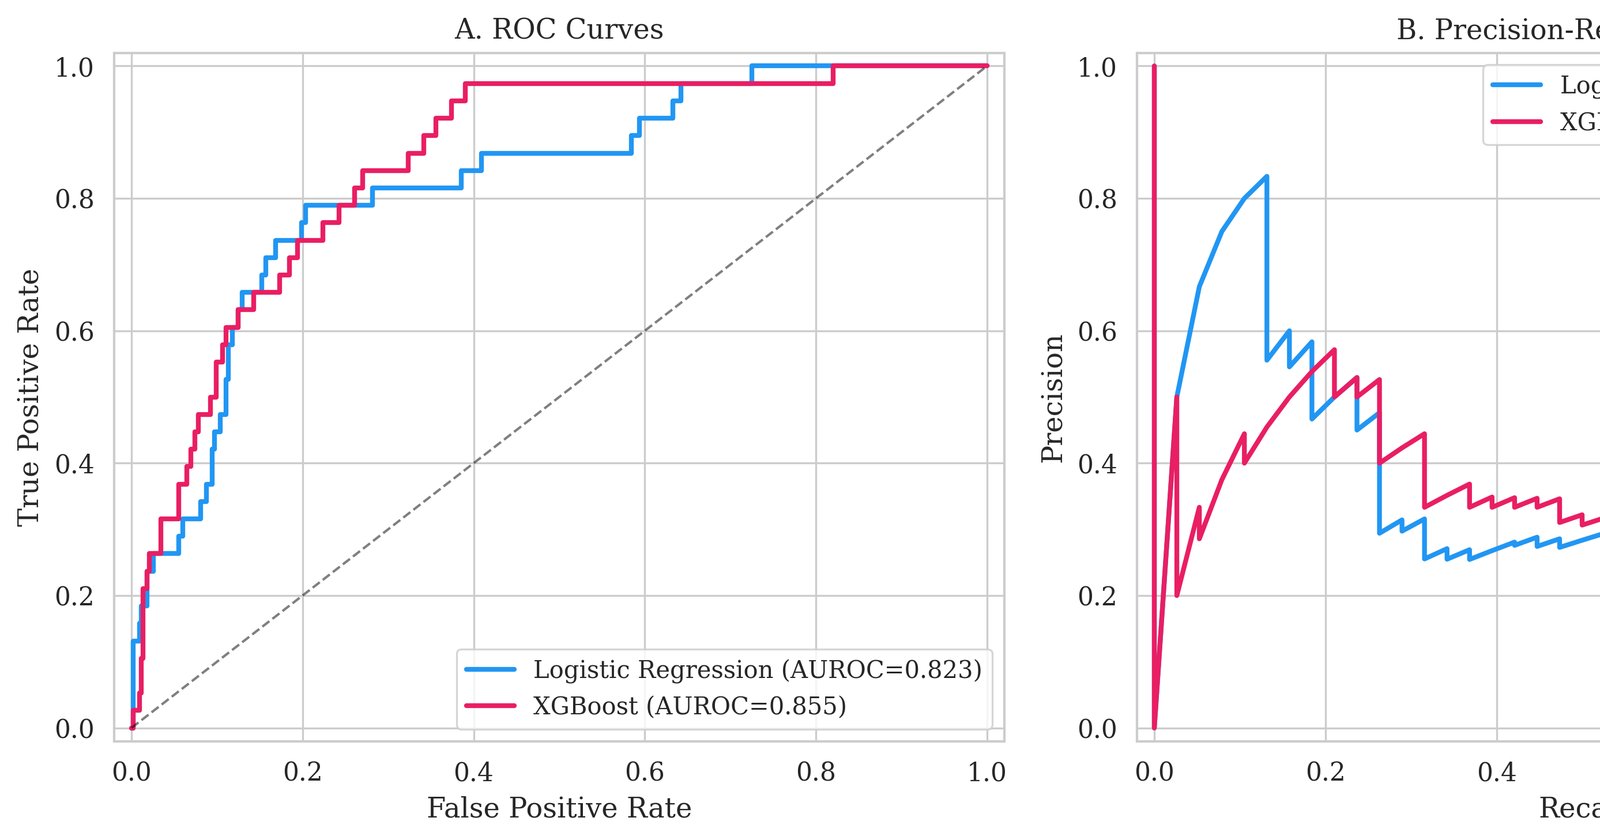
Os pesquisadores treinaram um modelo XGBoost para prever mortalidade. O XGBoost atingiu AUROC de 0,855 (IC 95% 0,796–0,906) e AUPRC de 0,332 (IC 95% 0,217–0,494). Em um subconjunto estratificado de 38 casos para explicação, o LLM standalone produziu uma explicação com vazamento explícito de desfecho. A mesma falha não apareceu no pipeline agêntico: zero casos com vazamento.
Contexto
Modelos de aprendizado de máquina preveem mortalidade na UTI com precisão, mas métodos de atribuição de características, como o SHAP, raramente entregam a narrativa clínica necessária para uso à beira do leito. Estudos anteriores mostram que atributos isolados dão números e pesos, sem contar a história clínica do paciente. É nesse ponto que entram os LLMs. O pipeline agêntico de múltiplas etapas é uma extensão plausível porque separa interpretação de dados, checagem de diretrizes e explicação final em passos controláveis.
Por que importa
Em cenários de alto risco, explicar o motivo de uma previsão é tão crítico quanto a precisão do modelo. O vazamento de desfecho acontece quando o LLM usa a resposta conhecida para montar a explicação, o que torna o texto clinicamente enganoso. O estudo indica que o pipeline agêntico apresentou maior ancoragem em diretrizes clínicas nos 14 casos sobrepostos à revisão SHAP: 0,762 contra 0,143 do standalone. A especificidade de valores também subiu no agêntico, com 0,236 contra 0,143. São diferenças grandes para quem precisa confiar no conteúdo gerado.
Impacto
Nos 14 casos analisados com o SHAP, o LLM standalone mostrou maior alinhamento com as atribuições do modelo, com Jaccard médio de 0,171 contra 0,077 do agêntico, e maior consistência de direção, com 92,9% contra 78,6%. O agêntico compensou com plausibilidade ligeiramente maior, 0,700 contra 0,671. A leitura é clara: o standalone reproduz melhor as atribuições, o agêntico entrega mais aderência a diretrizes e detalhe específico do paciente. Não há vencedor absoluto. A recomendação clínica é que a decomposição agêntica melhore a grounding de segurança, mas precise de verificações baseadas em atribuição antes de uso em explicações de risco elevado.
O que muda
Para equipes clínicas e desenvolvedores de IA em saúde, o estudo sugere que pipelines agênticos com etapas pré-definidas reduzem erros de explicação, desde que combinados com métodos de atribuição. A escolha entre um formato e outro passa a depender da prioridade: fidelidade às características do modelo ou aderência a diretrizes e especificidade por paciente.
O que vem agora
O trabalho é um estudo de viabilidade sobre o conjunto demo do eICU, então os autores não generalizam para produção clínica. O próximo passo é validar a abordagem com dados completos e em ambiente controlado, medindo aceitação médica e impacto na decisão. A recomendação explícita é acoplar o pipeline agêntico a verificações de atribuição antes de explicar previsões de risco em situações de alto perigo.
Fontes
arXiv cs.AI, artigo arXiv:2608.26109: Standalone LLM and a Pre-specified Agentic Pipeline for Explaining ICU Mortality Predictions. Disponível em https://arxiv.org/abs/2608.26109