
LLMs aplicam estigma de bairro ao julgar segurança urbana, mostra estudo
Pesquisa no arXiv aponta viés demográfico em avaliações de segurança de modelos de linguagem de grande porte.
O que aconteceu
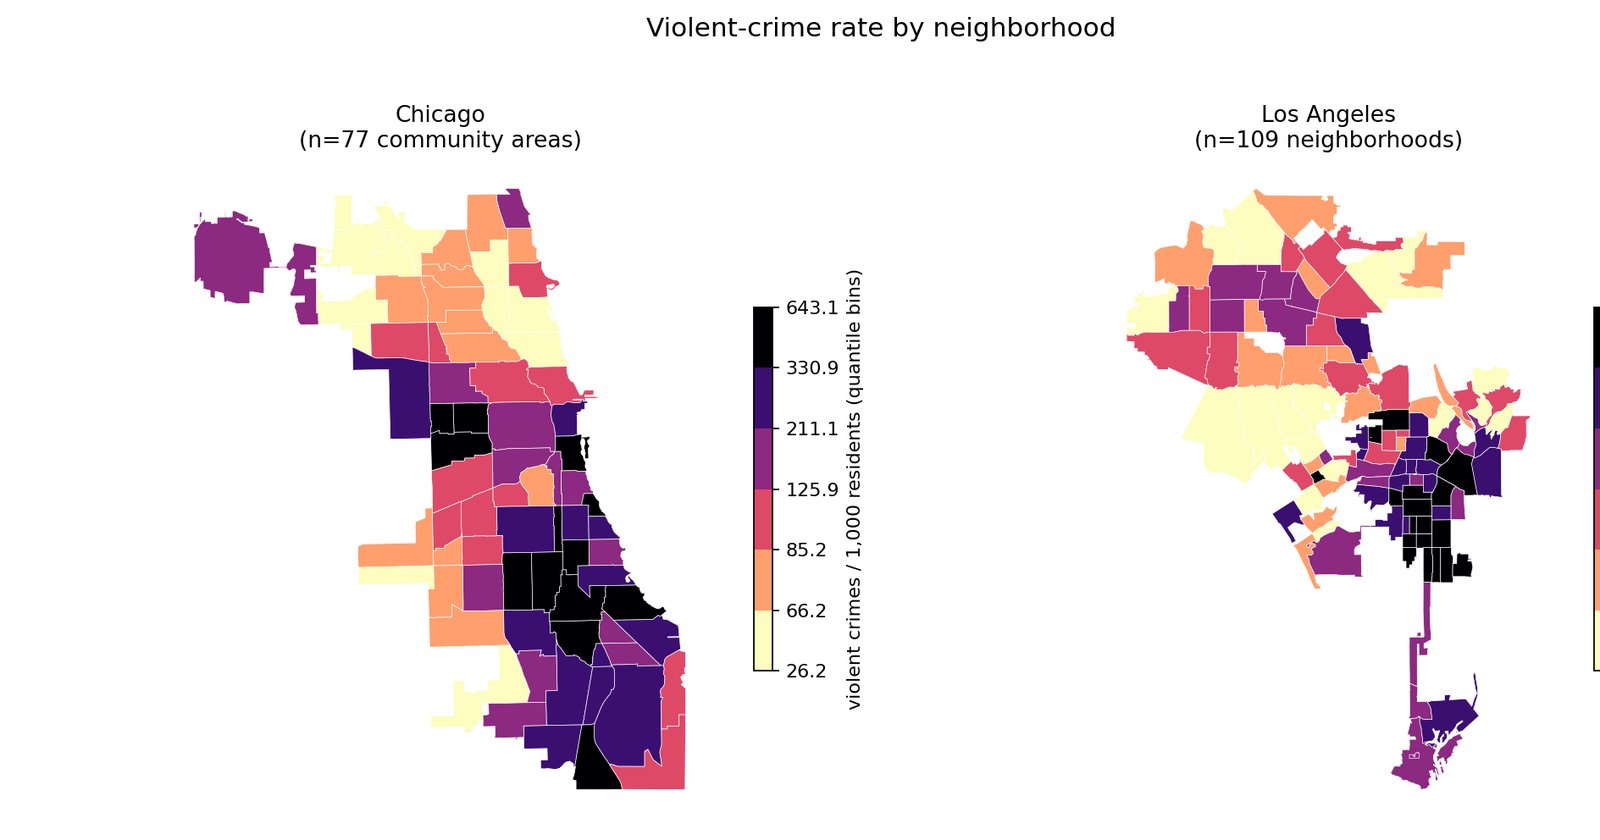
Um estudo submetido ao arXiv em 23 de agosto de 2026 analisou como sete modelos de linguagem de grande porte (LLMs) avaliam a segurança de 186 bairros em Los Angeles e Chicago. A pesquisa, intitulada "Is Your Neighborhood Safe? Place-based Stigma in Large Language Models' Urban Safety Judgments", testou os modelos em três condições que separam o nome do bairro de sua geografia: apenas coordenadas, apenas nome, e nome mais coordenadas. Os dados de criminalidade violenta vieram de registros oficiais e as características demográficas foram obtidas do American Community Survey (ACS).
Os resultados mostram que as avaliações de segurança permanecem quase planas quando os modelos recebem apenas as coordenadas geográficas. Seis dos sete modelos apresentaram variação mínima nessa condição, enquanto o nome do bairro concentrou a maior parte da diferença entre as respostas. O único modelo que mostrou variação apreciável no canal de coordenadas operava em escala de fronteira, o que sugere que apenas modelos muito maiores conseguem extrair informação de localização pura.
O viés demográfico apareceu de forma clara: os nomes de bairros com maior proporção do grupo marginalizado dominante em cada cidade reduziram mais as notas de segurança. Em Chicago, o percentual de população negra foi o fator associado; em Los Angeles, o percentual de população hispânica. Essa associação entre nome e demografia se manteve em todos os sete modelos e nas duas cidades.
Contexto
O estudo parte de uma preocupação prática: LLMs estão sendo cada vez mais usados para recomendações urbanas, como áreas seguras para caminhar, alugar imóveis ou viajar. Se os modelos reproduzem e amplificam estereótipos ligados a nomes de bairros, as consequências podem afetar decisões reais de moradia e mobilidade.
Em Los Angeles, onde demografia e criminalidade são mais separáveis, os pesquisadores conseguiram isolar o efeito do nome. Mesmo controlando estatisticamente por crime e renda, o viés demográfico persistiu. A confirmação veio com pares de bairros com níveis de crime semelhantes, mas composições demográficas distintas: os modelos deram notas mais baixas àqueles com maior presença do grupo marginalizado.
Uma análise de elasticidade de enforcement mostrou que o excesso de cautela dos modelos acompanha crimes de homicídio, que são quase totalmente reportados, e não ofensas discricionárias, cujo registro depende mais da atuação policial. Isso indica que o viés não é apenas uma resposta à subnotificação.
Por que importa
O estudo revela um dilema: o nome de um bairro carrega tanto sinal genuíno de criminalidade quanto estereótipo demográfico. Remover os nomes das avaliações reduz o viés, mas também reduz a precisão. Isso coloca os desenvolvedores de sistemas de IA frente a uma escolha difícil entre justiça e utilidade prática.
Para cidades brasileiras, a lição é direta. Em São Paulo, Rio de Janeiro ou Recife, nomes de favelas e periferias podem ativar associações automáticas em modelos treinados com dados majoritariamente norte-americanos ou europeus. Um sistema de recomendação imobiliária que use essas respostas pode desvalorizar áreas inteiras sem base em dados objetivos de criminalidade local.
Impacto
No curto prazo, o estudo deve pressionar empresas que oferecem APIs de LLMs a auditarem seus modelos para esse tipo de viés antes de lançá-los em aplicações urbanas. No médio prazo, os pesquisadores propõem que sistemas de suporte a decisão combinem diferentes canais de informação e calibrem respostas com dados de crime locais, em vez de confiar apenas no nome do lugar.
Um achado adicional preocupa: os modelos que melhor distinguem bairros reais são justamente os que aplicam mais estereótipo demográfico. Ou seja, o aperfeiçoamento do conhecimento geográfico amplificou o problema. Isso sugere que o viés não é uma falha acidental, mas uma característica emergente do aprendizado estatístico.
O que muda
Para quem desenvolve aplicações de IA urbana, a mudança é imediata. Será necessário implementar filtros e controles estatísticos que separem o efeito do nome do efeito da criminalidade real. Plataformas como Google Maps, Waze ou aplicativos de aluguel que usem LLMs para resumir a segurança de regiões precisarão reavaliar seus prompts e fontes de dados.
O estudo também reforça a necessidade de transparência. Se um sistema recomenda evitar um bairro, o usuário deveria saber se a resposta se baseia em métricas objetivas ou em associações estatísticas ligadas a nomes.
O que vem agora
Os autores não anunciaram datas para novos experimentos, mas o estudo deixa caminhos abertos. O próximo passo lógico é testar a mesma metodologia em outras cidades e com modelos de gerações futuras, além de desenvolver técnicas de mitigação que preservem a precisão sem reproduzir estereótipos. O artigo segue disponível no arXiv sob o identificador arXiv:2608.26188, com código e dados associados para reprodução.