
LoRA em difusão: ranks pequenos e médios são mais eficientes, diz estudo
Preprint no arXiv testou ranks de 2 a 32 em um DDPM U-Net sobre o CIFAR-10 e mediu FID, memória de GPU e tempo de execução
O que aconteceu
O paper "Understanding LoRA Rank Trade-offs in Diffusion Model Fine-Tuning" foi submetido ao arXiv em 9 de setembro de 2026 e publicado como arXiv:2609.10656v1, na categoria Computer Science > Artificial Intelligence. O estudo sobre trade-offs de rank em LoRA para difusão parte de uma pergunta prática: como escolher o rank sem pagar mais computação do que o necessário.
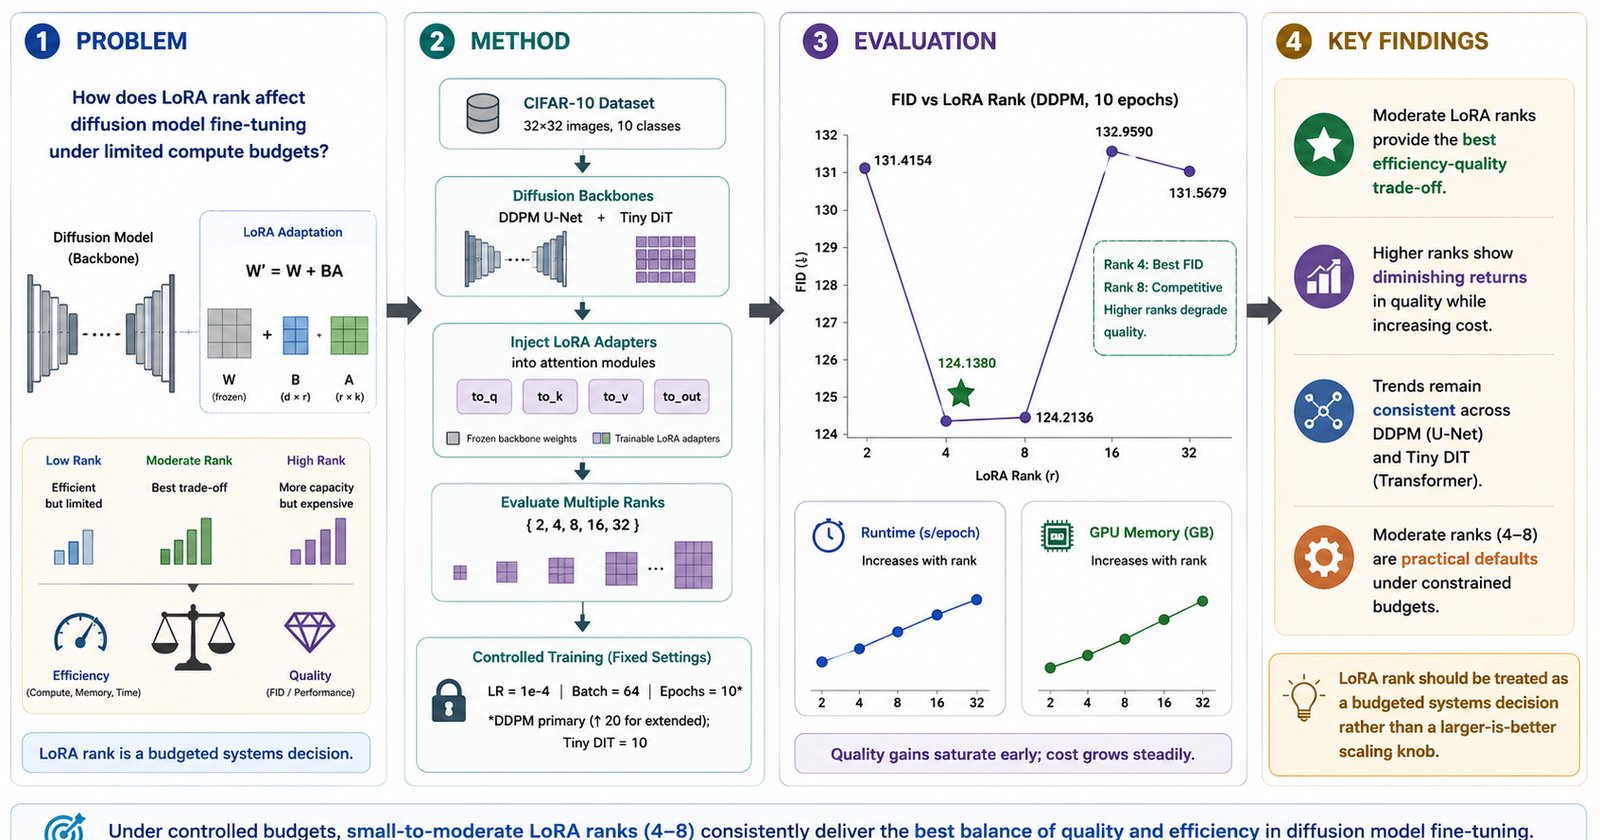
Os autores montaram um experimento controlado no CIFAR-10 usando um backbone DDPM U-Net e ranks de 2, 4, 8, 16 e 32, com configurações de otimização fixas e um protocolo reprodutível de pytorch-fid baseado em pasta local. O material reporta quatro métricas por configuração: FID, número de parâmetros treináveis, tempo de execução e memória de GPU.
Os resultados principais colocam o rank 4 no topo do DDPM, com FID de 124,1380. O rank 8 aparece em seguida, com 124,2136, uma diferença de 0,0756 entre os dois. Ranks mais altos trouxeram ganhos limitados mesmo com custo de adaptação maior, segundo o resumo do trabalho.
Para validar a tendência, os autores rodaram dois blocos adicionais. No primeiro, fizeram execuções DDPM com orçamento estendido de 20 épocas nos ranks 4, 8 e 16. No segundo, repetiram o teste em um backbone Tiny DiT com 10 épocas, também nos ranks 4, 8 e 16.
Contexto
A escolha do rank é uma decisão central em LoRA, técnica de adaptação de baixo posto usada para ajustar modelos grandes sem retreinar todos os pesos. O resumo do estudo trata essa escolha como um problema de balanço entre qualidade e custo de computação, e não como um parâmetro que se resolve aumentando o valor.
O experimento foi desenhado para isolar o efeito do rank. Ao fixar as configurações de otimização e adotar um protocolo reprodutível de pytorch-fid em pasta local, os autores reduziram variações que costumam contaminar comparações entre execuções diferentes. As métricas reportadas vão além da qualidade: parâmetros treináveis, tempo de execução e memória de GPU entram na conta, o que permite avaliar o custo real de subir o rank.
A validação cruzada com duas configurações distintas, o DDPM U-Net com 20 épocas e o Tiny DiT com 10 épocas, serve para verificar se o padrão observado se sustenta fora do cenário inicial. Ambos os testes usaram os mesmos ranks 4, 8 e 16, o que permite comparar diretamente os backbones.
Por que importa
Para quem faz fine-tuning de modelos de difusão, o resultado tem efeito direto no orçamento de treino. Se o rank 4 obtém o melhor FID no DDPM e o rank 8 fica praticamente empatado, não há justificativa medida para saltar para ranks de 16 ou 32 em busca de qualidade. O custo dessa escolha aparece em parâmetros treináveis, tempo de execução e memória de GPU, exatamente as métricas que o estudo acompanha.
O Tiny DiT, backbone menor testado com 10 épocas, reforça o argumento de que a conclusão não depende de uma única arquitetura. O achado central do trabalho é que ranks pequenos e médios funcionam como padrão prático quando o orçamento de treino é fixo.
Impacto
Na prática, o estudo oferece um ponto de partida para times que precisam definir rank antes de rodar um fine-tuning. Um valor moderado reduz a quantidade de parâmetros treináveis e, com isso, tende a baratear a infraestrutura necessária por experimento, o que libera orçamento para mais rodadas de teste.
O impacto também é metodológico. Ao publicar um protocolo reprodutível de pytorch-fid em pasta local, os autores dão a outros grupos um caminho para comparar resultados sem depender de ambiente externo. Isso facilita replicar o teste em outros datasets e outros backbones.
O que muda
O que muda é o valor padrão sugerido para o rank em fine-tuning de difusão sob orçamento fixo. O estudo sobre trade-offs de rank em LoRA para difusão recomenda ranks pequenos e médios como default, com o rank 4 liderando o FID no DDPM U-Net e o rank 8 vindo logo depois. Ranks de 16 e 32 ficam com ganhos limitados diante do custo de adaptação maior.
O que vem agora
O preprint está disponível no arXiv em PDF e em versão HTML experimental, com o identificador arXiv:2609.10656v1, submetido em 9 de setembro de 2026. O trabalho não anuncia próximos passos próprios no resumo. A continuação natural fica com quem replicar o protocolo em outros datasets e backbones, usando as métricas de FID, parâmetros treináveis, tempo de execução e memória de GPU como base de comparação.
Fontes
- arXiv cs.AI: Understanding LoRA Rank Trade-offs in Diffusion Model Fine-Tuning (arXiv:2609.10656v1) https://arxiv.org/abs/2609.10656