
Memória condicional nem sempre melhora IA em ciência, mostra estudo
Pesquisadores do paper 'Memory Is Not Always Needed' propõem mecanismo que decide quando ativar memória externa em raciocínio biológico e químico.
O que aconteceu
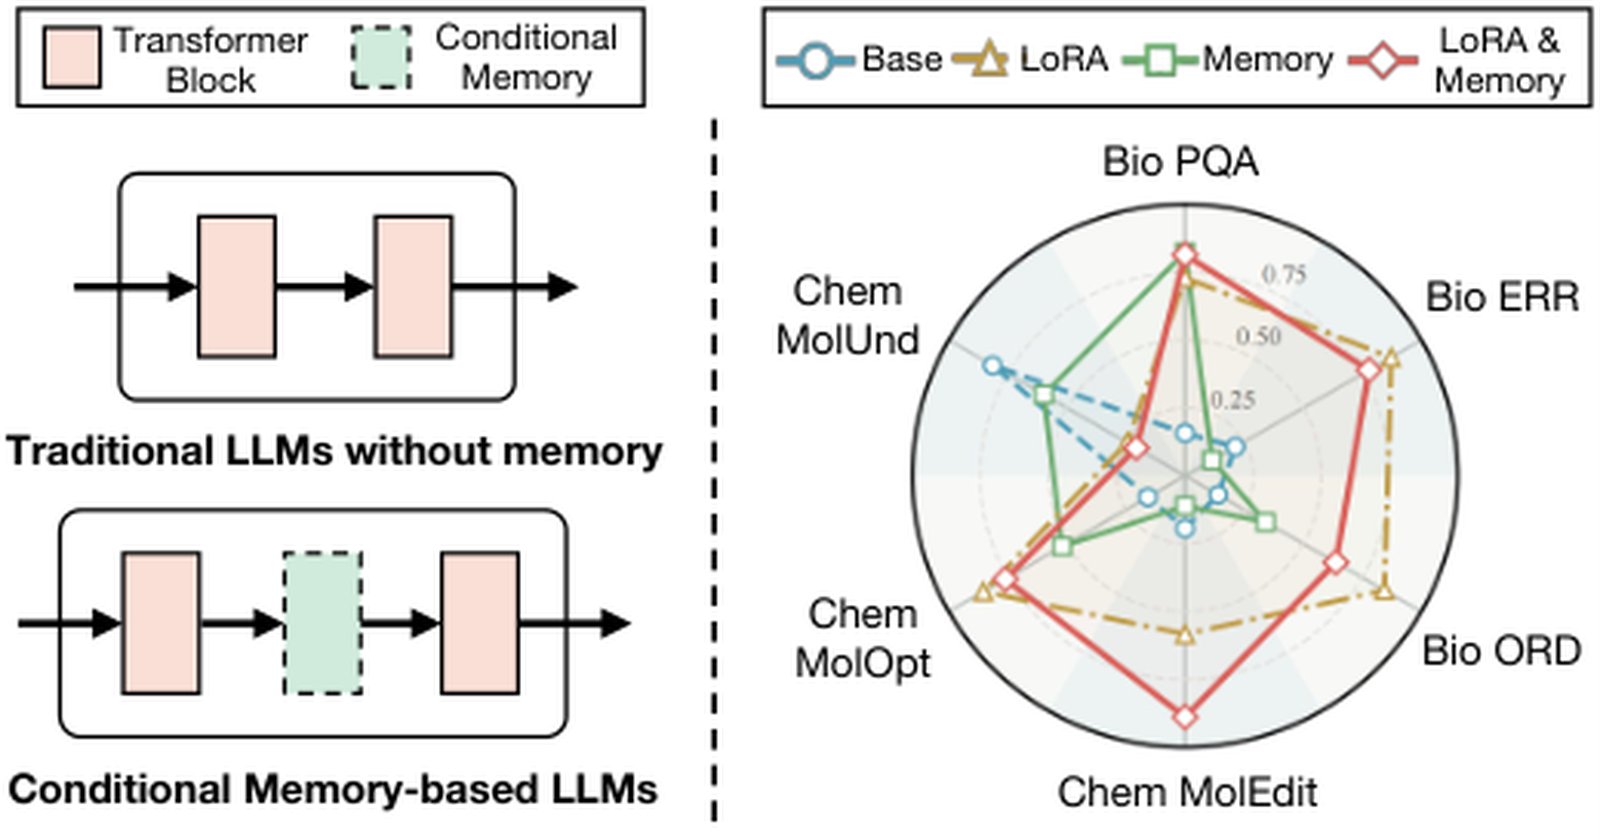
O paper 'Memory Is Not Always Needed' foi postado no repositório arXiv em 25 de agosto de 2026, sob o código 2608.23982, na categoria Computer Science > Artificial Intelligence (cs.AI). A equipe responsável pelo trabalho investigou quando a memória condicional, um mecanismo que permite ao modelo buscar conhecimento específico em fontes externas, deve ser ativada durante tarefas de raciocínio científico. Os experimentos cobriram dois grupos de modelos de linguagem (backbone families) e seis tipos de tarefas em benchmarks de biologia e química. O resultado central é que o efeito da memória varia muito conforme a entrada, a tarefa e o local onde os sinais são injetados na rede. Em alguns casos, a memória corrige associações científicas ausentes; em outros, introduz atalhos que distraem o modelo ou interferem em raciocínios que ele já executa corretamente.
Contexto
Modelos de linguagem de grande porte armazenam conhecimento em seus parâmetros neurais, mas esse armazenamento é denso e nem sempre confiável. A memória condicional funciona como uma via alternativa de consulta explícita a informações especializadas, complementando essas representações. A proposta do artigo, porém, questiona a suposição de que mais memória é sempre melhor. Os autores definem uma 'fronteira de conhecimento científico' e fazem intervenções controladas em nós de circuitos de conhecimento habilitados para memória. A partir dessas análises, eles criaram o Knowledge Boundary-Aware Router, um mecanismo que usa indicadores de entrada (proxies) disponíveis antes da geração para decidir três coisas: se a memória deve ser ativada, em quais estágios de camadas os sinais de memória devem ser injetados e com que intensidade. Isso difere de abordagens estáticas, que sempre ativam a memória, ou de roteamentos aleatórios, que não levam em conta a natureza da tarefa.
Por que importa
A confiabilidade é um dos maiores gargalos para o uso de IA em áreas científicas, onde um erro de associação pode levar a conclusões erradas. O estudo mostra que a decisão de usar memória não pode ser tomada às cegas: em tarefas de biologia ou química, a consulta externa pode tanto reparar lacunas quanto induzir regressões. O roteador proposto, ao escolher seletivamente quando ativar a memória, mantém os benefícios dela enquanto suprime os efeitos negativos. Isso estabelece o princípio da alocação seletiva de memória como um requisito para raciocínio científico confiável em modelos de linguagem. Para empresas e laboratórios que desenvolvem sistemas de IA para pesquisa, o trabalho oferece uma diretriz prática: nem todo problema exige mais conhecimento externo, e o modelo deve ter um mecanismo para decidir isso.
Impacto
Em curto prazo, o artigo pode influenciar o design de sistemas de recuperação aumentada (retrieval-augmented generation) para domínios científicos. Em vez de ativar memória de forma incondicional, esses sistemas passariam a usar roteadores baseados na fronteira de conhecimento. No médio prazo, a abordagem pode reduzir o custo computacional, já que menos consultas externas seriam necessárias, e melhorar a precisão em benchmarks como os usados na pesquisa. Os autores compararam o roteador com métodos estáticos e com roteamento aleatório controlado por taxa de ativação, e mostram que a abordagem seletiva é mais consistente em preservar contribuições benéficas da memória e suprimir regressões induzidas por ela.
O que muda
A principal mudança é a forma como enxergamos a memória em modelos de linguagem. Ela deixa de ser um recurso que se liga sempre e passa a ser um componente que exige gerenciamento dinâmico, dependente do input e da computação. O paper propõe que a ativação da memória seja decidida por um router específico da tarefa, não por uma regra fixa. Isso representa um avanço em relação às práticas atuais de retrieval augmentation, que costumam consultar bases externas para qualquer pergunta.
O que vem agora
Os próximos passos naturais são testar o Knowledge Boundary-Aware Router em outros domínios científicos e em mais famílias de modelos. Também é esperado que o princípio da alocação seletiva inspire novos trabalhos sobre quando ativar outros mecanismos externos, como ferramentas de cálculo ou APIs. O artigo ainda não detalha a implementação completa do roteador nem disponibiliza código, mas a descrição metodológica pode servir de base para reprodução. A comunidade de IA deve acompanhar o debate sobre como definir automaticamente a fronteira de conhecimento de cada modelo.