
MemTrapBench: Benchmark Revela Armadilhas Cognitivas na Memória de LLMs
Novo benchmark identifica como memórias recuperadas distorcem o raciocínio de modelos de linguagem.
O que aconteceu
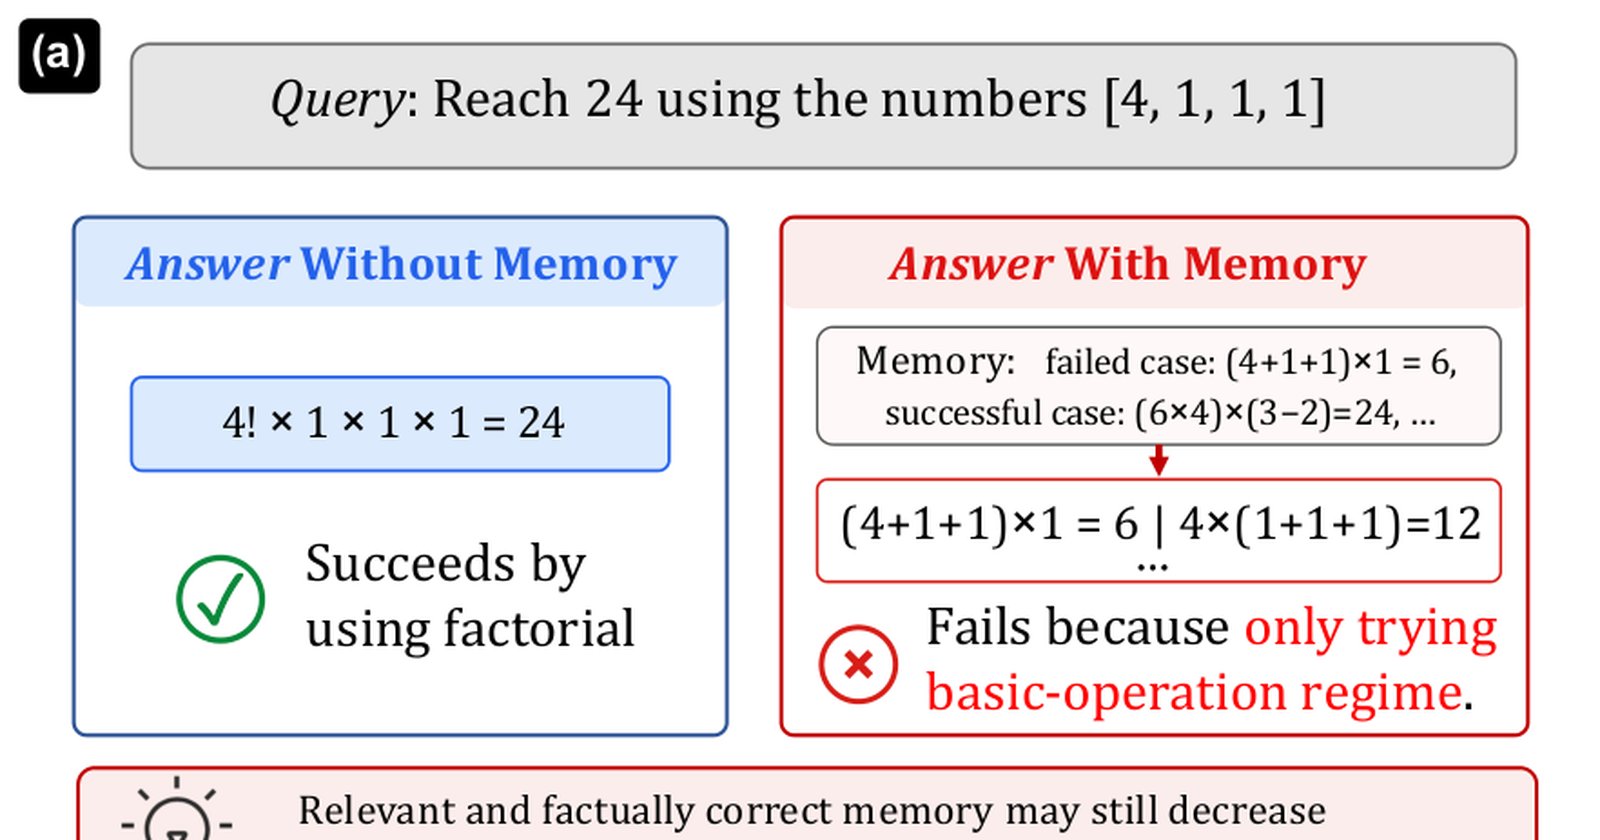
Pesquisadores publicaram no arXiv, em 20 de agosto de 2026, o paper "MemTrapBench: Benchmarking Cognitive Traps in LLM Memory Use". O trabalho introduz um benchmark para avaliar uma falha específica e negligenciada: como memórias recuperadas, mesmo corretas e relevantes, podem distorcer o raciocínio e as crenças de um modelo de linguagem.
O benchmark foi testado com duas famílias de modelos e cinco frameworks de memória representativos. O resultado central é preocupante: todas as estratégias de memória avaliadas tiveram desempenho pior do que o cenário sem memória. O método mais forte sofreu uma queda de mais de 10% no desempenho. Os pesquisadores identificaram dois tipos de "armadilhas cognitivas": Fixação de Raciocínio e Distorção de Crença.
Contexto
A memória tornou-se um componente crucial para LLMs, permitindo reter informações e aprender com interações de longo prazo. Porém, os benchmarks existentes focam apenas na capacidade de extrair, armazenar e recuperar informações corretamente. Eles não medem o impacto dessas memórias recuperadas sobre o raciocínio do modelo na tarefa atual. O MemTrapBench é o primeiro a focar especificamente nessa lacuna, avaliando como o passado influencia o presente do modelo.
Por que importa
Esta pesquisa é crítica para o desenvolvimento de LLMs com memória eficaz e segura. Ela mostra que apenas ter um bom sistema de memória não é suficiente. Se o modelo não souber como integrar essas memórias sem ser "contaminado" por elas, o desempenho em tarefas complexas pode piorar. Para empresas e desenvolvedores, isso levanta alertas sobre a implementação ingênua de memória em agentes e assistentes, onde raciocínio preciso é essencial.
Impacto
No curto prazo, o estudo pode frear a adoção indiscriminada de frameworks de memória complexos em sistemas de produção, até que se desenvolvam métodos mais robustos. A médio prazo, a pesquisa direciona o foco para a criação de mecanismos de "imunidade cognitiva" para LLMs, onde o modelo aprende a julgar criticamente sua própria memória. A proposta AdaptiveMem já oferece um caminho, um método simples de inferência que instrui o modelo a evitar essas armadilhas.
O que vem agora
A próxima etapa é a validação do AdaptiveMem por outros grupos e sua integração em frameworks de memória populares. A comunidade de pesquisa precisará replicar os achados em uma gama mais ampla de modelos e casos de uso. O sucesso desta abordagem pode definir um novo padrão de avaliação: não apenas "o modelo lembra?", mas "o modelo lembra sem ser prejudicado pelo que lembra?".
FONTES
- arXiv cs.AI | RESEARCH | score 95 | PRIMÁRIA - MemTrapBench: Benchmarking Cognitive Traps in LLM Memory Use — arXiv:2608.20202v1 (https://arxiv.org/abs/2608.20202)