
Método detecta viés em LLMs pelos estados ocultos do modelo
Técnica mede o Representational Bias Shift dentro do modelo e acompanha a mudança de viés na saída em 15 de 18 cenários testados
O que aconteceu
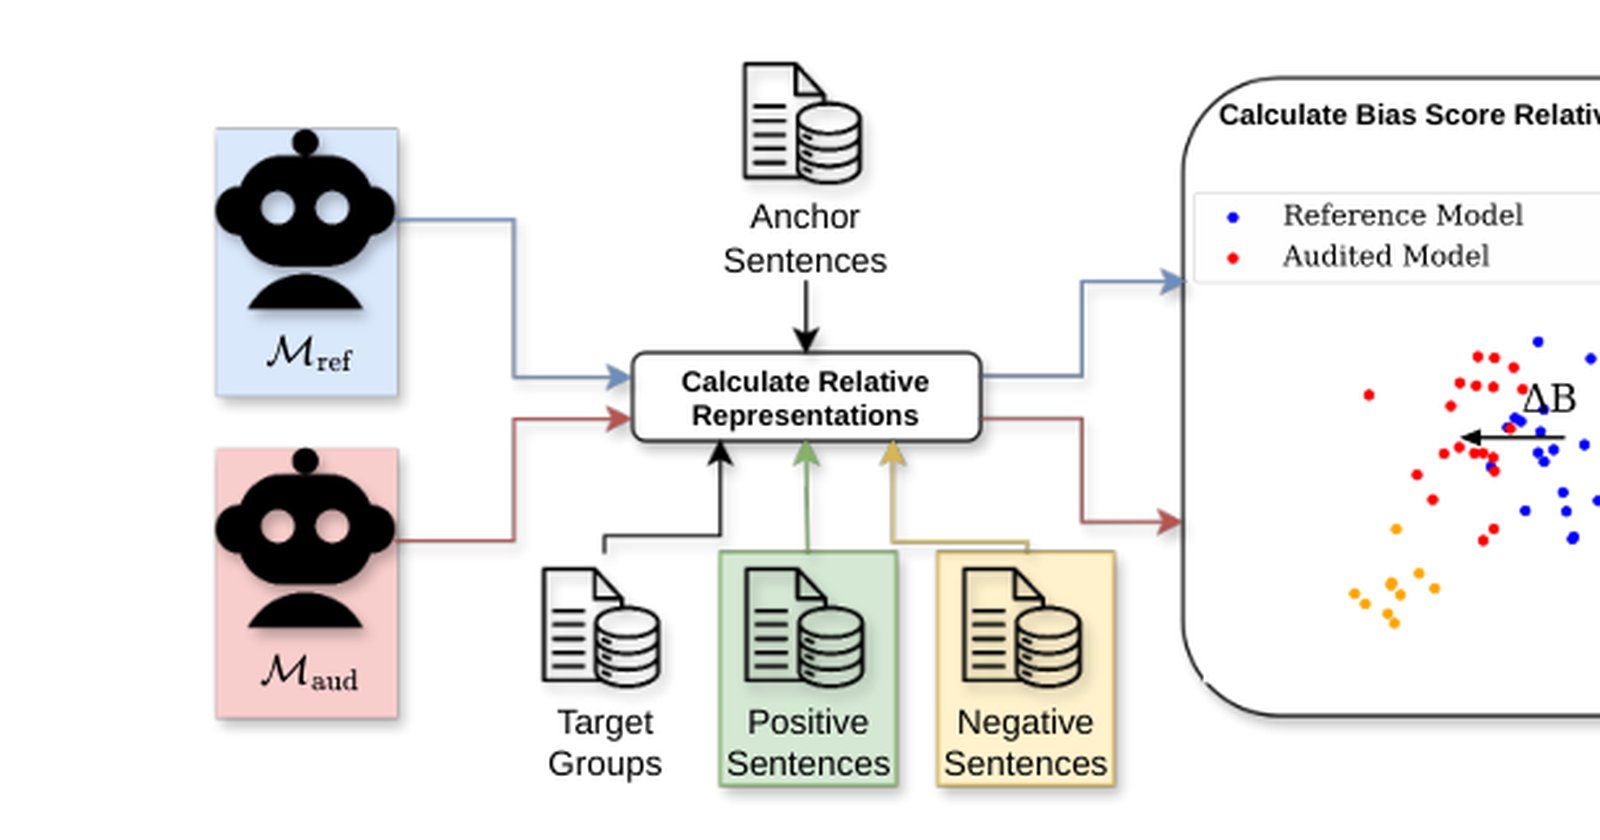
O artigo "Reference-Based Bias Detection in LLMs via Relative Representations of Hidden States" foi submetido ao arXiv em 9 de setembro de 2026, sob o identificador arXiv:2609.10060v1. A proposta audita viés dentro do próprio modelo, e não no texto que ele produz. O método, batizado de Representational Bias Shift (ΔB), compara as representações internas de variantes relacionadas de um mesmo modelo, por exemplo antes e depois de um fine-tuning.
O Representational Bias Shift (ΔB), medida central do artigo, calcula o quanto grupos-alvo se deslocam na associação com atributos positivos e negativos dentro de um espaço de comparação compartilhado. Os testes cobriram três famílias de modelos e três benchmarks: WildGuardMix, DecodingTrust e ToxiGen. O ΔB acompanhou a mudança de viés observada na saída em 15 dos 18 cenários testados, com |r| = 0,84 (p < 0,001) em fine-tuning completo. Sob adaptação eficiente em parâmetros, a correlação ficou mais dependente do modelo.
Aplicado como limiar, o ΔB identificou checkpoints cujo viés aumentou com ROC AUC entre 0,65 e 0,99. Nos benchmarks WildGuardMix e DecodingTrust, o método separou esses checkpoints melhor do que uma linha de base baseada em SEAT nas três famílias testadas. O artigo também relata que o ΔB se mantém estável quando mudam o conjunto de frases-âncora, os conjuntos de atributos e os templates dos grupos-alvo.
Contexto
Os métodos de auditoria de viés disponíveis hoje partem da saída do modelo. Isso exige benchmarks caros ou modelos juízes, e pode deixar passar mudanças internas que nunca chegam a aparecer no texto gerado. O artigo ataca essa limitação.
O obstáculo técnico é a incomparabilidade. O fine-tuning remodela a geometria das representações, então estados ocultos absolutos não são diretamente comparáveis entre duas versões do mesmo modelo. A solução proposta codifica cada frase pela similaridade dela com um conjunto fixo de frases-âncora. O resultado são representações relativas em um espaço comum, onde os deslocamentos podem ser medidos e comparados.
Por que importa
A auditoria por saída custa caro e depende de dados específicos de tarefa. O método descrito no artigo dispensa esses dados. Segundo os autores, o ΔB audita um modelo em cerca de três minutos, com 3 a 50 vezes menos computação do que os benchmarks de saída considerados no trabalho.
Para times que fazem fine-tuning com frequência, isso muda o momento da checagem. Em vez de rodar uma bateria de testes só depois que o modelo está pronto, dá para inspecionar o checkpoint logo após cada rodada de treino e decidir se ele deve ou não seguir adiante.
Impacto
Quem ajusta modelos ganha velocidade na triagem. Um filtro que roda em minutos e não pede dados de tarefa pode ser usado antes da avaliação pesada, deixando os benchmarks de saída para as versões que passaram pelo corte.
O ganho tem limite claro. O método não substitui a auditoria de saída, e os próprios autores o descrevem como complementar, não como substituto. Além disso, a correlação mais fraca sob adaptação eficiente em parâmetros reduz a confiabilidade justamente na modalidade de ajuste mais enxuta. Em fine-tuning completo, o desempenho é o mais forte do estudo.
O que muda
Uma métrica que roda em minutos e não precisa de dados de tarefa abre espaço para virar primeira etapa de um pipeline de auditoria, com os benchmarks de saída reservados para a etapa final. O desenho relativo, ancorado em frases fixas, também permite comparar versões de um mesmo modelo ao longo do tempo, algo útil em times que fazem várias rodadas de ajuste sobre a mesma base.
O método foi testado em três famílias de modelos, e a estabilidade sob troca de âncoras, atributos e templates é um dos pontos que os autores destacam. Isso reduz o risco de a métrica medir o artefato do conjunto de teste em vez do viés do modelo.
O que vem agora
O material não anuncia liberação de código nem indica prazo de revisão por pares. O artigo foi submetido em 9 de setembro de 2026 e é um preprint do arXiv, sem aval de conferência ou periódico divulgado até aqui.
O caminho que os próprios autores apontam é a combinação das duas abordagens: o ΔB como sinal interno, rápido e barato, e a auditoria de saída como confirmação. Para quem trabalha com modelos ajustados sob medida, a pergunta prática passa a ser quanto do trabalho de checagem pode migrar para o começo do processo.
FONTES
- arXiv cs.AI: Reference-Based Bias Detection in LLMs via Relative Representations of Hidden States (arXiv:2609.10060v1), submetido em 9 de setembro de 2026. https://arxiv.org/abs/2609.10060