
MINT: método corrige desequilíbrio em treino de IA com múltiplos objetivos
Nova abordagem de seleção de preferências prioriza equilíbrio entre objetivos treinados.
O que aconteceu
Em 14 de agosto de 2026, uma equipe de pesquisa publicou o artigo "MINT: Min-Selection Preference Distillation for Balanced Multi-Objective Alignment" na plataforma de preprints arXiv (arXiv cs.AI). O trabalho introduz uma mudança técnica simples, mas significativa, no método de treinamento de modelos de linguagem que precisam alinhar-se a mais de um objetivo.
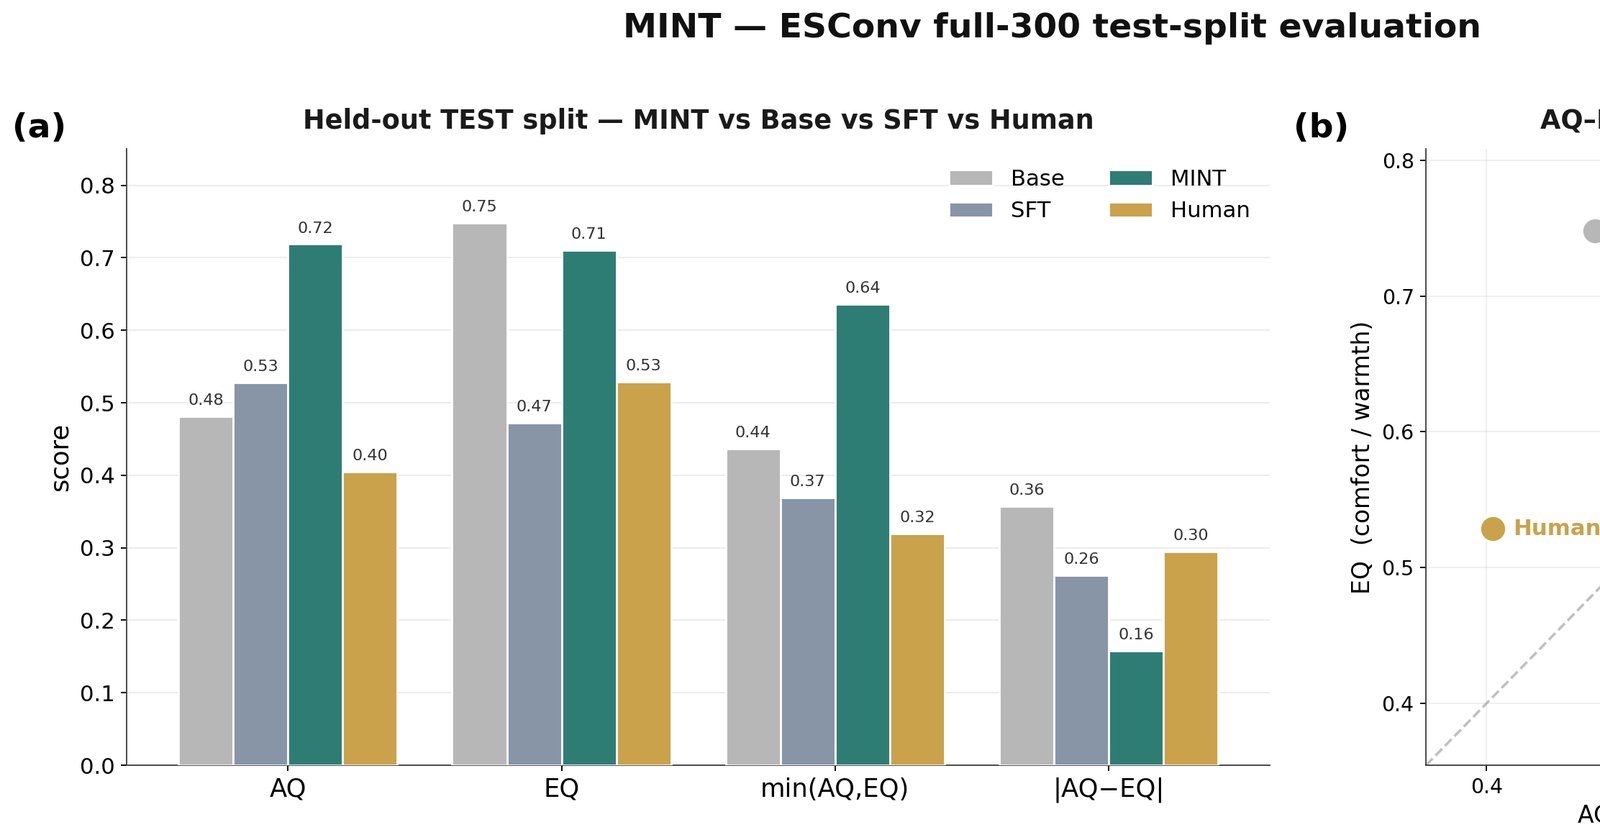
O método MINT (MIN-selection preference disTillation) altera a etapa de "preference distillation". No lugar de classificar as respostas candidatas do modelo por uma soma ponderada de recompensas (o método aditivo padrão), o MINT as classifica pelo seu "objetivo mais fraco". Isso força o processo a preferir o candidato mais equilibrado ao invés do mais enviesado.
Os resultados em cenários de suporte emocional e negociação adversarial mostram um ganho claro. No teste de suporte emocional, o desempenho do eixo mais fraco saltou de uma pontuação de 0.37 para 0.64 (com p < 10^-40), superando até o desempenho de especialistas humanos. A análise passo a passo da conversa mostrou que o benefício se mantém durante toda a interação, enquanto o desequilíbrio persistir.
Contexto
O alinhamento de agentes de IA com múltiplos objetivos é um desafio persistente no treinamento baseado em preferências. Quando as recompensas são somadas de forma aditiva, o processo de otimização tende a "colapsar" na direção do objetivo que é mais barato ou fácil de melhorar.
O artigo cita o exemplo de um agente de suporte: ele aprende a soar caloroso (o objetivo mais fácil) enquanto dá respostas sem utilidade real (o objetivo mais difícil), porque a recompensa aditiva não contém uma noção de equilíbrio. O MINT foi desenhado como uma resposta direta a esse "modo de falha persistente".
Por que importa
A técnica resolve um problema prático que afeta a confiabilidade dos agentes de IA em aplicações do mundo real. Em situações como atendimento ao cliente, suporte médico ou mediação, um modelo que foca apenas em uma faceta da tarefa — como a gentileza — e ignora a eficácia, torna-se inútil ou até prejudicial.
O MINT oferece uma correção computacionalmente simples (uma "mudança de uma linha") para promover equilíbrio intrínseco entre objetivos. Isso pode melhorar significativamente a utilidade e a segurança de sistemas que precisam equilibrar demandas múltiplas e por vezes conflitantes.
Impacto
No curto prazo, a publicação oferece uma nova abordagem concreta para pesquisadores e engenheiros que lidam com treinamento de agentes multiobjetivo. A promessa de melhorar simultaneamente dois objetivos sem aumentar a complexidade do treinamento é atraente.
No médio prazo, se validada, a técnica pode influenciar como os grandes modelos de linguagem (LLMs) são treinados para tarefas complexas que exigem equilíbrio, potencialmente reduzindo a necessidade de compensações manuais ou ajustes pós-treinamento para corrigir desequilíbrios.
O que muda
O achado central muda a métrica de seleção no "preference distillation". Ao priorizar o desempenho no pior caso (o eixo mais fraco) em vez da média, o MINT corrige o desequilíbrio "em proporção à desproporção da política de referência". Isso estabelece um vínculo direto entre o problema e a solução.
A análise do artigo também indica que o benefício não é um efeito temporário do treinamento: ele se mantém durante a interação multi-turno, desde que o desequilíbrio de fundo da política original persista.
O que vem agora
O próximo passo natural é a experimentação mais ampla. Os resultados em "suporte emocional cooperativo" e "negociação adversarial" são promissores, mas a técnica precisa ser testada em outros domínios e com arquiteturas de modelos mais diversas.
Outra questão aberta é a escalabilidade e o comportamento do MINT quando o número de objetivos aumenta além de dois. O artigo o descreve como o "limite p para menos infinito de uma família de médias generalizadas", o que sugere uma base matemática robusta para possíveis extensões.
Fontes
- arXiv cs.AI (2026-08-14). *MINT: Min-Selection Preference Distillation for Balanced Multi-Objective Alignment*. https://arxiv.org/abs/2608.14828