
Modelos de difusão para IA de borda: survey mapeia alternativa aos LLMs
Estudo publicado no arXiv analisa como DLMs podem rodar agentes de IA em dispositivos móveis com menos latência e banda
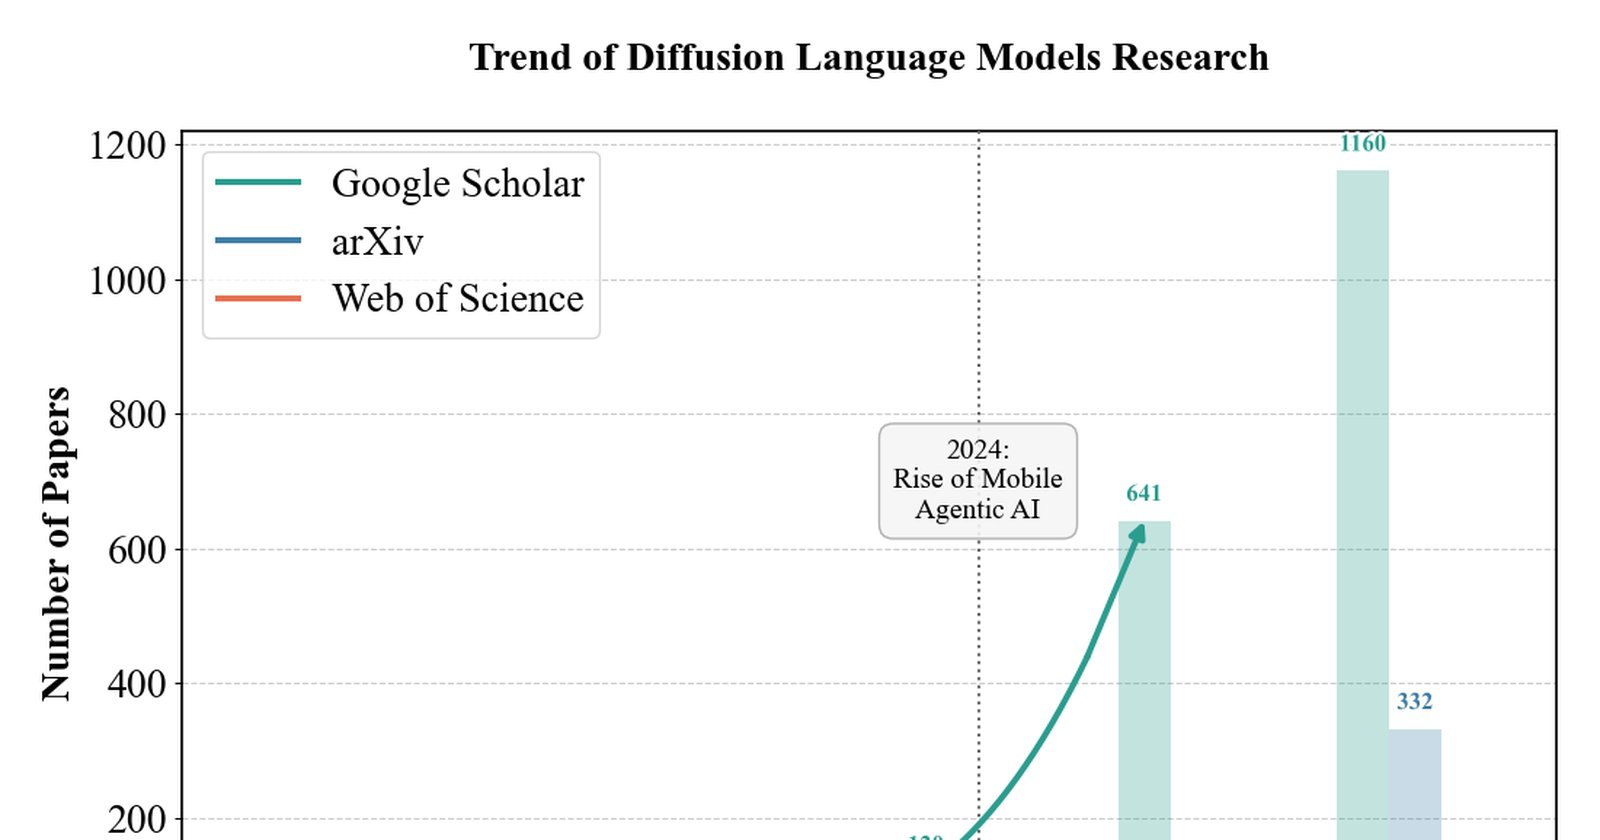
O que aconteceu
O repositório arXiv publicou, em 4 de setembro de 2026, o artigo "Diffusion Language Models for Mobile Edge Agentic AI: Foundations, Applications, and Challenges", um survey sobre modelos de linguagem por difusão (DLMs, na sigla em inglês) aplicados à inteligência artificial agêntica na borda móvel. O material foi anunciado como novo registro na categoria de Inteligência Artificial (cs.AI) do arXiv, com o número 2609.04778v1.
O texto central do survey é uma tese direta: os DLMs refinam tokens por meio de denoising iterativo, em vez de decodificar da esquerda para a direita como fazem os grandes modelos de linguagem (LLMs) baseados em Transformers autorregressivos. Segundo o abstract, essa abordagem permite atualizar múltiplos tokens incertos em paralelo e explorar contexto bidirecional durante toda a geração, o que abre margem para trade-offs mais flexíveis entre qualidade e latência.
Contexto
Os LLMs dominantes hoje funcionam de forma sequencial: cada token é gerado dependendo do anterior, um processo fixo que limita como o sistema pode equilibrar velocidade e qualidade. Os DLMs atacam exatamente esse gargalo. Em vez de prever o próximo token, o modelo parte de uma versão ruidosa do texto e vai refinando iterativamente, o que permite correções guiadas por restrições e saída antecipada (early exit) quando a resposta já está boa o suficiente.
O survey conecta essas propriedades de modelagem (bidirecionalidade, refinamento paralelo, controlabilidade e elasticidade qualidade-latência) aos requisitos de sistema da inteligência de borda móvel do futuro. O argumento dos autores é que agentes de IA rodando em celulares, dispositivos IoT e redes sem fio operam sob restrições que data centers não enfrentam: latência, memória, energia, banda, privacidade e confiabilidade.
Por que importa
Para quem constrói produtos de IA, a diferença é prática. O survey indica que refinamento parcial, early exit e correção por restrições podem reduzir o atraso de resposta e o overhead de comunicação, além de melhorar a robustez em contextos ruidosos, incompletos ou dinâmicos. Em um agente que roda no celular e conversa com a nuvem, menos tokens trafegando significa menos banda consumida e menos exposição de dados do usuário.
A cobertura do artigo é ampla: arquiteturas eficientes em recursos, aceleração de treinamento e inferência, compressão, implantação em borda e nuvem, serving consciente de comunicação, aplicações em IoT e redes sem fio, e avaliação de agentes baseados em DLMs. É um mapa do estado da arte para equipes que avaliam se vale migrar partes da inferência do data center para o dispositivo.
Impacto
No curto prazo, o survey serve como referência acadêmica para orientar pesquisas em IA de borda, área que cresce com a pressão por privacidade e custo de nuvem. Os autores apontam problemas em aberto que definem a agenda da área: gestão de estado em contextos longos, inferência dividida (split inference) entre dispositivo e servidor, execução confiável, grounding multimodal e benchmarking reproduzível.
O último ponto merece destaque. Sem benchmarks reproduzíveis, fica difícil comparar DLMs e LLMs autorregressivos em condições reais de borda, e o survey explicita essa lacuna. Para a indústria, a mensagem é que a alternativa não autorregressiva existe e tem propriedades teóricas vantajosas, mas ainda depende de resolver questões de engenharia e de avaliação padronizada.
O que muda
A mudança conceitual é a saída do paradigma de decodificação sequencial como única opção. O documento do arXiv estabelece que os modelos de difusão podem oferecer qualidade-latência ajustável, algo que a decodificação sequencial fixa dos Transformers não proporciona. Isso muda o desenho de sistemas: um agente de borda pode, por exemplo, interromper o refinamento cedo para responder rápido ou continuar iterando quando a tarefa exigir precisão.
O que vem agora
O artigo é um survey, então não anuncia produto nem prazo de lançamento. O caminho indicado pelos próprios autores passa por avançar nos cinco problemas abertos listados: contexto longo, split inference, execução confiável, multimodalidade e benchmarks. Quem acompanha a área deve monitorar citações e trabalhos derivados do registro 2609.04778 no arXiv, além de implementações práticas de DLMs em dispositivos com restrição de recursos.