
MolEmb: MLLMs viram base para embeddings moleculares em IA
Framework alinha moléculas e linguagem natural; benchmark MolCAR revela papel dos dados
O que aconteceu
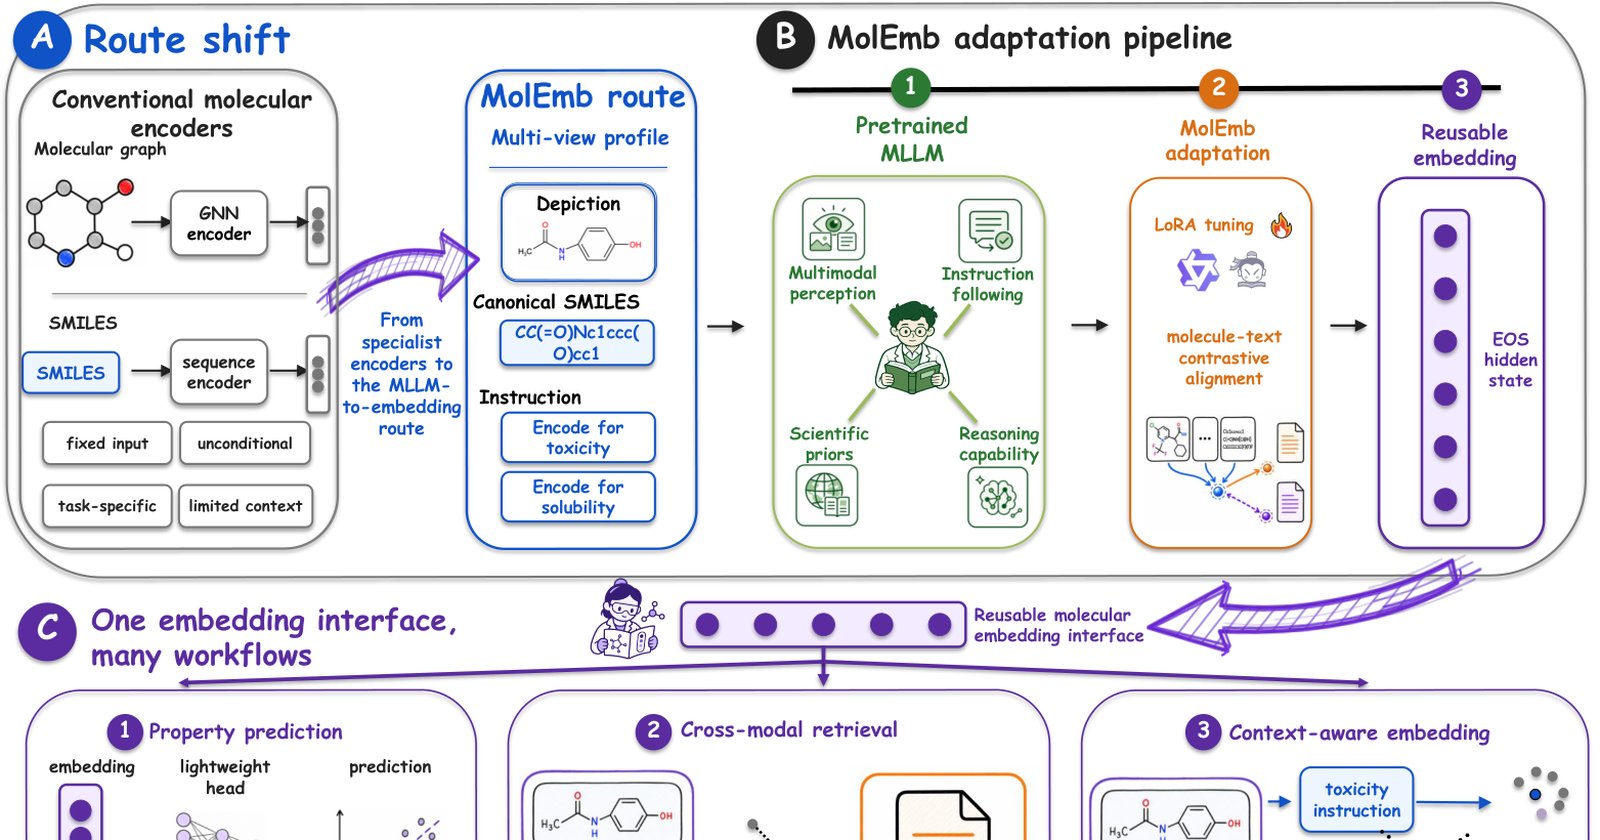
Um grupo de pesquisadores submeteu o artigo "MolEmb: Multimodal Large Language Models Can Be Strong Molecular Embedding Models" ao arXiv em 24 de agosto de 2026, com código 2608.23646. O trabalho propõe o MolEmb, um framework leve que adapta MLLMs para gerar embeddings moleculares condicionados a um perfil químico e a um contexto semântico em linguagem natural. A abordagem usa um objetivo contrastivo bidirecional para alinhar perfis moleculares com descrições textuais em um espaço vetorial compartilhado. Os autores também introduziram o MolCAR, um benchmark diagnóstico para recuperação sensível ao contexto, e concluíram que a capacidade de embeddings contextuais é principalmente uma propriedade dos dados de supervisão.
O MolEmb, como framework, foi testado em previsão de propriedades moleculares e mostrou desempenho competitivo. O sistema também permite recuperação cruzada entre moléculas e texto no mesmo espaço, algo que modelos especialistas tradicionais não oferecem com interface de linguagem. O estudo está disponível na categoria cs.AI do arXiv.
Contexto
Modelos de embedding molecular servem como infraestrutura fundacional para química computacional e descoberta de medicamentos. Esses vetores reutilizáveis ajudam em previsão de propriedades, triagem virtual e recuperação de compostos. Historicamente, os encoders de moléculas foram construídos como modelos especialistas, que operam sobre uma única representação molecular e geram vetores incondicionais, sem uma interface de linguagem para variar o que é representado. Essa limitação dificulta a adaptação do embedding a tarefas ou contextos específicos.
O MolEmb, lançado em 2026, parte da ideia de que MLLMs, que processam imagens, texto e entradas simbólicas nativamente, podem servir como modelos gerais de embedding. A equipe, cuja autoria não foi detalhada no resumo, alinhou essas capacidades usando um objetivo contrastivo no espaço compartilhado.
Por que importa
A proposta pode reduzir a dependência de modelos especialistas isolados na química computacional. Em vez de treinar um encoder para cada tarefa, um único sistema baseado em MLLM pode produzir embeddings que variam com a consulta em linguagem natural. Isso potencialmente acelera fluxos de trabalho em triagem virtual e recuperação de compostos, além de simplificar a integração com ferramentas de IA que já usam linguagem.
O MolCAR, benchmark introduzido no artigo, fornece uma forma de medir quão bem o modelo entende o contexto da consulta. Essa métrica ajuda a comunidade a comparar futuros sistemas.
Impacto
No curto prazo, o framework pode ser usado por grupos de pesquisa que trabalham com bancos de dados de moléculas e precisam de representações flexíveis. A capacidade de recuperar moléculas por descrição em texto abre espaço para busca semântica em bibliotecas químicas. No médio prazo, se os resultados forem replicados, laboratórios farmacêuticos podem integrar esse tipo de embedding em pipelines de descoberta, reduzindo etapas de engenharia de features.
A descoberta de que o comportamento contextual depende mais da supervisão do que do modelo sugere que avanços futuros virão de dados de treinamento mais ricos, não só de arquiteturas novas.
O que muda
Para quem atua em IA para química, o artigo muda a expectativa sobre o papel dos MLLMs. Em vez de usá-los apenas como assistentes ou geradores de texto, eles podem ser a base de representações moleculares. Isso significa que modelos grandes já existentes podem ser adaptados com camadas leves para tarefas de embedding, em vez de exigir treinamento de modelos específicos do zero.
O que vem agora
Os autores não anunciaram publicações de código ou datasets no resumo. A expectativa é que o MolCAR e o framework sejam disponibilizados em repositórios como GitHub ou Hugging Face nos próximos meses, seguindo a prática comum da área. A comparação do MolEmb com encoders clássicos em benchmarks maiores deve aparecer em versões revisadas do artigo.