
MoNe: Memória Neural Modular para Long Context em Transformers
Sistema leve acoplado a modelos congelados promete inferência eficiente sem retreinamento.
O que aconteceu
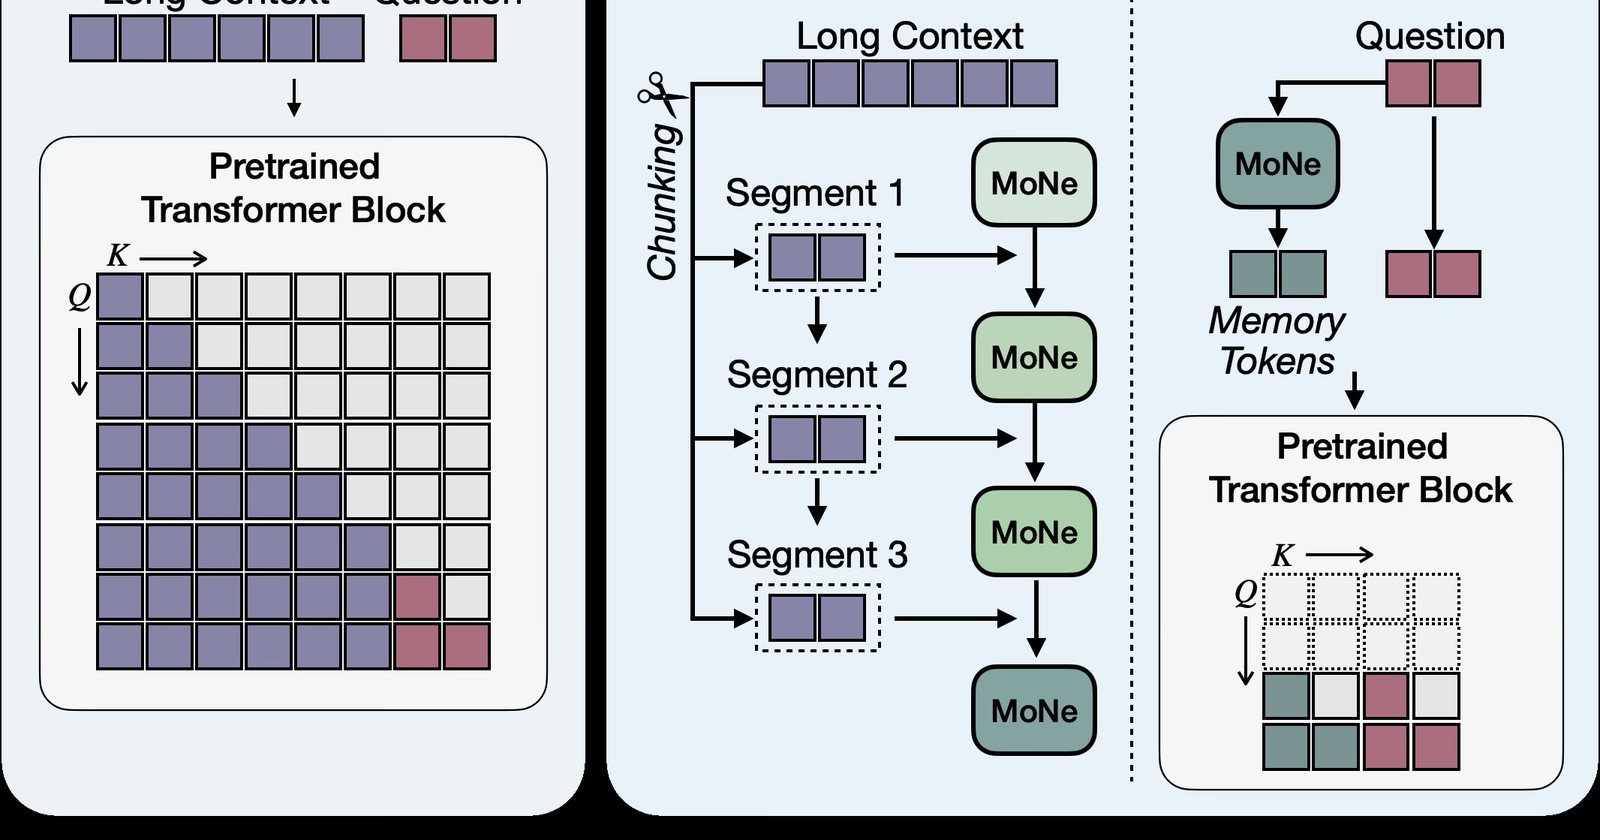
Em 18 de agosto de 2026, um novo estudo intitulado "MoNe: Modular Neural Memory for Efficient Long Context Inference" foi divulgado no arXiv, conforme registros do repositório. O sistema MoNe é descrito como uma memória neural leve e modular que se acopla a qualquer Transformer pré-treinado congelado, viabilizando a inferência com contextos longos sem retreinamento. O método utiliza aprendizado em tempo de teste para ler o contexto em segmentos de tamanho fixo, com atualizações de gradiente localizadas por camada. Durante a inferência, a memória gera chaves e valores a partir dos tokens de consulta, sem reread dos tokens de contexto.
Os resultados numéricos são diretos: em contextos de 128 mil tokens, o MoNe reduz tanto o custo computacional quanto a memória de pico da GPU em aproximadamente 80% em comparação com o In-Context Learning (ICL) padrão, com uma sobrecarga de parâmetros de apenas 6,4%. Além disso, a arquitetura divide o custo de inferência em duas fases, alcançando um custo de pré-processamento de O(N) e de consulta de O(1), com a memória de GPU não crescendo proporcionalmente ao comprimento do contexto N.
Contexto
Transformers, base da maioria dos modelos de linguagem atuais, possuem janelas de contexto fixas que limitam o processamento de textos longos, como documentos ou conversas extensas. Estender essas janelas tradicionalmente exige retreinamento caro ou métodos como o ICL, que aumentam custos computacionais e de memória à medida que o contexto cresce. O MoNe surge como uma alternativa modular, visando contornar essas restrições sem alterar os modelos base.
Por que importa
Para empresas e desenvolvedores de IA, o MoNe representa uma ferramenta para reduzir custos de operação em aplicações que requerem processamento de longos textos, como análise de documentos, assistentes virtuais e sistemas de busca. A sobrecarga mínima de parâmetros (6,4%) e a eficiência comprovada em benchmarks, como o RULER, onde supera o ICL em tarefas de extração de agulhas em palheiros, indicam potencial prático para integração em modelos existentes sem retrabalho significativo.
Impacto
No curto prazo, o MoNe pode acelerar a adoção de soluções de IA com contextos longos ao diminuir barreiras de hardware. Empresas com orçamentos limitados para GPUs de alta gama poderiam implantar modelos mais capazes. A médio prazo, isso pode impulsionar inovações em setores como saúde, jurídico e educacional, onde a análise de textos extensos é comum, ao passo que reduz a dependência de retreinamentos frequentes.
O que muda
A abordagem modular do MoNe altera a forma como se pensa em extensão de contexto para Transformers. Em vez de modificar a arquitetura base, ele acoplamento externo permite flexibilidade, podendo ser aplicado a diferentes modelos congelados. Isso simplifica atualizações e mantém compatibilidade com ecossistemas existentes, mudando a dinâmica de desenvolvimento e deploy de modelos de IA.
O que vem agora
Como estudo inicial publicado no arXiv, os próximos passos prováveis incluem validação em cenários reais, otimização do código para uso amplo e investigação de integração com frameworks de IA populares. A comunidade de pesquisa pode explorar variações do MoNe para outros tipos de modelos ou tarefas específicas, enquanto empresas poderão testar sua aplicabilidade em protótipos.