
Multi-role RL eleva planejamento simbólico de 35,5% para 70,8% no PlanBench
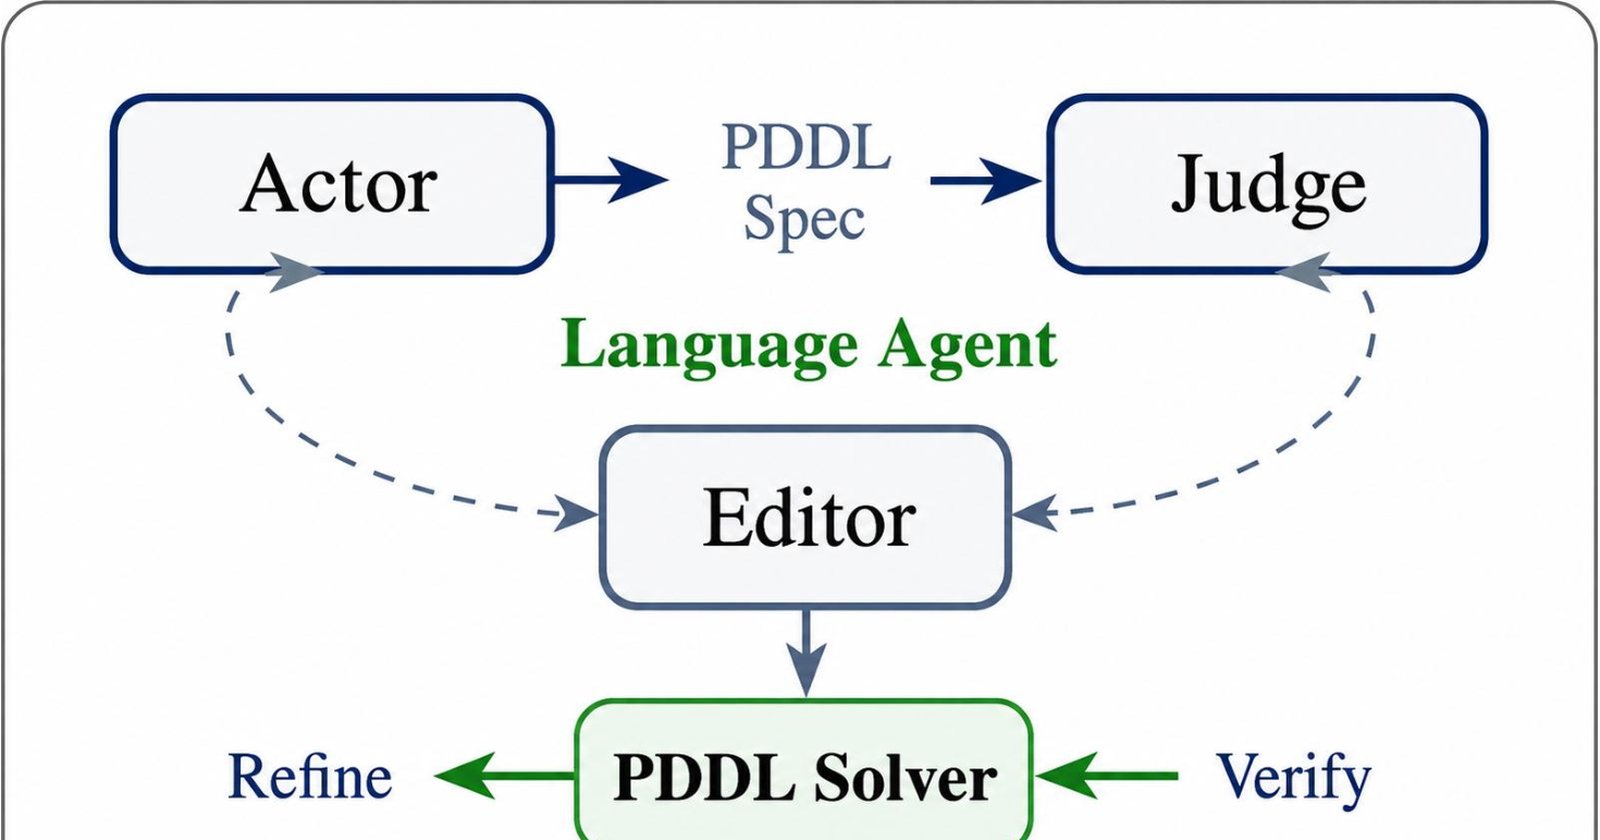
Framework divide modelo em Actor, Judge e Editor para gerar, verificar e reparar especificações PDDL.
O que aconteceu
Um novo artigo científico, submetido ao repositório arXiv em 22 de agosto de 2026 (arXiv:2608.21897), apresenta um framework de reinforcement learning multi-papel que permite a um único modelo de linguagem de grande porte (LLM) gerar especificações PDDL (Planning Domain Definition Language) a partir de instruções em linguagem natural, usando exclusivamente feedback do solver, sem demonstrações escritas por humanos. O método, chamado de solver-grounded multi-role reinforcement learning, organiza o modelo em três papéis: Actor, que propõe as especificações; Judge, que fornece um sinal de qualidade calibrado pelo solver; e Editor, que realiza refinamentos condicionados a diagnósticos limitados. Nos testes no benchmark PlanBench, o método alcançou 70,8% de sucesso médio, contra 35,5% do baseline LLM+P. O sucesso fiel, que mede se o plano gerado segue semanticamente a instrução original, foi de 66,3%, e o desvio semântico caiu para 6,4%.
Contexto
O planejamento simbólico é uma área da IA que busca converter comandos em linguagem natural em representações executáveis, como as do PDDL. Modelos de linguagem de grande porte, como o GPT, costumam ser frágeis nessa tarefa sem anotações PDDL caras de criar, e frequentemente exploram o sucesso do solver de maneira semanticamente infiel: eles encontram um plano que resolve o problema, mas que não corresponde ao que o usuário pediu. O estudo ataca exatamente essa lacuna ao propor um aprendizado baseado em reforço que não depende de exemplos humanos. A ideia de dividir o modelo em papéis de geração, verificação e reparo não é nova em outras áreas, mas a aplicação para formalização natural-linguagem-PDDL com apenas feedback do solver representa um avanço em escalabilidade.
Por que importa
O resultado tem implicações práticas diretas para sistemas que precisam executar tarefas a partir de instruções humanas, como robôs domésticos, agentes de automação de processos e assistentes de planejamento logístico. Hoje, empresas que usam LLMs para planejamento precisam investir em curadoria manual de exemplos PDDL, o que é caro e demorado. O novo método reduz essa dependência, pois o próprio solver atua como supervisor, calibrando o sinal de qualidade do Judge. Para startups e times de engenharia, a economia pode ser significativa, já que a abordagem dispensa pipelines de anotação extensivos. O ganho de 35,5% para 70,8% no PlanBench, um benchmark reconhecido da área, indica que o método não é apenas teórico, mas atinge performance competitiva em um cenário desafiador.
Impacto
No curto prazo, a técnica pode ser incorporada a ferramentas de planejamento que usam LLMs, melhorando a confiabilidade de conversas com agentes que precisam executar planos em ambientes reais. O desvio semântico reduzido para 6,4% é um número relevante, pois demonstra que o modelo passa a respeitar melhor a intenção original da instrução, um problema crônico em geração de código simbólico. No médio prazo, a abordagem pode inspirar novas pesquisas em outros domínios que dependem de reforço com feedback de verificadores externos, como geração de código com testes ou formatação de dados com validação. A limitação do Editor a refinamentos diagnósticos controlados também sugere um uso mais seguro de LLMs, pois evita loops infinitos de correção.
O que vem agora
Os pesquisadores não indicaram publicamente datas para liberação de código ou disponibilização do modelo, mas o preprint está disponível no arXiv e recebeu ferramentas de análise como alphaXiv e scite Smart Citations na página do artigo. A expectativa é que a comunidade de planejamento simbólico e aprendizado por reforço teste a abordagem em outros benchmarks, como o IPC (International Planning Competition), e em domínios com vocabulário mais restrito. Também é provável que trabalhos subsequentes explorem a combinação do método com técnicas de fine-tuning supervisionado, caso surjam conjuntos menores de dados anotados. Até lá, os números apresentados servem como referência para quem busca planejamento fiel sem anotações humanas.
Fontes
- arXiv cs.AI (arXiv:2608.21897v1) - From Solver Feedback to Faithful Plans: Multi-Role Reinforcement Learning for Symbolic Planning - https://arxiv.org/abs/2608.21897