
Nova métrica mensura consistência comportacional em agentes de IA
Pesquisa da arXiv apresenta a Behavioral Consistency Metric (BCM) e revela que sistemas com taxa de acerto similar podem agir de formas radicalmente distintas.
O que aconteceu
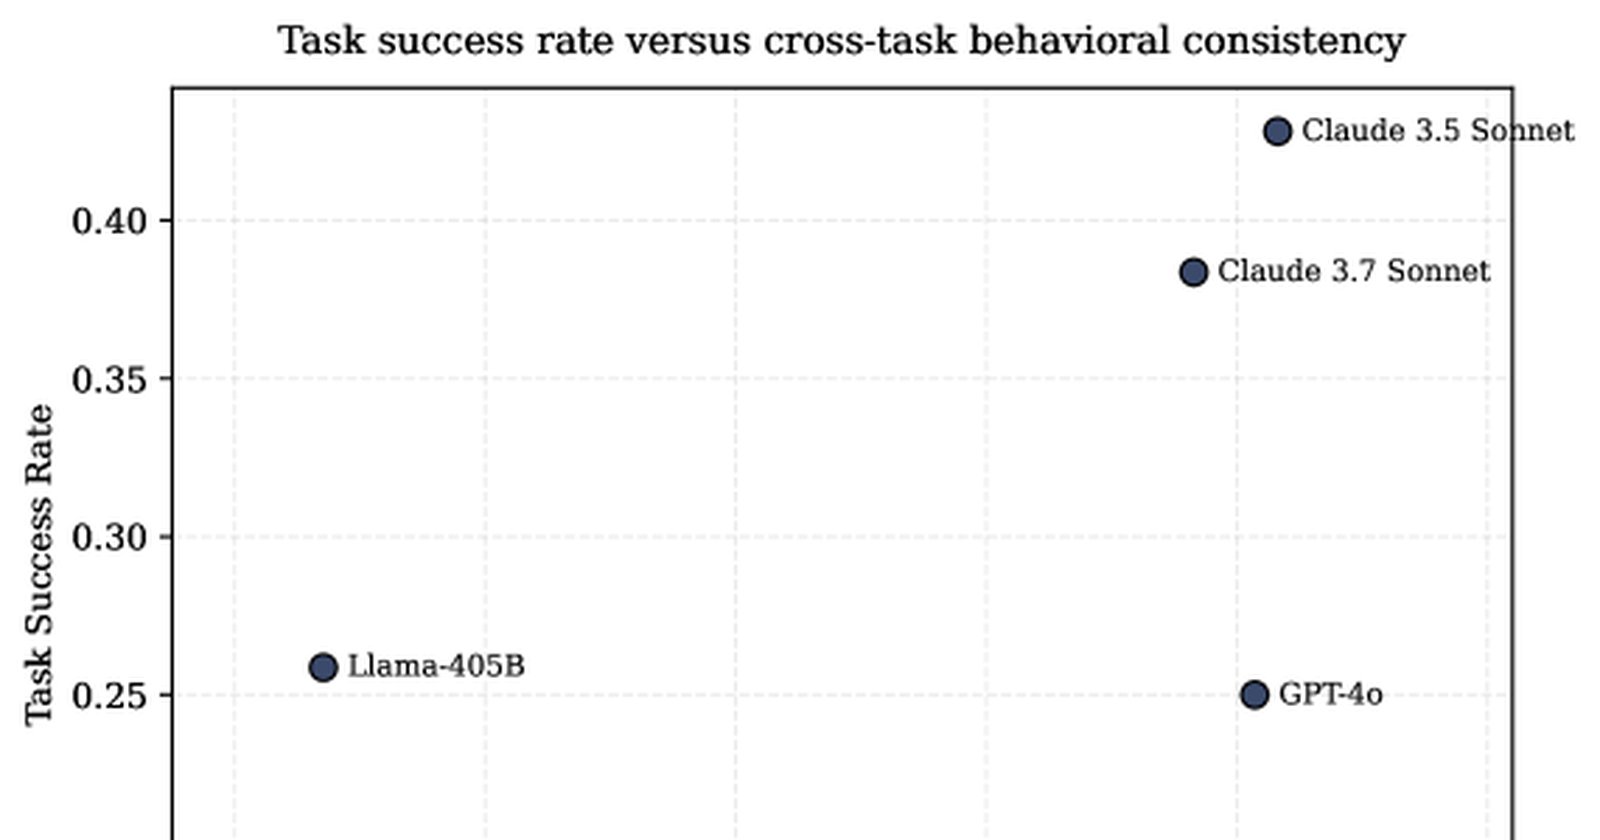
Pesquisadores apresentaram em 31 de julho de 2026, no servidor da arXiv, o artigo "Measuring Cross-Task Behavioral Consistency in Language Model Agents". O trabalho introduz a Behavioral Consistency Metric (BCM), uma nova forma de avaliar agentes de IA. O método treina um modelo para prever o sucesso de uma tarefa a partir de características comportamentais das "trajetórias" de execução do agente. A BCM deriva um vetor de atribuição para cada trajetória e mede a similaridade média entre eles dentro de um mesmo sistema. Em uma análise com aproximadamente 9.000 trajetórias de seis agentes de modelos de linguagem diferentes (LLMs) focados em tarefas de software engineering, o achado central é que a consistência entre tarefas (cross-task) e dentro de uma mesma tarefa (within-task) são eixos distintos que podem divergir.
Contexto
Até agora, a avaliação de agentes de IA depende quase exclusivamente de métricas de resultado, como taxa de sucesso (outcome metrics). Esses números dizem se o agente completou a tarefa, mas não capturam como ele se comportou durante o processo. O trabalho anterior, segundo os autores, só media a reprodutibilidade na mesma tarefa (same-task reproducibility), o que impedia observar a separação entre consistência local e global. A pesquisa posiciona a BCM como um sinal de confiabilidade em nível de processo (process-level reliability) que complementa as métricas de resultado existentes.
Por que importa
Para empresas e desenvolvedores criando agentes de IA para automação de código, suporte técnico ou outras tarefas complexas, a consistência é tão crucial quanto o sucesso. Um agente que resolve 80% das tarefas, mas cada vez de um jeito diferente e imprevisível, é mais difícil de depurar, auditar e manter. A BCM revela que a taxa de sucesso sozinha não é um indicador confiável de consistência. Sistemas com taxas de sucesso comparáveis podem ter níveis de consistência muito diferentes. Além disso, a pesquisa identifica uma "lacuna de consistência" (consistency gap) persistente entre modelos de fronteira (frontier) e de código aberto (open-source), mesmo quando o controle mantém a dificuldade da tarefa constante.
Impacto
De curto prazo, o trabalho força uma revisão de como benchmark de agentes é conduzido. Desenvolvedores não podem mais focar apenas na taxa de acerto; precisam olhar para a estabilidade do processo. Para o mercado, isso pode aumentar a demanda por ferramentas de observabilidade e análise de trilhas de execução (execution traces). Modelos com alta consistência cross-task podem se tornar mais valiosos para aplicações que exigem comportamento previsível e padronizado em domínios variados.
O que muda
A principal mudança é paradigmática: a avaliação de agentes ganha uma nova dimensão. A consistência deixa de ser uma suposição ou um efeito colateral para ser uma propriedade mensurável e distinta do sucesso. O Gap entre modelos frontier e open-source se torna mais nítido sob essa nova lente. Empresas brasileiras que desenvolvem ou integram agentes de IA precisarão considerar essa métrica ao selecionar e ajustar seus sistemas para garantir não apenas eficácia, mas também previsibilidade e confiabilidade operacional.
O que vem agora
Os autores posicionam a BCM como um sinal complementar, não substituto, às métricas existentes. O próximo passo lógico é a incorporação de medidas de consistência comportamental em benchmarks padronizados. Também pode haver um foco maior no desenvolvimento de técnicas de treinamento e ajuste fino (fine-tuning) de agentes não apenas para o sucesso, mas para a estabilidade estratégica entre domíveis de tarefas. A pesquisa abre caminho para uma geração de agentes mais confiáveis e auditáveis.