
Novo DSL Axon elimina lock-in de frameworks em arquiteturas de LLMs
Linguagem fortemente tipada compila modelos uma vez e roda em PyTorch, JAX, MLX e vLLM
O que aconteceu
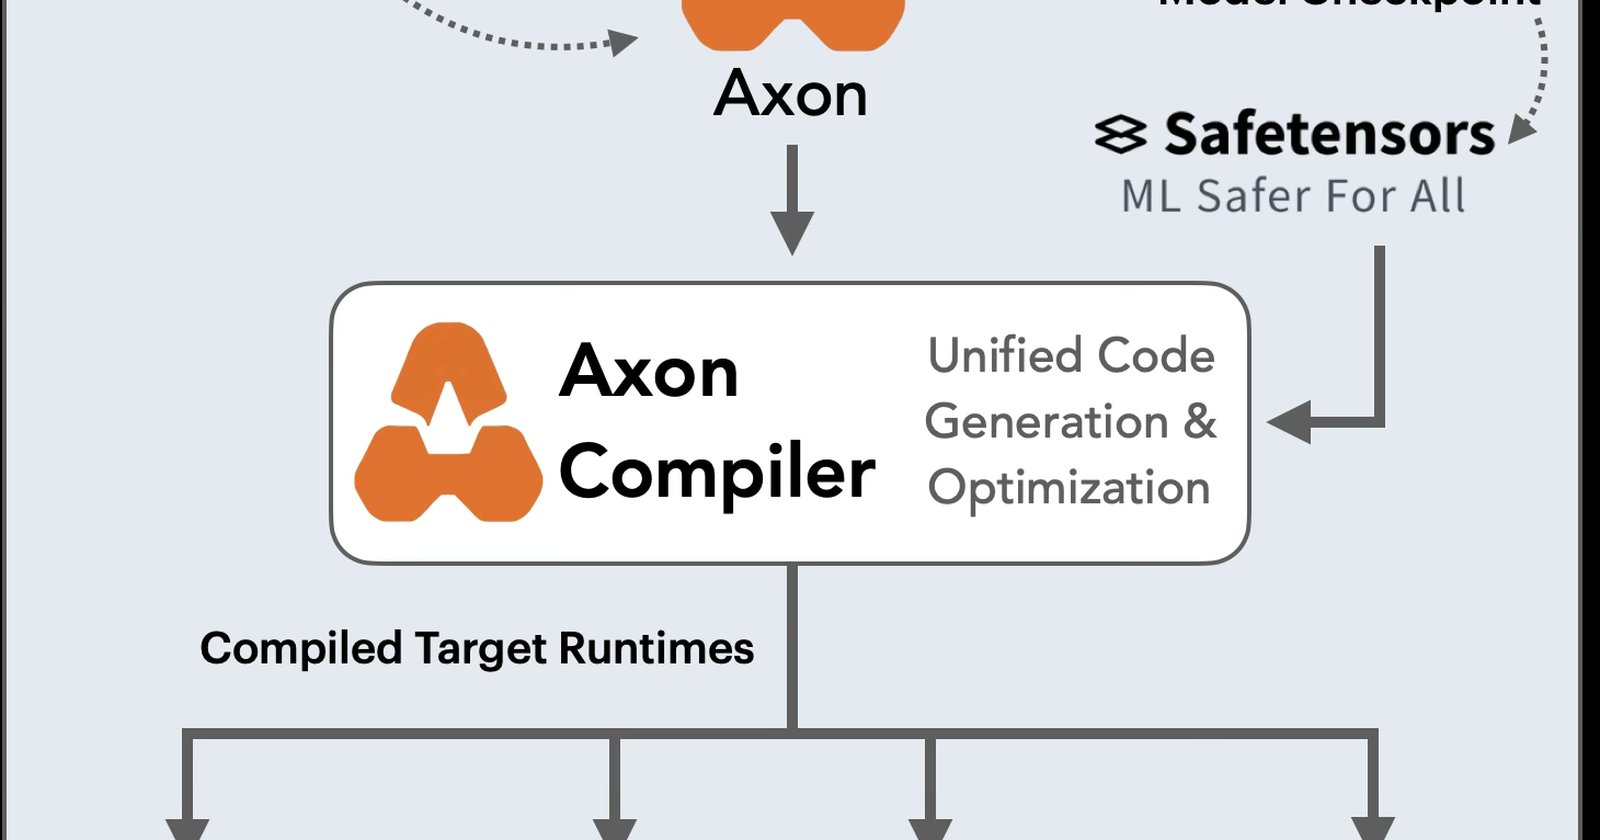
No dia 20 de agosto de 2026, pesquisadores publicaram no arXiv o paper "Write Once, Run Everywhere: The Axon DSL for Shape-Safe and Framework-Agnostic LLM Architectures" (arXiv:2608.19889v1). O documento descreve Axon, uma linguagem de domínio específico (DSL) com sintaxe inspirada em Haskell, voltada para definição de arquiteturas de grandes modelos de linguagem.
Axon compila automaticamente implementações para cinco frameworks: PyTorch, PyTorch com Triton, JAX, MLX e vLLM. Em 467 experimentos de benchmarking de inferência, os resultados mostraram ganhos medianos de 7% no PyTorch, 12% no PyTorch com Triton, 91% no JAX e 107% no MLX em comparação com as implementações de referência do Transformers. No vLLM, com PagedAttention e KV-cache nativos, o speedup mediano foi de 58%.
Contexto
O ecossistema de modelos open-source de linguagem concentra-se hoje em torno de uma única plataforma de referência — o Hugging Face Transformers. Embora seja amplamente adotado, essa centralização cria dois problemas: dependência tecnológica (lock-in) e retrabalho constante ao traduzir arquiteturas entre regimes de treino e inferência.
Segundo os autores, definir e manter implementações eficientes de modelos é uma tarefa que consome muitos recursos e limita a portabilidade. Pesquisadores que querem criar arquiteturas especializadas precisam escolher entre perder infraestrutura de otimização ou se prender a um framework específico.
Axon ataca esse gargalo ao propor uma especificação linguística como base de colaboração, em vez da visão de um único framework. A linguagem é fortemente tipada, o que garante segurança nas formas (shape-safe) dos tensores durante a compilação.
Por que importa
Para equipes de pesquisa e empresas que desenvolvem modelos customizados, Axon elimina a necessidade de reimplementar o mesmo modelo para cada plataforma. Uma única especificação em Axon pode ser exportada para diferentes backends de treino e inferência, reduzindo custos de engenharia e mantendo otimizações específicas de cada framework.
O ganho de desempenho é particularmente relevante para aplicações em produção. Um speedup de 58% no vLLM ou 91% no JAX se traduz diretamente em custos menores de inferência e latência reduzida para usuários finais.
Impacto
No curto prazo, Axon pode acelerar a experimentação acadêmica com arquiteturas alternativas, já que pesquisadores não precisam mais escolher um framework antes de validar uma ideia. No médio prazo, a abordagem framework-agnóstica pode reduzir a dominância de uma única plataforma no ecossistema open-source, distribuindo mais poder entre quem cria os modelos.
Para empresas com infraestrutura multimodal — que operam PyTorch em GPUs e MLX em chips Apple, por exemplo — a portabilidade oferecida por Axon simplifica a manutenção de pipelines de inferência heterogêneos.
O que muda
Se a abordagem ganhar adoção, o trabalho de implementação de novas arquiteturas migra das bibliotecas de frameworks para uma camada de especificação. Isso muda o papel dos desenvolvedores de modelos: menos tempo traduzindo código entre PyTorch e JAX, mais tempo definindo e validando arquiteturas.
O paper também aponta para um futuro onde a colaboração em arquiteturas LLMs não depende de alinhamento com as decisões de roadmap de uma única empresa ou projeto open-source.
O que vem agora
Axon ainda está em fase inicial — o paper é uma publicação recente no arXiv. Os próximos passos incluem ampliação da comunidade de usuários, construção de ferramentas de apoio (debugging, visualização) e possíveis integrações com frameworks adicionais. A aceitação vai depender de se a linguagem consegue cobrir os casos de uso reais de pesquisa e produção em larga escala.