
Novo framework avalia learning harnesses de IA sem dados rotulados
Estudo propõe usar um modelo professor maior como referência para medir a evolução de sistemas menores em tarefas reais.
O que aconteceu
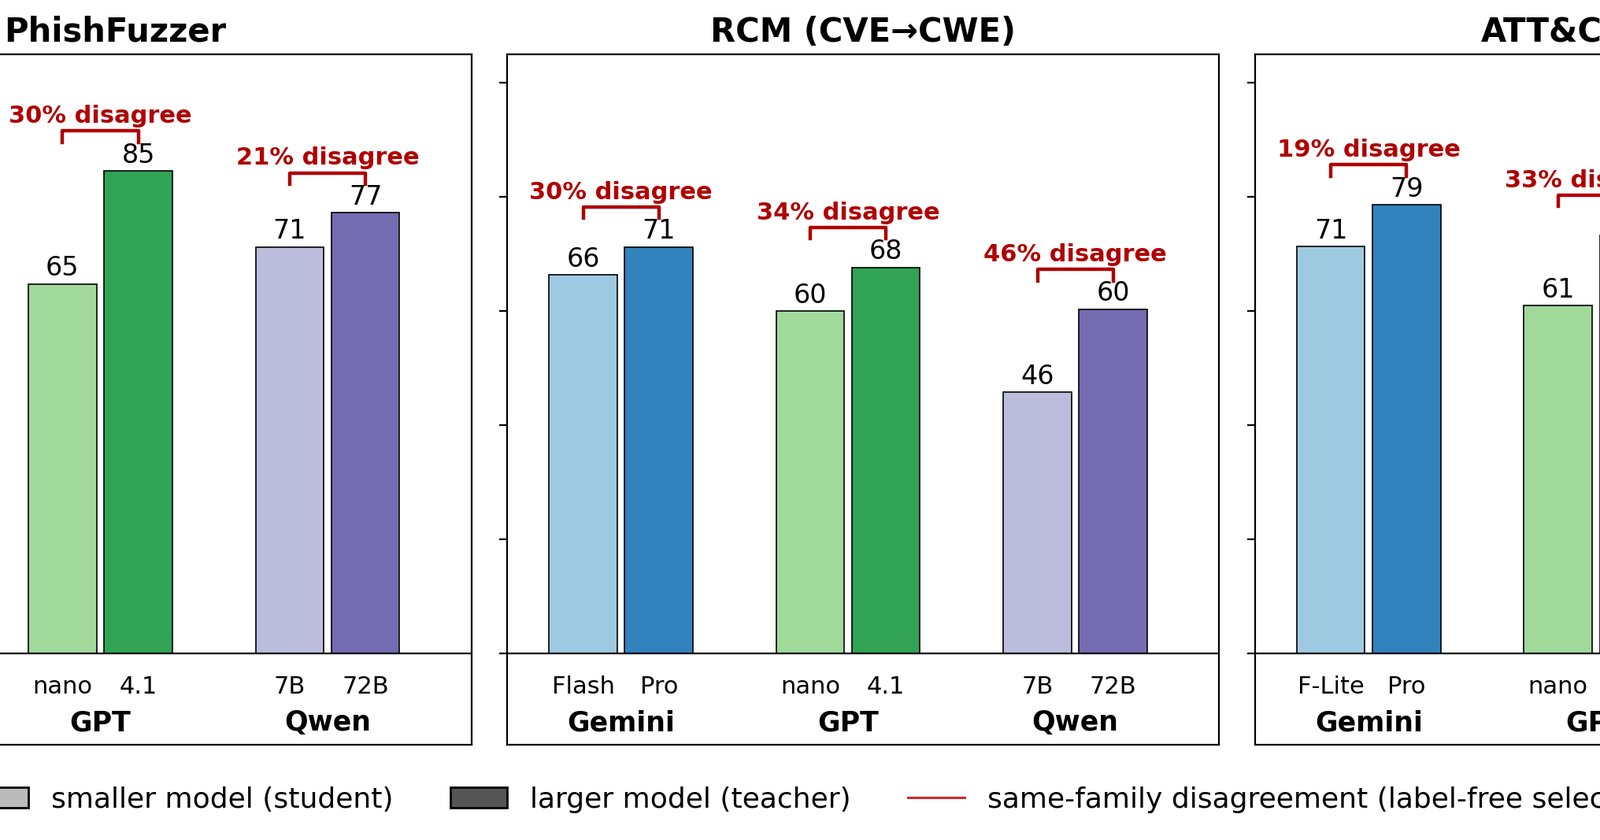
Pesquisadores publicaram um paper no arXiv (11/ago/2026) com o título "Evaluating Agentic Learning Harness Capabilities Without Labels via the Scaling Hypothesis". O estudo apresenta um framework para avaliar "Continual Learning Harnesses" — sistemas que combinam um LLM com memória ou recuperação de dados para aprender com feedback, sem precisar ser retreinados — de forma completa, sem depender de benchmarks com dados rotulados.
O método proposto usa a "hipótese de escalabilidade": um modelo professor maior, mais potente, fornece correções esporádicas a um modelo estudante menor que utiliza o harness. O desempenho do harness é medido pela velocidade com que o estudante se aproxima do desempenho do professor ao longo do tempo. Os testes em tarefas de segurança demonstraram que essa melhoria relativa ao professor se correlaciona com a melhoria em relação a um padrão ouro validado, confirmando a métrica como um proxy eficaz.
Contexto
Sistemas agentic de aprendizado contínuo têm ganhado relevância, especialmente na cibersegurança, por permitirem que IAs se adaptem e melhorem operações com base em feedback. Contudo, sua eficácia é convencionalmente medida por ganhos em benchmarks rotulados — dados com respostas corretas anotadas. Em contextos operacionais de segurança, esses rótulos são frequentemente escassos, desatualizados e não representativos, tornando difícil para um profissional avaliar se um harness realmente ajuda ou qual de duas opções seria melhor.
Abordagens tradicionais, como usar um LLM para avaliar outro LLM, também se mostraram inadequadas. O estudo afirma que um modelo avaliador (judge) do mesmo porte do modelo avaliado "não oferece sinal útil", e a destilação de conhecimento é imprevisível com rótulos escassos, esporádicos e enviesados.
Por que importa
A proposta ataca um gargalo prático em ambientes onde a IA atua em tempo real: a impossibilidade de validar sua evolução com métodos padrão. Para equipes de segurança cibernética, desenvolvedores de software e operadores de sistemas autônomos, isso significa ter uma forma de medir o valor real de um harness de aprendizado em seu próprio ambiente de operação, não apenas em um laboratório com dados idealizados.
O framework viabiliza a comparação objetiva entre diferentes harnesses e ajuste de sistemas existentes, tornando possível decidir com base em evidências, não em suposições. Isso pode acelerar a adoção e o aperfeiçoamento de soluções de IA adaptativa em setores críticos.
Impacto
No curto prazo, a pesquisa oferece uma nova métrica concreta para equipes que desenvolvem ou implementam sistemas agentic. Profissionais poderão otimizar harnesses com base na convergência com um modelo professor, reduzindo a incerteza sobre o retorno do investimento em tais sistemas.
No médio prazo, o método pode democratizar a avaliação de sistemas de aprendizado, permitindo que organizações com menos recursos para criar benchmarks extensos avaliem e confiem em soluções de IA adaptativa. Isso é especialmente relevante para empresas brasileiras que precisam de soluções de segurança ou automação personalizadas para mercados locais.
O que muda
A pesquisa inverte a lógica convencional de avaliação. Em vez de depender de um conjunto de dados fixo e rotulado (o benchmark), o novo framework usa a própria性能 de um modelo mais avançado como bússola. Isso desloca o foco da validação em cenários pré-definidos para a medição de progresso em tarefas reais e específicas.
Também valida a ineficácia do "LLM-as-a-judge" entre modelos de porte similar, desencorajando uma prática comum e apontando para a necessidade de hierarquias claras de avaliação. O estudo sugere que o mesmo harness pode melhorar um modelo professor se humanos fornecerem as mesmas correções esporádicas e de alta precisão.
O que vem agora
Os próximos passos envolvem a validação do framework em uma gama mais ampla de tarefas e domínios além da cibersegurança. A pesquisa abre caminho para estudos sobre o tipo ideal de "correções esporádicas" e a relação ótima entre os portes dos modelos professor e estudante.
Para a comunidade de IA, isso pode acelerar o desenvolvimento de padrões de avaliação para sistemas adaptativos, preenchendo uma lacuna importante na métrica de desempenho de agentes autônomos que aprendem continuamente.