
Pesquisa desvada por que 'skills' de IA funcionam — e quando falham
Artigo do arXiv mapeia taxonomy de três categorias e revela que precisão de retrieval cai 10x com pools maiores
O que aconteceu
Um novo paper publicado no arXiv (14/08/2026) investiga as 'skills' — pacotes estruturados de conhecimento usados para melhorar agentes de LLM em tempo de inferência. A pesquisa parte de uma lacuna: avaliações anteriores mediam se skills melhoravam a taxa de sucesso agregada, mas não respondiam quando, por quê e onde essas habilidades falham.
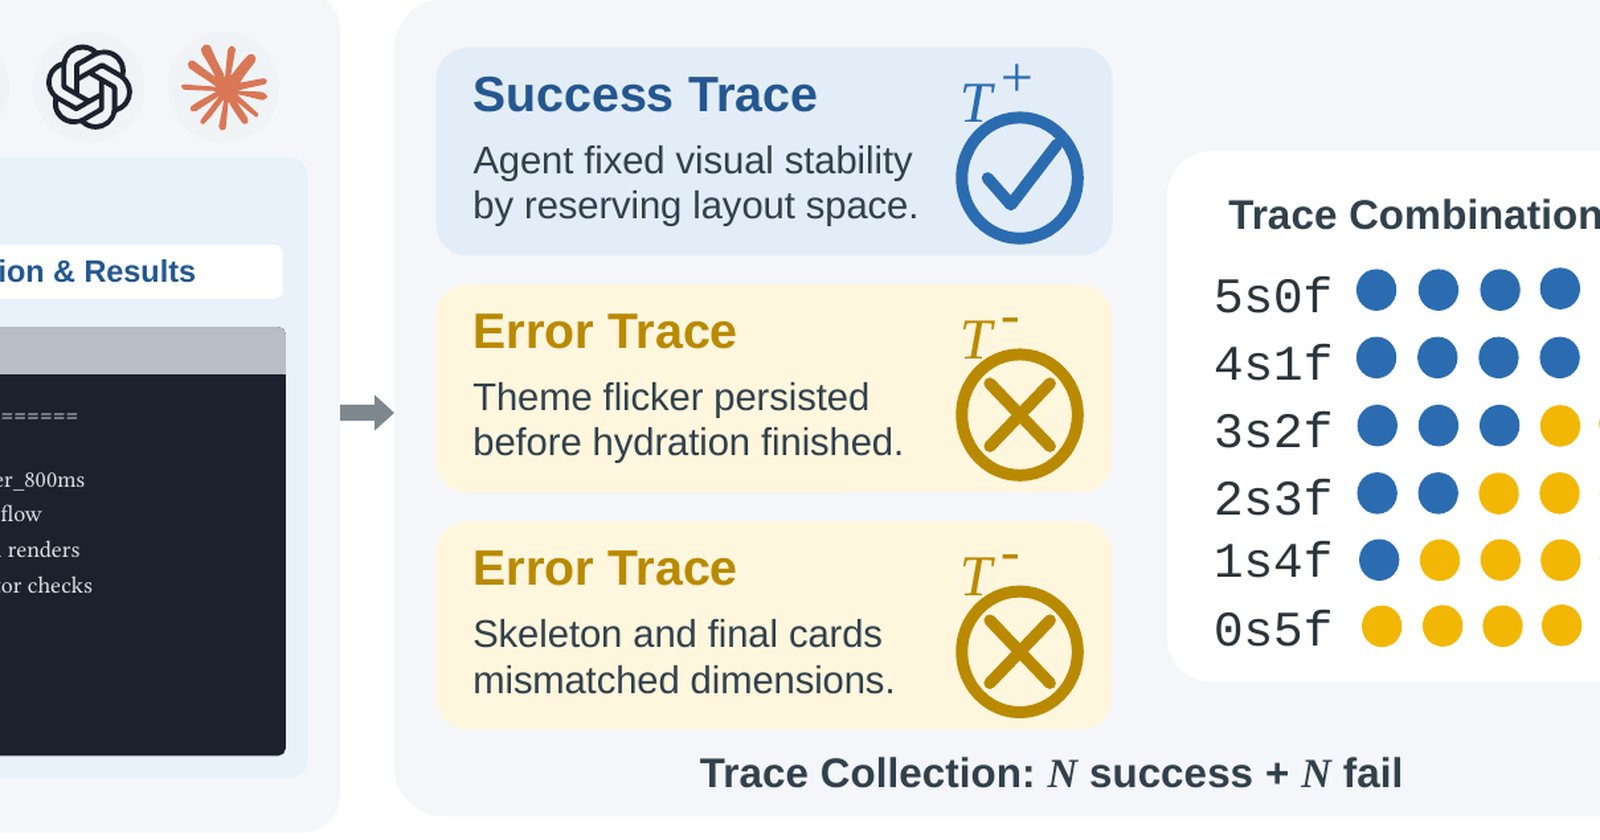
O time conduziu experimentos controlados em múltiplos benchmarks, frameworks de agentes e modelos de linguagem. No total, normalizaram 8.135 registros de tentativas e mantiveram 238 rótulos válidos de 240 registros codificados abertamente. A análise combinou experimentos quantitativos controlados com estudo de trajetórias pareadas.
O resultado principal é uma taxonomy com três categorias de alto nível e 12 modos de uso de skills. O dado mais revelador: 65,7% dos casos de uso de skills se enquadram em 'âncoras procedurais' — quando trajetórias ruidosas se tornam pontos de referência que estabilizam a execução. Já a injeção explícita de conhecimento responde por apenas 4,5% dos casos.
Contexto
Skills surgiram como abordagem prática para melhorar agentes de LLM. A ideia é empacotar conhecimento relevante de forma estruturada para que o modelo acesse durante a resolução de tarefas. Essa abordagem se diferencia de simply ampliar o contexto ou usar RAG (Retrieval-Augmented Generation).
O paper compara skills com Workflow Memory — uma abordagem alternativa — e encontra que skills superam por 6,06 pontos em comparações controladas. O ganho, porém, não vem de onde muitos imaginavam: não é sobre injetar fatos que o modelo não sabe, mas sobre dar estrutura a ações que de outro modo seriam caóticas.
A pesquisa também identificou que a precisão de retrieval — capacidade de encontrar a skill certa no momento certo — é um gargalo separado. Quando o pool cresce de 5 para 100 skills, a precisão real de uso cai de 29,6% para 3,3%. Distratores confundíveis prejudicam a identificação offline, mas o sucesso downstream permanece estável, sugerindo que invocação exata não é nem suficiente nem necessária.
Por que importa
O estudo tem implicações práticas para quem desenvolve agentes de IA. Em primeiro lugar, desloca o foco das métricas de sucesso agregado para uma compreensão granular de como skills operam. Desenvolvedores que buscam construir agentes confiáveis precisam entender que skills não são mágicas de conhecimento — são estabilizadores de comportamento.
Em segundo lugar, o gargalo de retrieval indica que simplesmente criar mais skills pode ser contraprodutivo. A precisão de 3,3% em pools de 100 habilidades mostra que sistemas de seleção precisam de atenção tanto quanto as skills em si.
Para o mercado brasileiro de startups e empresas de IA, o paper oferece orientação concreta: antes de acumular skills, vale investir em mecanismos de retrieval e adaptação de contexto. A pesquisa também alerta para os pontos de falha — skills quebram sob pressupostos frágeis, contextos incompatíveis ou adaptação insuficiente.
Impacto
No curto prazo, o paper contribui para repensar como agentes são avaliados. Métricas agregadas de taxa de sucesso deixam de ser suficientes quando se quer entender comportamento real. No médio prazo, a taxonomy de 12 modos de uso pode orientar design de sistemas — privilegiando estabilização procedural sobre injeção de conhecimento.
A queda de precisão em retrieval também sinaliza espaço para pesquisa em sistemas de organização e seleção de skills, possivelmente com mecanismos de adaptação dinâmica.
O que muda
A pesquisa propõe que avaliações de agentes vão além de taxas de sucesso. A taxa de sucesso agregada mascara onde skills realmente operam. Além disso, o achado de que invocação exata não é necessária para sucesso downstream muda a lógica de design: sistemas robustos não precisam ser perfeitos na identificação, mas sim resilientes a erros de seleção.
O que vem agora
Os autores indicam que os achados guiam agentes autoevolutivos mais confiáveis. Próximos passos incluem expandir a taxonomy com mais benchmarks e investigar como sistemas podem adaptar dinamicamente seu repertório de skills, evitando os pontos de falha identificados — pressupostos frágeis, contextos incompatíveis e adaptação insuficiente.