
Pesquisadores propõem método estatístico para otimizar mistura de dados em treinamento de LLMs
Estudo arXiv:2608.23922v1 aplica metodologia de superfície de resposta a domain mixing em grandes modelos de linguagem.
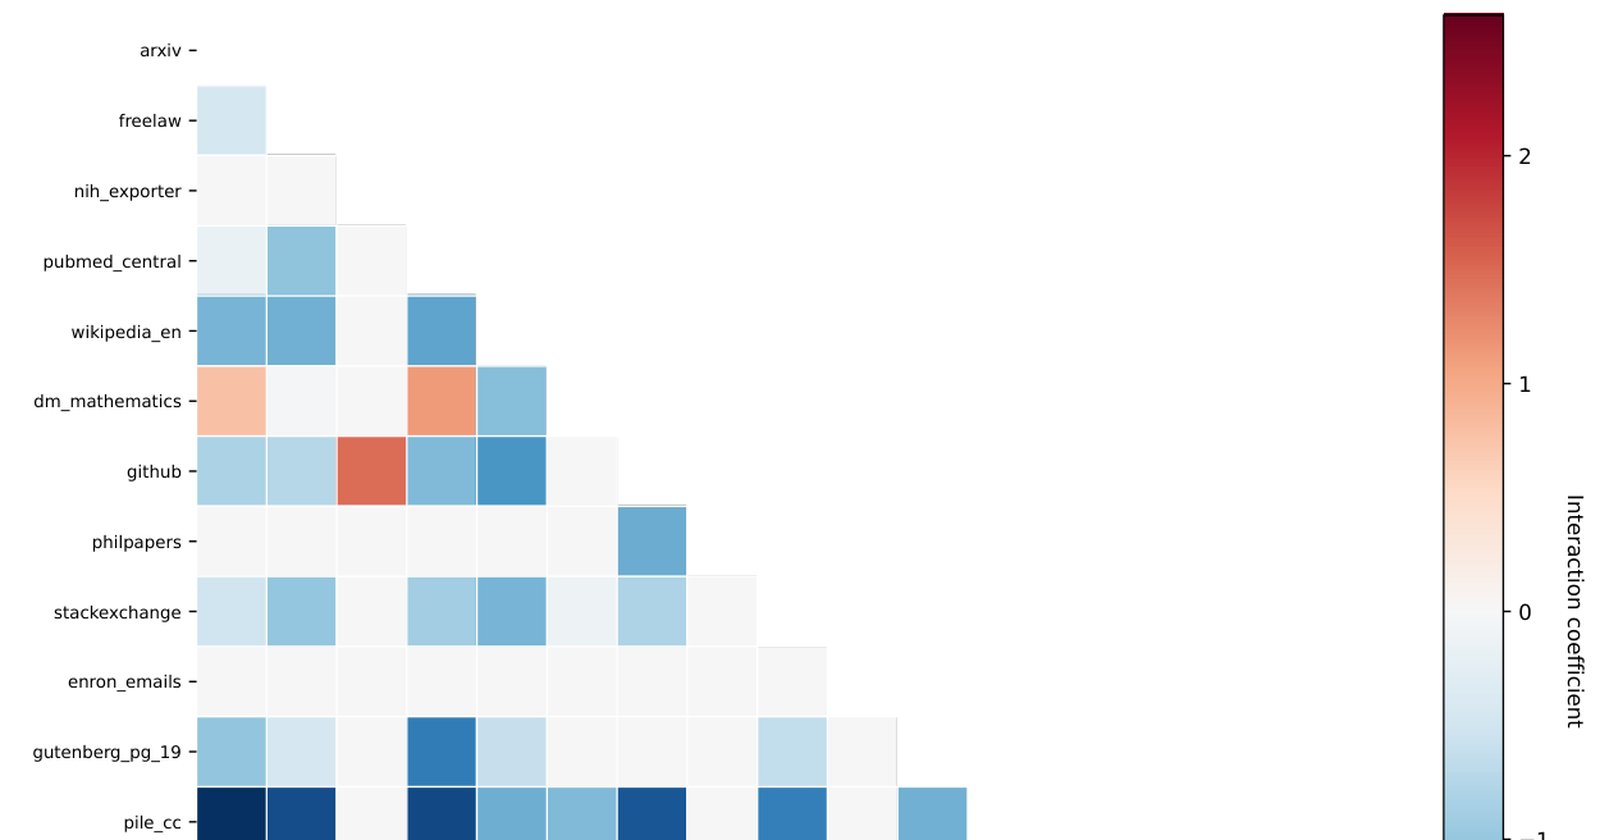
O que aconteceu
O artigo 'Data Mixing as Mixture Experiment: Response Surface Methodology and Optimal Design for Large Language Model Pretraining', submetido ao arXiv em 24 de agosto de 2026 (arXiv:2608.23922v1), apresenta uma nova abordagem estatística para decidir como alocar tokens entre domínios de dados durante o pré-treinamento de LLMs. Em vez de testar aleatoriamente combinações de fontes de dados, os autores propõem usar modelos de segunda ordem de Scheffé para mapear como diferentes proporções de dados afetam a perda de validação. O estudo mostra que domínios fracos isoladamente podem se tornar vantajosos quando combinados com textos da web. A equipe demonstra, por meio de simulações calibradas com respostas reais de treinamento de proxies, que os designs robustos baseados em critério I-recuperam a ordem correta das misturas após remover cerca de 25% dos testes originais.
Contexto
No pré-treinamento de grandes modelos de linguagem, os engenheiros enfrentam um dilema: com um orçamento fixo de tokens, como distribuir esses tokens entre domínios como livros, artigos científicos, código, notícias e conteúdo da web? Métodos recentes usam proxies — treinam modelos menores com diferentes combinações de dados e usam os resultados para escolher a melhor mistura para modelos maiores. Esse processo, até agora, era feito de forma empírica ou com aprendizado de máquina. Os autores identificaram que esse fluxo tem a estrutura de um experimento de mistura clássico, onde domínios são componentes, proporções de tokens são proporções dos componentes, execuções de proxy são pontos de design experimental, e a perda de validação define uma superfície de resposta sobre o simplex de probabilidade.
Por que importa
Reduzir o número de testes de proxy significa economizar computação e tempo. Treinar modelos menores ainda assim exige recursos substanciais, especialmente quando testam dezenas de combinações. Ao aplicar designs I-ótimos robustos ao modelo, os pesquisadores mostram que é possível manter a precisão na escolha da melhor mistura enquanto elimina 25% dos testes. Isso é especialmente relevanto para empresas que treinam LLMs em larga escala, onde cada teste adicional pode custar milhares de dólares em infraestrutura.
Impacto
O estudo também traz uma descoberta conceitual: o valor de um domínio de dados não é absoluto, mas relacional. Domínios que parecem fracos quando avaliados isoladamente ganham força quando combinados com outros, especialmente com textos derivados da web. Essa interação par-a-par é capturada pelo modelo de Scheffé, que decompõe os efeitos aditivos e interativos. O modelo esparso de Scheffé também mantém a classificação das misturas consistente entre diferentes escalas de modelo, algo que métodos mais flexíveis de aprendizado de máquina não garantem.
O que muda
Com essa abordagem, a mistura de dados deixa de ser apenas um problema de previsção e passa a ser também um problema de design experimental. Isso significa que as próprias combinações de dados testadas podem ser escolhidas para maximizar a eficiência estatística, e não apenas para prever o melhor resultado. A aplicação prática pode permitir que equipes de ML priorizem testes mais informativos, reduzindo custos sem perder desempenho.
O que vem agora
Os autores indicam que próximos passos incluem validar o framework com mais casos empíricos além do RegMix, e explorar como os designs robustos se comportam em cenários com orçamentos de tokens ainda mais restritos. Também planejam investigar extensões do modelo de Scheffé para capturar interações de ordem superior entre domínios de dados.