
PlanPO: otimização de políticas com planejamento para LLMs agênticos
Novo método de RL distingue trajetórias bem-sucedidas pela eficiência de interação
O que aconteceu
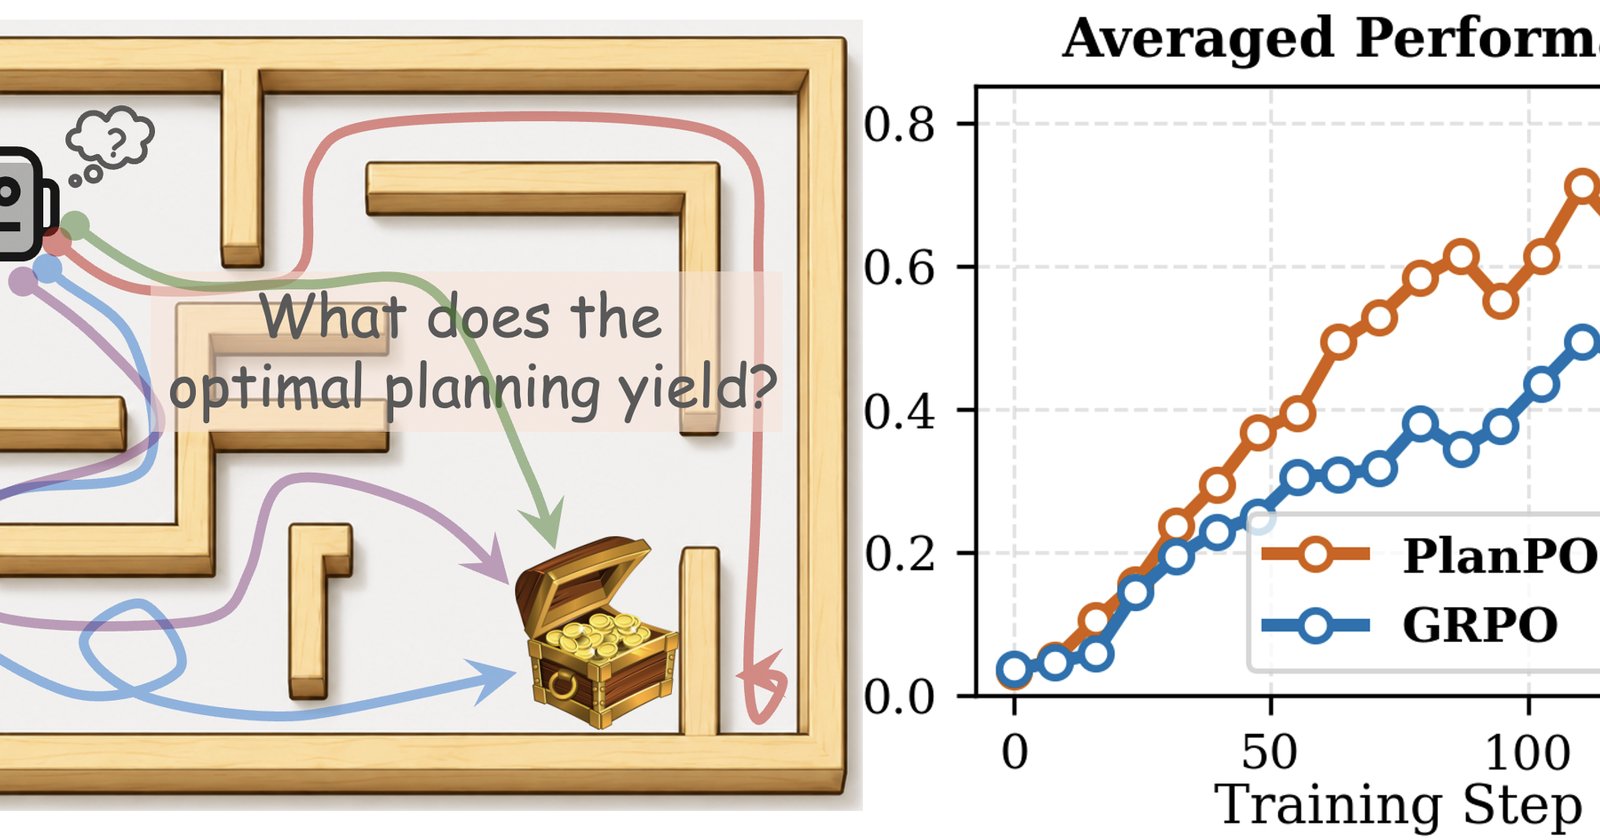
Um grupo de pesquisadores submeteu ao arXiv, em 18 de agosto de 2026, o artigo "PlanPO: Group Planning-Aware Policy Optimization for Multi-Turn Agentic LLMs" (arXiv:2608.17289). O trabalho propõe o PlanPO, um método de otimização de políticas por reforço (RL) que visa melhorar o treinamento de modelos de linguagem de grande porte (LLMs) em tarefas interativas de múltiplas etapas. O método introduz sinais de vantagem de granularidade grosseira a fina, que capturam diferenças relativas no comprimento das trajetórias e das respostas em cada turno, condicionadas a trajetórias bem-sucedidas para a mesma tarefa. Segundo os autores, o PlanPO supera o GRPO em 27,2% em média nos benchmarks ALFWorld, WebShop e SciWorld, com custo adicional de treinamento desprezível.
Contexto
A otimização de políticas relativa a grupos (group-relative policy optimization) tornou-se um paradigma comum para treinar LLMs agênticos. No entanto, a maioria das variantes existentes não distingue vantagens entre trajetórias bem-sucedidas quando elas diferem em eficiência de interação. Por exemplo, sucessos indiretos recebem a mesma recompensa de resultado, causando colapso de vantagem e gargalos de desempenho. O PlanPO busca resolver isso ao aprender habilidades de planejamento generalizáveis, além de padrões de comportamento específicos de tarefas.
Por que importa
Para empresas e desenvolvedores que usam agentes de IA em tarefas como navegação web, compras online ou simulações, a eficiência de interação é crucial. Um agente que conclui a tarefa com menos passos economiza tempo e recursos computacionais. O PlanPO demonstra que é possível melhorar significativamente o desempenho sem custo adicional relevante, o que pode acelerar a adoção de agentes mais eficientes em aplicações reais.
Impacto
No curto prazo, o método pode ser incorporado a pipelines de treinamento de LLMs agênticos, oferecendo uma alternativa ao GRPO. No médio prazo, a capacidade de distinguir trajetórias bem-sucedidas pela eficiência pode levar a agentes mais deliberativos e generalizáveis, reduzindo a dependência de comportamentos específicos de tarefa. Isso pode impactar áreas como automação de processos, atendimento ao cliente e assistentes virtuais.
O que vem agora
Os autores não detalharam próximos passos no resumo do artigo. Espera-se que o método seja avaliado em benchmarks adicionais e que a comunidade explore variações do sinal de vantagem. A publicação no arXiv indica que o trabalho está em fase de revisão por pares, e é provável que versões estendidas sejam apresentadas em conferências de IA.