
RENDER: formato da memória altera desempenho de LLMs em benchmarks
Benchmark fixa a conversa e varia o artefato lido pelo modelo, revelando diferenças de até 72,6 pontos
O que aconteceu
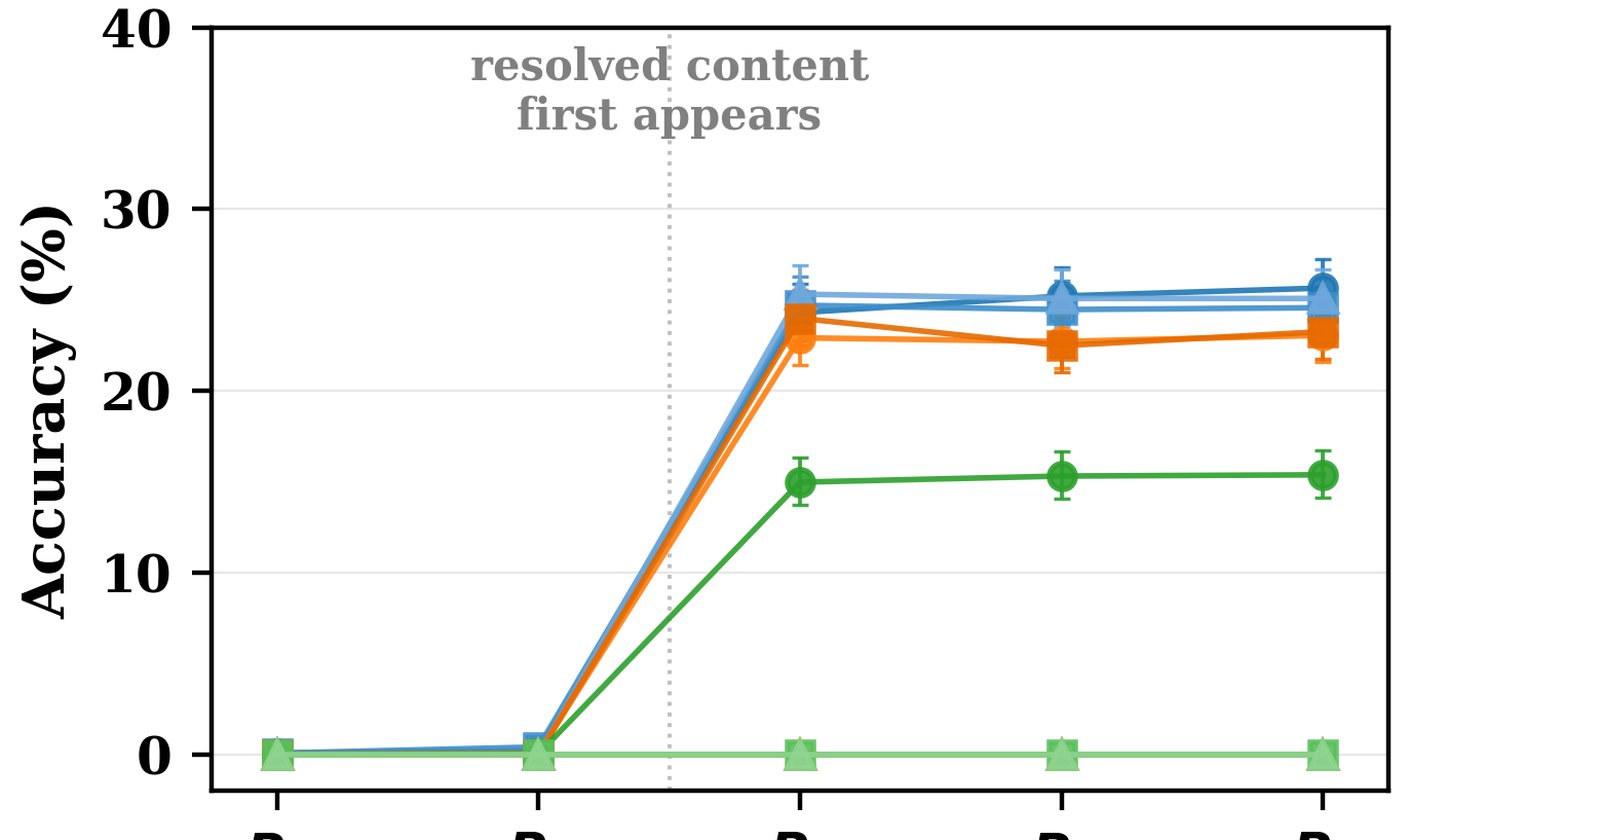
O RENDER, benchmark control criado pela equipe de pesquisa, foi submetido ao arXiv em 5 de junho de 2026 (arXiv:2608.23568). O RENDER fixa a conversa e varia o artefato voltado ao leitor, ou seja, como o histórico chega ao modelo. O benchmark usa uma escada de pacotes de cinco níveis, que localiza quando o conteúdo com a resposta entra no input, e templates determinísticos que imitam quatro formatos: entradas estilo ChatGPT, resumos do LangChain, registros tipados estilo MemGPT e conversa bruta. Em 500 perguntas do LongMemEval, com orçamento igualado, os pacotes resolvidos superaram o diálogo bruto truncado por recência por 42,4 a 72,6 pontos.
Contexto
Avaliações de memória e RAG frequentemente tratam o input como detalhe de implementação. Sistemas podem renderizar o mesmo histórico como uma entrada de memória, um resumo, um registro tipado ou um trecho bruto. O resumo gerado pelo LangChain, por exemplo, é um dos formatos testados. O RENDER foi criado para preencher essa lacuna, oferecendo um controle padronizado.
Por que importa
Os números mostram a magnitude do efeito. Em templates estilo deployed, a dispersão entre melhor e pior formato por modelo foi de 24,6 a 48,8 pontos. Sob o scorer primário, as entradas estilo ChatGPT tiveram estimativas pontuais mais altas do que a conversa bruta em 7 dos 9 modelos. O caso extremo: três modelos marcaram 0% em pacotes de ledger formal, mas responderam aos mesmos fatos quando a informação veio em linguagem natural, com acertos entre 45,4% e 53,4%. Ou seja, o formato de apresentação pode estar mascarando a capacidade real de memória do modelo.
Impacto
O efeito persiste sob ruído de recuperação e transfere para o HotpotQA, outro dataset de perguntas e respostas. Isso sugere que o fenômeno não é específico do LongMemEval. A re-avaliação por um juiz (judge rescoring) preservou o efeito agregado positivo, mas a significância específica por modelo ficou mista. Na prática, métricas de memória e RAG podem estar medindo o template em vez da memória do modelo, o que compromete a comparação entre sistemas.
O que vem agora
Os autores recomendam que avaliações de memória e RAG reportem ou controlem o artefato voltado ao leitor. O próximo passo é incorporar o RENDER como controle padrão em benchmarks como LongMemEval e HotpotQA, além de investigar por que alguns modelos são mais sensíveis ao formato do que outros.
Fontes
- arXiv: RENDER: Controlling Reader-Facing Evidence in LLM Memory Evaluation (https://arxiv.org/abs/2608.23568)