
reSolve: nova técnica de IA auto-evolui habilidades com 74,9% de precisão
Framework do arXiv, submetido em agosto de 2026, supera curadoria humana em 14,8 pontos com modelo barato
O que aconteceu
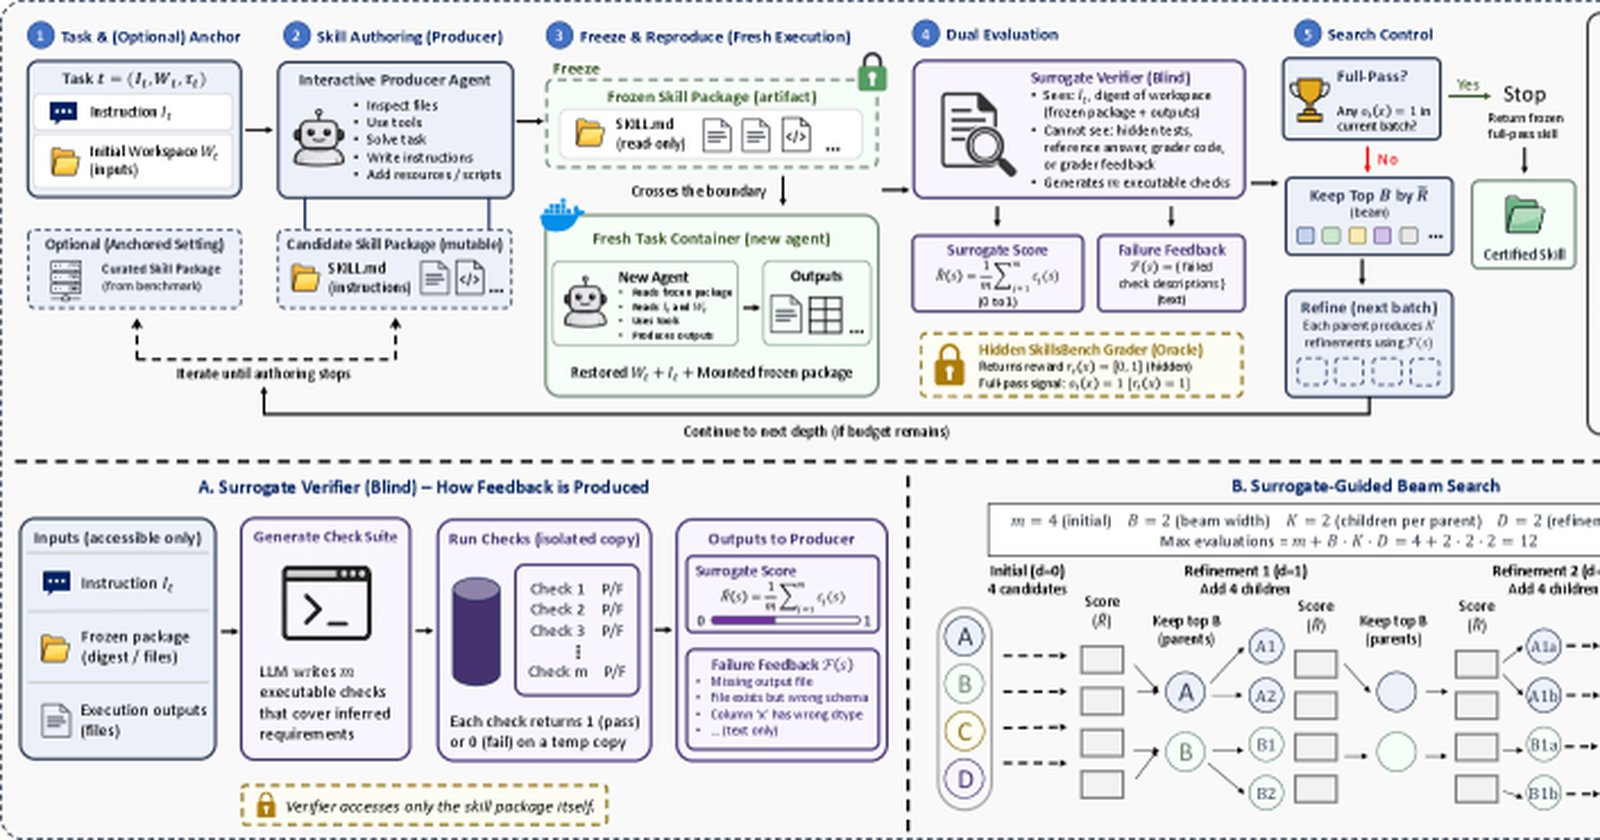
O artigo "Self-Evolving Skills via Surrogate-Guided Solve-and-Reproduce" foi submetido ao arXiv (seção cs.AI) em 10 de agosto de 2026 e está disponível sob o código 2608.28638v1. A submissão do artigo, em 10 de agosto de 2026, apresenta o reSolve, um framework per-task com oracle-in-the-loop. O reSolve tem três componentes. O primeiro separa a solução interativa de um entregável autocontido, que é reexecutado de forma independente em um container novo, o protocolo solve-and-reproduce. O segundo é um verificador substituto, chamado de surrogate verifier, que não tem acesso a testes ocultos nem a respostas de referência. O terceiro executa uma busca em feixe guiada pelo verificador sobre um grafo de construção de solução.
O resultado central: em um harness fixo, um modelo barato auto-evoluiu skills até alcançar 74,9% de mean-of-3. O reSolve, framework do estudo, atingiu essa marca ao superar o baseline curado por humanos, que ficou em 60,1%, uma diferença de +14,8 pontos. O melhor resultado oficial de skill curada foi 67,3%, obtido pelo GPT-5.5/OpenHands. O desempenho de 67,3% do OpenHands com GPT-5.5 foi superado pelo reSolve em 7,6 pontos percentuais.
Contexto
Skills de agente são pacotes portáteis de instruções e recursos que um agente consulta na implantação. A auto-evolução dessas skills falha de duas maneiras hoje. Primeiro, skills evoluídas do zero têm desempenho inferior ao das curadas por humanos e, em um modelo fraco, usar nenhuma skill é melhor. Segundo, uma passada de evolução registra uma trajetória de sorte que um agente estocástico fresco frequentemente falha em reproduzir na implantação. O reSolve ataca os dois problemas: o protocolo solve-and-reproduce garante a reexecução da solução em um ambiente limpo, e o verificador substituto melhora o sinal de recompensa esparso sem acessar as respostas corretas.
A submissão do artigo, em 10 de agosto de 2026, acontece em meio à corrida por agentes mais autônomos. O paper documenta que a curadoria humana era o padrão-ouro até então. Com o reSolve, um modelo barato passou a gerar skills melhores que o padrão-ouro em um harness fixo.
Por que importa
O resultado importa porque ataca o custo e a confiabilidade de agentes de IA. Empresas que pagam por curadoria humana de skills podem usar modelos baratos e automatizar o processo. A diferença de +14,8 pontos sobre o baseline humano, medida pelo mean-of-3, mostra que a auto-evolução deixou de ser só um exercício acadêmico. O GPT-5.5/OpenHands, que obteve 67,3% como melhor resultado oficial curado, foi superado por um modelo barato dentro de um harness fixo. Isso muda o cálculo de quem escolhe entre um modelo caro e um modelo econômico.
Impacto
No curto prazo, o impacto é metodológico. O protocolo solve-and-reproduce pode ser adotado por outros grupos como forma de validar se uma skill evoluiu de verdade. A busca em feixe guiada pelo verificador oferece um caminho para treinar sem testes ocultos. Os autores também relatam casos de falha observados e resultados por domínio, incluindo o desempenho nas 14 tarefas de Natural Science, o que delimita onde a abordagem ajuda e onde não ajuda.
No médio prazo, o reSolve pode reduzir a dependência de grandes fornecedores de modelos. Um agente com uma boa skill auto-evoluída pode ser mais eficiente que um agente maior sem skill. A ressalva é que o framework é per-task: cada tarefa exige seu próprio ciclo de evolução.
O que muda
O papel do humano muda de curador para auditor. Em vez de escrever skills manualmente, o especialista passa a verificar skills geradas por um modelo barato e guiadas por um verificador substituto. O artigo mostra que esse fluxo funciona em um harness fixo, mas ainda é cedo para saber se a abordagem escala para tarefas abertas do mundo real.
O que vem agora
Os próximos passos naturais incluem a replicação independente do resultado por outros grupos e a aplicação do reSolve em domínios além das 14 tarefas de Natural Science. O artigo, disponível no arXiv sob o código 2608.28638v1, deve ganhar versões revisadas. Os autores indicam que os casos de falha são tão importantes quanto os números positivos. Até lá, o 74,9% de mean-of-3 é o número a ser batido na auto-evolução de skills.