
RobustSGPO propõe controle de busca para evolução de agentes de IA
Método controla o escopo das edições em prompts de agentes e melhora qualidade de 3,77 para 4,14 em orçamento de 20 milhões de tokens
O que aconteceu
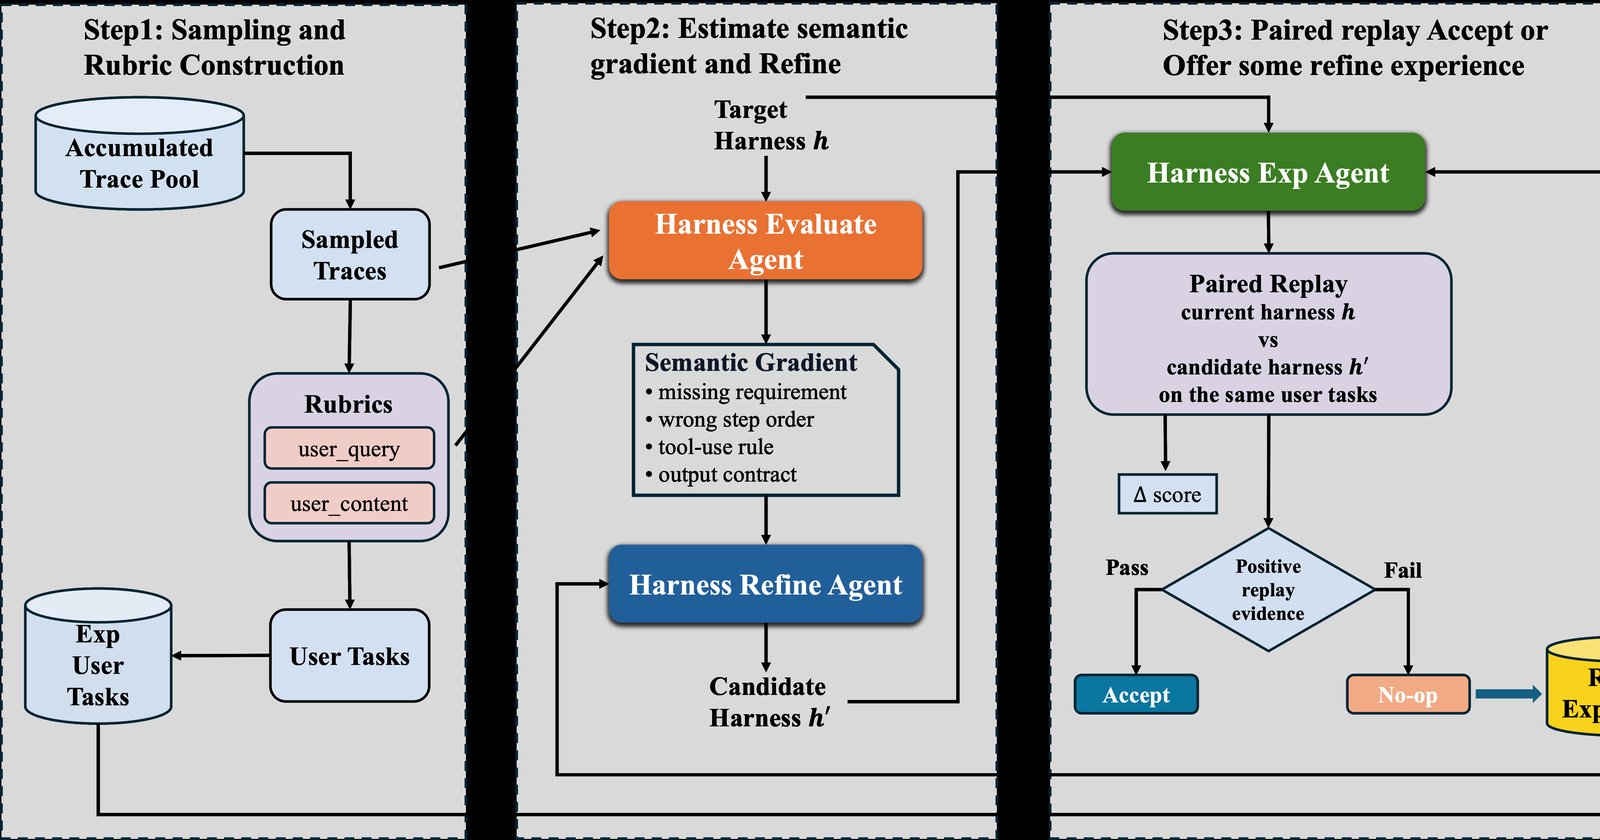
O RobustSGPO foi submetido ao arXiv em 9 de setembro de 2026, com o identificador arXiv:2609.09646v1. O RobustSGPO é um método de controle de espaço de busca para evolução de agentes de IA, e a proposta parte de uma limitação conhecida de outra técnica, a otimização de prompts baseada em gradiente semântico, ou SGPO.
A SGPO melhora os chamados agent harnesses, as camadas que orquestram como um agente executa tarefas, usando feedback de execução. O problema, segundo os autores, é que a regra de atualização local da SGPO deixa sem resposta duas decisões centrais: qual o escopo da edição e qual a operação pedida. O RobustSGPO ataca exatamente esse ponto.
O RobustSGPO especifica a edição solicitada, constrói e confere o patch antes de aplicá-lo, e continua a busca a partir do estado atual ou de snapshots retidos. A avaliação usou o fluxo de brainstorming do AgentX, com 120 tarefas, 95 execuções e 7.350 tentativas candidatas.
Contexto
Otimizar prompts de agentes deixou de ser ajuste manual. A SGPO já usava feedback das próprias execuções para melhorar o harness, mas operava com uma regra de atualização local que não resolvia o alcance de cada mudança. Isso significa que o sistema podia fazer alterações sem uma noção clara de até onde elas deveriam ir nem de qual operação aplicar.
Essa indefinição é o que o RobustSGPO tenta resolver ao tratar o espaço de busca como algo governável. Em vez de deixar a edição em aberto, o método define o que será editado, monta o patch, valida e só então decide se segue do estado vigente ou de uma versão anterior guardada, chamada de snapshot retido.
Por que importa
A diferença prática aparece nos números. O RobustSGPO elevou a conclusão em 30 tarefas mantidas de fora do ajuste de 60,0% para 80,0%. A qualidade de teste subiu de 3,77 para 4,14 dentro de um orçamento de 20 milhões de tokens.
Outro resultado envolve agendamento de permissões. O esquema periódico 1 para 2 para 3 superou o máximo fixo de permissão em 0,28 ponto de test-score. Ou seja, liberar a permissão de forma progressiva rendeu mais do que manter o teto sempre aberto.
O estudo também testou retenção por categoria contra retenção aleatória. A retenção por categoria reduziu a degradação nas tarefas de origem depois de uma mudança de contexto. Já a retenção aleatória chegou a um ponto final mais alto no destino. Os dois caminhos têm efeitos diferentes.
Impacto
Para quem desenvolve agentes, o recado é que controlar o espaço de busca melhora qualidade por dois caminhos concretos: edições que podem ser executadas e pontos de partida alternativos. O RobustSGPO combina os dois e ainda mede o custo de manter snapshots, chamado no artigo de overhead de retenção.
O impacto aparece na redução de desperdício. Com 7.350 tentativas candidatas em 95 execuções, o volume de teste é alto. Um método que evita edições mal especificadas reduz tentativas que não levam a lugar nenhum dentro de um orçamento fixo de tokens.
A transferência entre famílias de tarefas é o terceiro eixo avaliado. O RobustSGPO foi testado nesse cenário justamente porque agentes raramente ficam presos a um único tipo de problema.
O que muda
A mudança central é tirar o agente do piloto automático da edição local. O RobustSGPO insere etapas de especificação e verificação antes de qualquer atualização entrar em vigor, e mantém a opção de voltar a um snapshot anterior.
Isso transforma a otimização de prompts em um processo com controle explícito. O agente deixa de escolher sozinho o escopo da mudança e passa a operar dentro de limites definidos, com patches checados antes da aplicação.
O resultado de conclusão de 80,0% em tarefas não vistas é o dado mais direto dessa diferença. O RobustSGPO parte de 60,0% e chega a 80,0% no mesmo conjunto, sob o mesmo teto de recursos.
O que vem agora
O artigo é a versão 1 do preprint, submetida em 9 de setembro de 2026, e ainda depende de revisão da comunidade. Os autores avaliaram três frentes: agendamento de permissões, controles cumulativos e transferência entre famílias de tarefas, todas no fluxo de brainstorming do AgentX.
Os próximos passos naturais são a replicação em outros fluxos de agente e a análise do custo de retenção de snapshots em escala maior. O próprio texto deixa claro que o overhead de retenção é mensurável, o que abre a pergunta sobre quando vale manter versões antigas e quando compensa seguir apenas do estado atual.