
SAEM: gestão de especialistas para inferência eficiente de MoE
Sistema explora a coerência de ativação entre estágios do raciocínio para reduzir transferências entre GPU e CPU.
O que aconteceu
Um grupo de pesquisadores publicou no arXiv, em 21 de agosto de 2026, o paper de ID 2608.21614, que apresenta o SAEM (Stage-Aware Expert Management). O SAEM, runtime de inferência para MoE, foi descrito no paper submetido à plataforma, que teve primeira vista em 25 de agosto de 2026. O sistema obtém ganho médio de 1,33x no throughput em comparação com os baselines mais fortes de caching e offloading, quando a memória da GPU é restrita. Quando os dados de calibração coincidem com a carga, o ganho sobe para 1,54x. Os testes cobriram workloads de raciocínio matemático e científico.
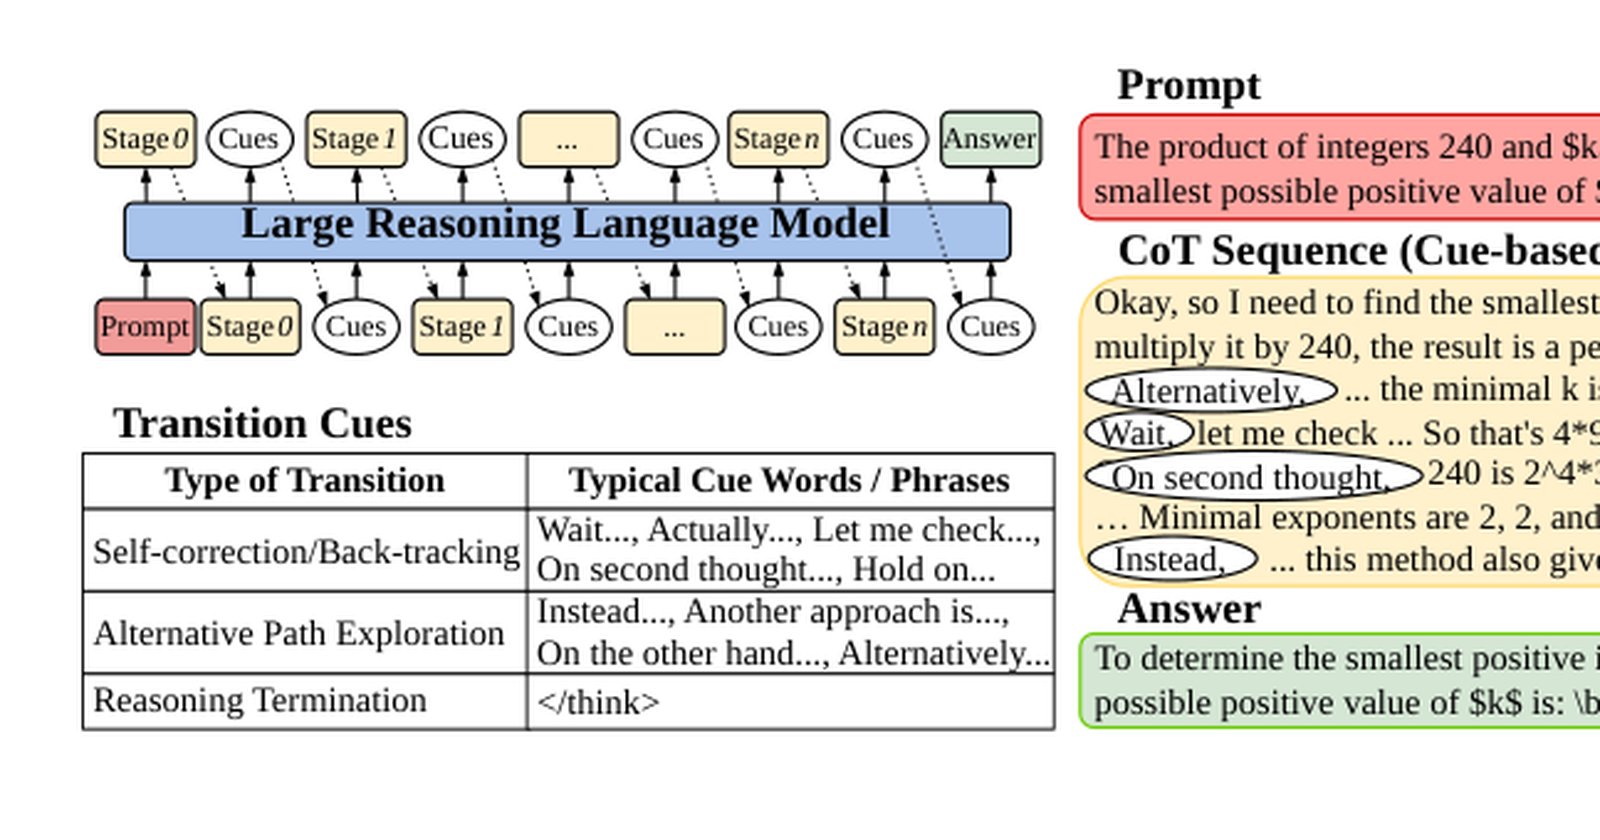
O SAEM combina três técnicas: stage-aware caching, repacking de tokens alinhado a especialistas e execução in-situ na CPU. A proposta central é detectar as fronteiras entre estágios do raciocínio CoT e explorar a coerência de ativação de especialistas em cada estágio.
Contexto
Os modelos MoE (Mixture-of-Experts) aumentam a capacidade de um LLM ativando apenas um subconjunto de especialistas por token. Porém, os pesos de todos os especialistas costumam ultrapassar a memória da GPU, exigindo transferências constantes entre GPU e CPU. Essas transferências são um dos maiores custos da inferência.
O chain-of-thought (CoT), técnica que decompõe problemas complexos em passos intermediários, melhora o raciocínio dos modelos, mas sua natureza sequencial aumenta a latência de decodificação e o uso de memória. Os runtimes existentes tratam todos os tokens de forma uniforme e ignoram uma propriedade estrutural dos traços de CoT: estágios consecutivos de raciocínio apresentam padrões coerentes e previsíveis de ativação de especialistas. Os autores argumentam que essa regularidade, quando ignorada, leva a cache ineficiente e movimento desnecessário de dados.
Por que importa
O ganho médio de 1,33x no throughput, medido pelo SAEM sob memória de GPU restrita, significa que provedores de nuvem e empresas podem atender mais requisições com a mesma infraestrutura. Isso reduz o custo por inferência em tarefas de raciocínio, comuns em plataformas de educação, finanças e ciência. No Brasil, o uso de modelos de grande porte em serviços de atendimento e análise cresceu nos últimos anos, e a otimização de memória permite rodar modelos maiores em hardware mais barato. O SAEM ataca um gargalo real: a movimentação de pesos entre GPU e CPU, que domina o custo quando a memória é escassa.
Impacto
O SAEM mostrou que a estrutura interna do raciocínio CoT pode ser aproveitada para otimização de inferência. O stage-aware caching mantém na GPU apenas os especialistas relevantes para o estágio corrente. O repacking de tokens alinhado a especialistas reduz a fragmentação de kernels. A execução in-situ na CPU evita cópias desnecessárias.
No cenário de memória restrita, o ganho médio foi de 1,33x, e com calibração adequada ao domínio o resultado subiu para 1,54x. Essa diferença indica que o método se beneficia de dados representativos do uso real. A técnica pode, em tese, ser adaptada a domínios específicos, como programação ou diagnósticos médicos, mas o paper não detalha esses casos.
O que muda
Os benchmarks com MoE e CoT passam a ter o SAEM como referência. Uma abordagem que antes parecia inviável em GPUs com pouca memória pode se tornar padrão. Porém, o estudo não menciona a disponibilização de código, o que dificulta a reprodução independente dos resultados. A comunidade precisará de uma implementação aberta ou de uma conferência com revisão por pares para validar de forma independente.
O que vem agora
O artigo é um preprint do arXiv, sem revisão por pares. Os próximos passos prováveis incluem a liberação do código, avaliação em outros tipos de workloads e comparação com runtimes comerciais como vLLM ou TensorRT-LLM. Também é esperado que os autores investiguem como o SAEM se comporta em modelos MoE ainda maiores, já que a restrição de memória tende a ser maior com a escala.