
SAPO: novo método de RL reduz custo em 33% e supera PPO no treino de LLMs
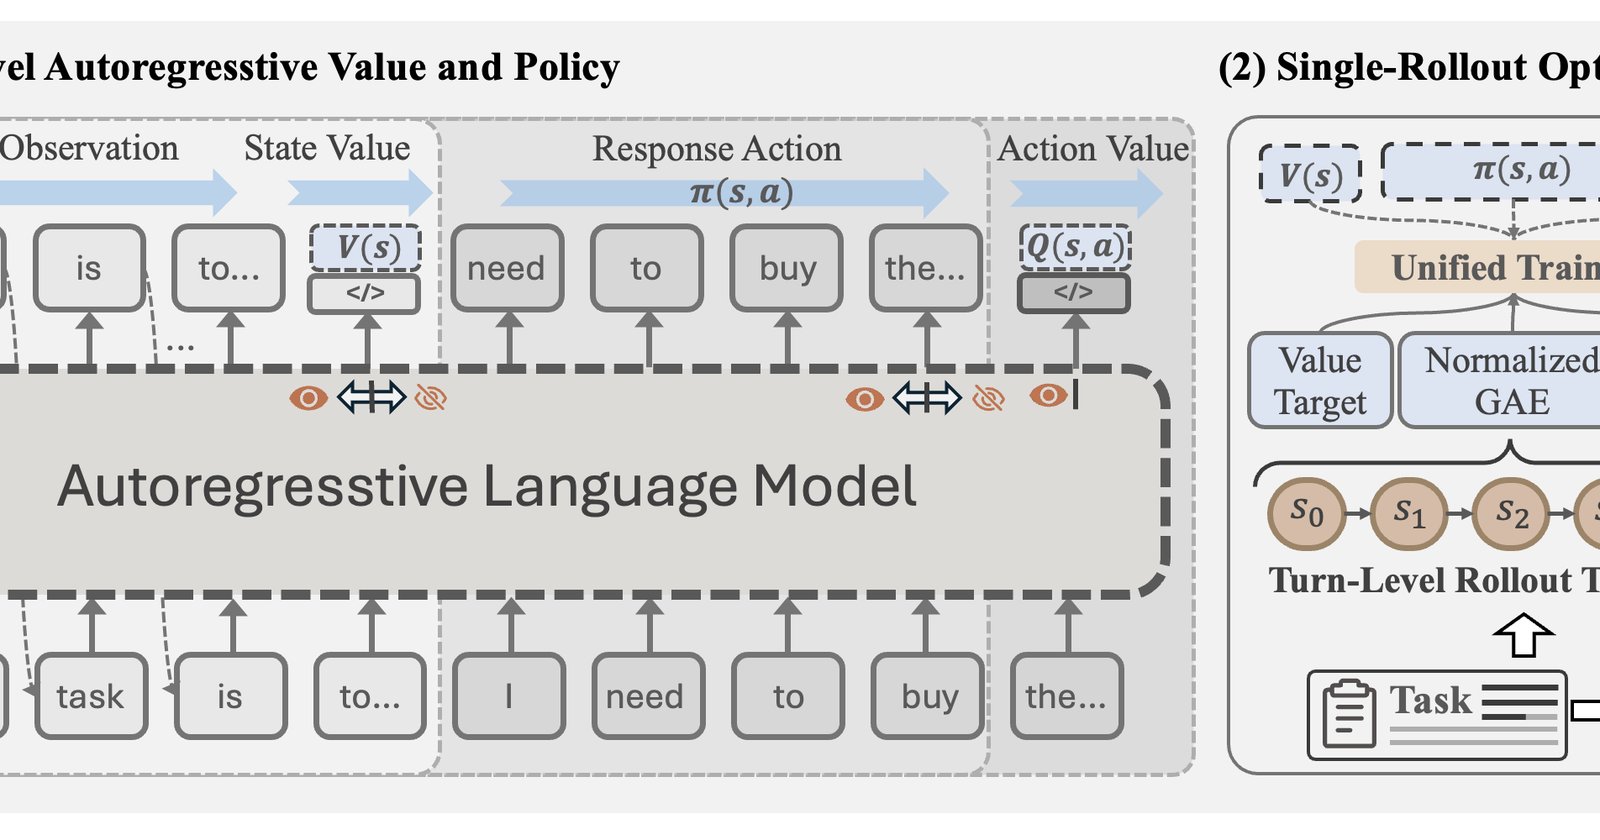
Framework compartilha backbone autoregressivo para policy e value, eliminando modelo critic separado
O que aconteceu
Em 20 de agosto de 2026, foi publicado no arXiv o paper "SAPO: Single-Rollout Autoregressive Policy Optimization for Agentic Reinforcement Learning" (arXiv:2608.19842v1). O método proposto consegue treinar modelos de linguagem de forma mais eficiente, superando o PPO (Proximal Policy Optimization) em 15.1 pontos percentuais e o GRPO (Group Relative Policy Optimization) em 12.1 pontos percentuais. Além da performance superior, o SAPO reduz o tempo de execução por iteração em 33.2% comparado ao PPO e elimina o custo de memória de um modelo critic separado.
Os testes foram realizados com os modelos Qwen2.5-1.5B e Qwen2.5-7B em dois ambientes de simulação: ALFWorld (tarefas domésticas) e WebShop (compras online).
Contexto
O reinforcement learning agentic se tornou uma etapa essencial no pós-treinamento de grandes modelos de linguagem. Métodos existentes, como o PPO, utilizam um modelo critic separado para estimar valores, o que gera alto custo de memória. Alternativas sem critic, como o GRPO, usam múltiplas execuções para estimar vantagens, mas apresentam três problemas apontados pelos autores: falta de generalização explícita de valor e alocação temporal eficaz de crédito; risco de colapso de vantagem em tarefas complexas de longo horizonte; e necessidade de um compromisso custoso entre orçamento de amostragem e performance.
Por que importa
O SAPO resolve essas limitações ao compartilhar uma única rede backbone autoregressiva entre as funções de política e valor. A estrutura autoregressiva dos LLMs é aproveitada para gerar predições de política e valor em limites causais distintos, otimizando independentemente os objetivos do PPO e objetivos auxiliares SARSA on-policy. Uma nova técnica de estimação de vantagem a nível de trajetória combina lambda-returns com normalização por lote para avaliar robustamente a contribuição de cada turno.
Impacto
A eliminação do modelo critic separado representa uma redução significativa nos requisitos de memória para treino de LLMs. Com 33.2% menos tempo por iteração, laboratórios e empresas podem acelerar ciclos de experimentação. O desempenho superior em ambientes de longo horizonte indica que o método pode ser relevante para treinar agentes autônomos em tarefas reais que exigem múltiplas interações.
O que muda
O SAPO abre caminho para uma abordagem mais eficiente no treino de modelos focados em agência. Ao reduzir barreiras computacionais sem sacrificar performance, o método pode democratizar o acesso a técnicas avançadas de RL para equipes com menos recursos. A compatibilidade com modelos já treinados, como a família Qwen, sugere aplicabilidade prática imediata.
O que vem agora
O paper foi publicado recentemente e ainda aguarda validação pela comunidade. Próximos passos incluem testes em mais ambientes, adaptação para modelos maiores e possíveis implementações em frameworks de treino populares. A eficiência computacional do SAPO pode incentivar novas pesquisas em métodos de RL que compartilham parâmetros entre políticas e valores.