
SEAG: novo framework preserva privacidade em RAG sem expor dados a LLMs externos
Pesquisadores propõem gerador de aliases para substituir entidades confidenciais antes do envio a modelos de terceiros.
O que aconteceu
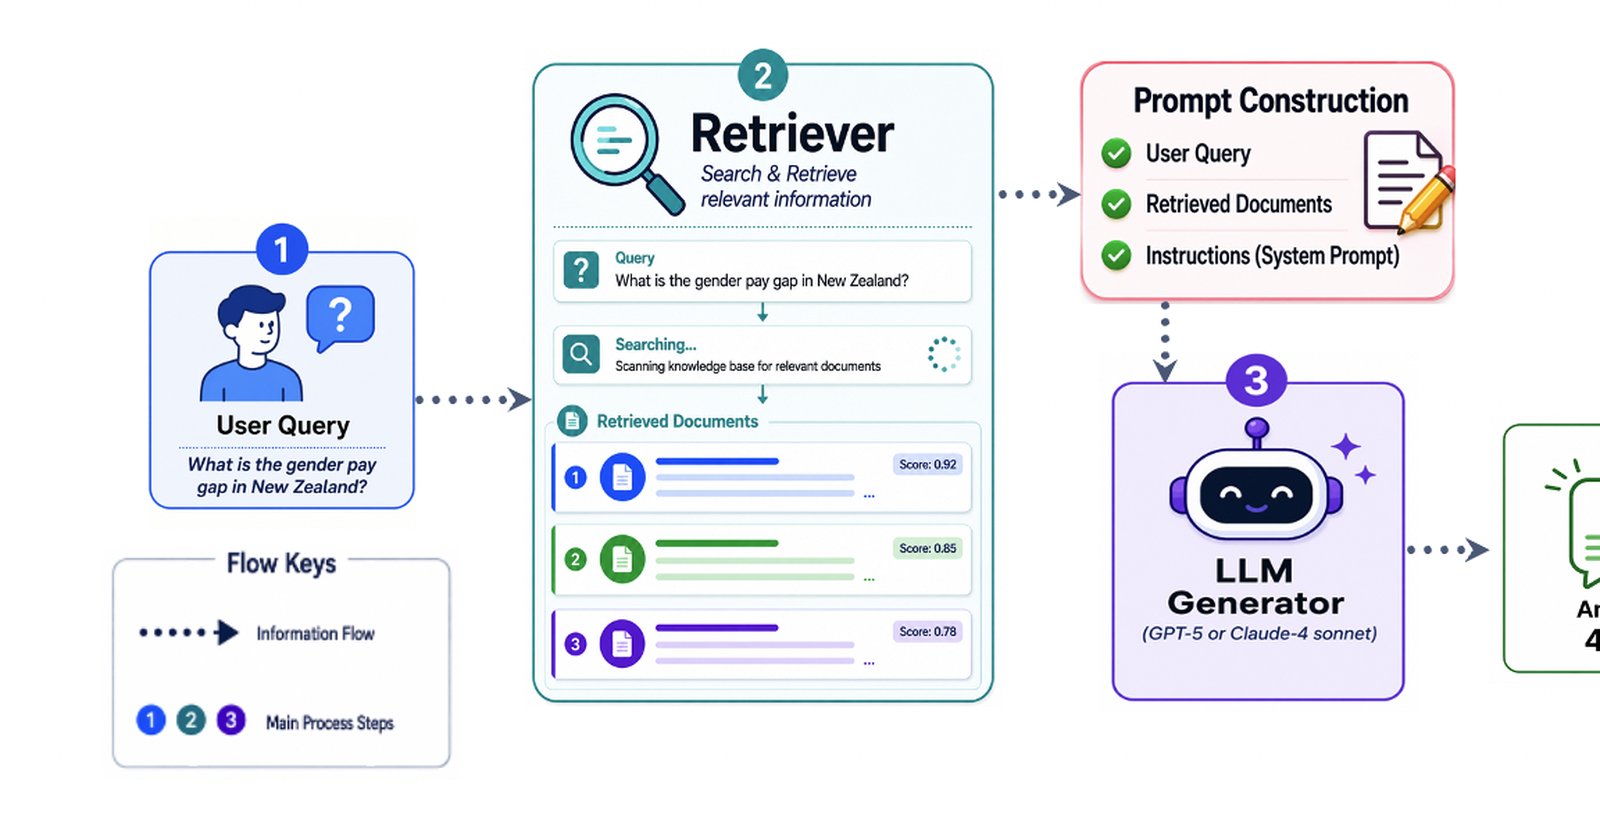
Pesquisadores (arXiv:2608.12675) lançaram o SEAG, um framework de preservação de privacidade para Retrieval-Augmented Generation (RAG). O problema abordado é diferente do foco tradicional: além de impedir acesso não autorizado, o SEAG protege os dados confidenciais que o próprio gerador externo recebe — tanto na consulta do usuário quanto nos documentos recuperados. O framework usa um modelo leve para localizar entidades sensíveis, gerar aliases e construir uma tabela de substituição, que é aplicada antes do envio ao LLM externo.
Contexto
Pesquisas anteriores em privacidade para RAG concentraram-se em controlar quem acessa os dados. Mas, quando um serviço de terceiros processa a consulta e os documentos, essas informações ficam expostas ao provedor do modelo. O SEAG ataca exatamente essa lacuna, permitindo que usuários aproveitem geradores poderosos sem revelar conteúdo confidencial.
Por que importa
Empresas que usam APIs de LLMs (como GPT, Claude ou outros) em sistemas RAG muitas vezes precisam enviar dados internos para processamento. O SEAG oferece uma camada extra de proteção, reduzindo o risco de vazamento ou uso indevido de informações por parte do provedor. Isso é relevante para setores regulados (saúde, finanças, jurídico) e para qualquer organização que lide com dados proprietários.
Impacto
Nos experimentos, todos os modelos SEAG atingiram mais de 80% de precisão na métrica User, que mede a capacidade de responder corretamente ao usuário enquanto esconde informações sensíveis do gerador externo. Em uma análise adicional, a capacidade de ocultar todas as entidades sensíveis em documentos foi de 77,83% (Qwen-3), 76,73% (LLaMA-3.2) e 74,91% (Phi-4). Os resultados indicam que é viável manter a utilidade do RAG sem comprometer a privacidade.
O que muda
O SEAG introduz uma abordagem prática e leve para anonimização em tempo real. Em vez de criptografia ou técnicas pesadas, ele usa substituição de entidades por aliases, o que pode ser integrado a pipelines existentes sem grandes custos computacionais. Isso abre caminho para adoção em produção, especialmente em cenários onde a troca de dados com LLMs externos é inevitável.
O que vem agora
Os pesquisadores construíram dois datasets — um para fine-tuning dos modelos SEAG e outro para avaliação do framework completo. Os próximos passos naturais incluem expandir os testes para mais domínios, melhorar a precisão na ocultação de entidades e explorar integração com outros modelos de linguagem. O artigo está disponível no arXiv e pode servir de base para novas soluções de privacidade em IA generativa.