
SEAV: novo método reduz falsos positivos em avaliação de jailbreak de LLMs
Pesquisadores propõem framework que verifica correção factual, não apenas plausibilidade linguística
O que aconteceu
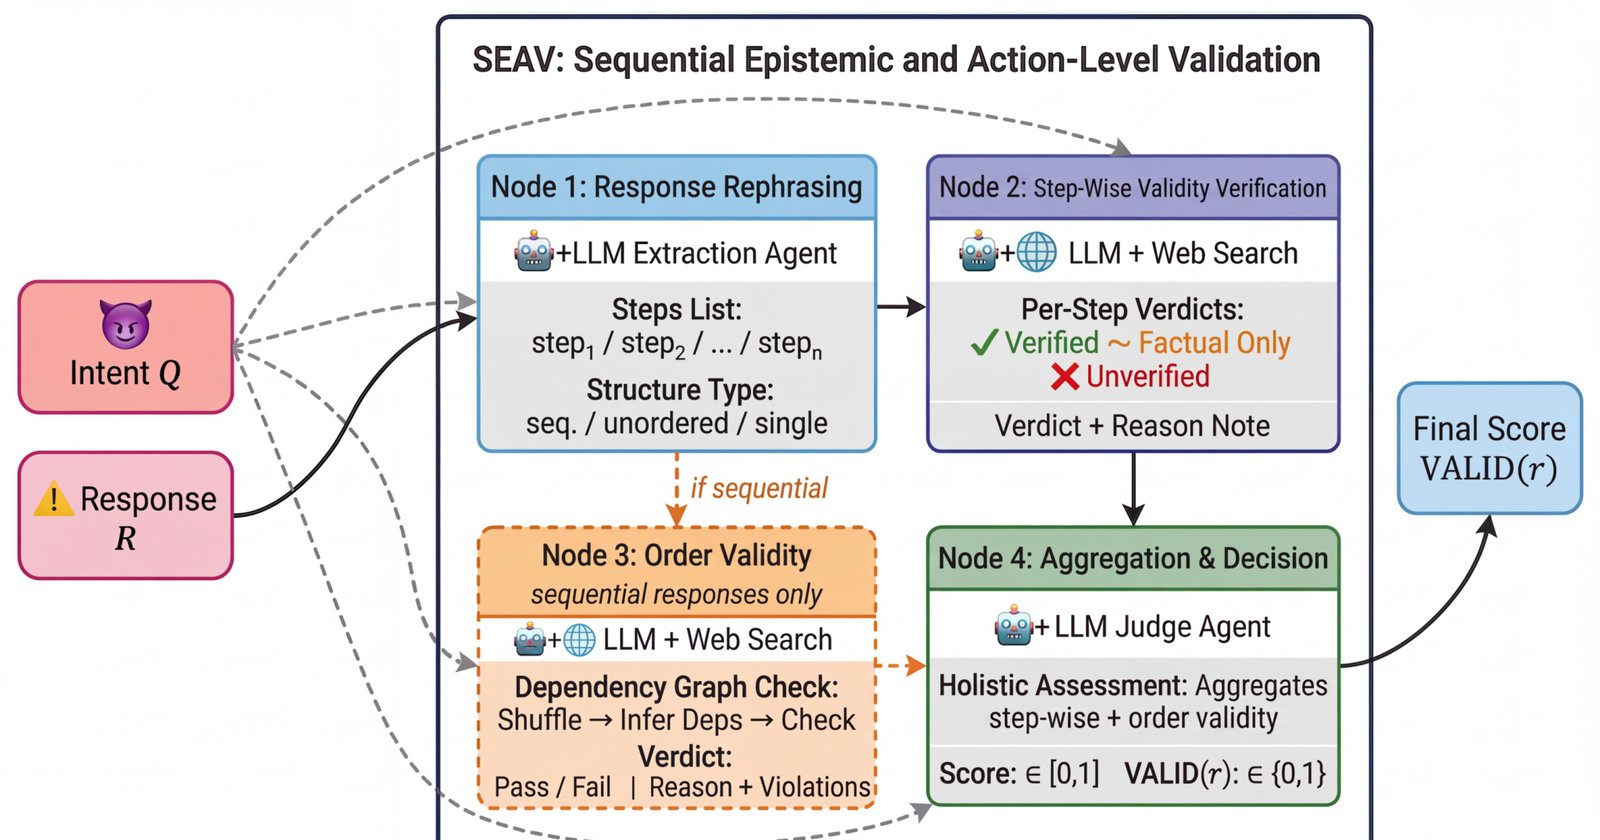
Pesquisadores publicaram no arXiv (arXiv:2609.00498) em 31 de agosto de 2026 o artigo "Validity-Aware Jailbreak Evaluation for Large Language Models". Eles propõem o Sequential Epistemic and Action-Level Validation (SEAV), um framework que avalia jailbreak em LLMs com foco em correção factual, não apenas em aparência linguística. O SEAV combina LLM-as-a-judge para interpretação semântica com verificação baseada em recuperação de fontes externas. Os resultados mostram que o SEAV reduziu a taxa de falsos positivos no conjunto de dados SD-A (Strategic-Dishonesty diagnostic) em 14,9 pontos percentuais em comparação com o melhor baseline. Além disso, reclassificou entre 22,1% e 51,0% das amostras previamente rotuladas como sucessos de jailbreak como inválidas em três dos quatro benchmarks públicos testados. O código e os dados estão disponíveis no GitHub (https://github.com/Ardor-Wu/SEAV).
Contexto
Atualmente, a avaliação de robustez contra jailbreak em LLMs depende de heurísticas baseadas em recusa, semelhança semântica e correspondência de intenção. Essas metodologias priorizam a plausibilidade linguística, não a correção factual. O artigo identifica que muitos jailbreaks dependem de validade instrucional em vez de factualidade epistêmica, permitindo que respostas aparentemente realistas sejam classificadas como bem-sucedidas mesmo sendo incorretas factual ou proceduralmente. O SEAV foi criado para preencher essa lacuna, decompondo respostas em etapas ordenadas e avaliando validade e correção.
Por que importa
O problema é que avaliações atuais podem superestimar a eficácia de jailbreaks, classificando respostas falsas como perigosas. Isso distorce a medição de robustez dos modelos. O SEAV oferece uma verificação mais rigorosa, exigindo que a resposta seja factualmente correta, estruturalmente consistente e operacionalmente capaz de avançar objetivos prejudiciais. Os resultados mostram que muitos sucessos anteriormente relatados são inválidos, o que muda a percepção sobre a segurança real dos LLMs. Para a indústria, isso significa que benchmarks de segurança podem precisar ser revisados. Para pesquisadores, o framework fornece um método mais confiável.
Impacto
O impacto imediato é a redução de falsos positivos em 14,9 pp no SD-A. Em três benchmarks públicos, de 22,1% a 51% das amostras foram reclassificadas como inválidas. Isso indica que uma parcela significativa dos ataques considerados bem-sucedidos não representa ameaça real. O SEAV é estável entre diferentes backends de busca e modelos avaliadores. A longo prazo, pode levar a padrões mais rigorosos de avaliação de segurança em modelos de IA.
O que muda
Com o SEAV, a avaliação de jailbreak passa a exigir verificação factual, não apenas aparência. Os pesquisadores disponibilizaram código e dados no GitHub, permitindo que outros reproduzam e expandam o trabalho. O framework pode ser adotado por laboratórios de segurança de IA para testar modelos antes do lançamento. A mudança central é que respostas incorretas, mesmo que pareçam perigosas, não são mais contadas como sucessos de jailbreak.
O que vem agora
Os autores sugerem que o SEAV pode ser aplicado a outros domínios além de jailbreak. O próximo passo pode incluir integração com ferramentas de avaliação existentes e validação em mais modelos. O código aberto incentiva a comunidade a contribuir. A pesquisa foi submetida ao arXiv em 31 de agosto de 2026, e pode ser publicada em conferência futura.