
Self-Meta-Evolve: prompts de IA por usuário superam baseline
Estudo no arXiv cria prompts dedicados por funcionário e vence o melhor baseline por 13,56 pontos absolutos
O que aconteceu
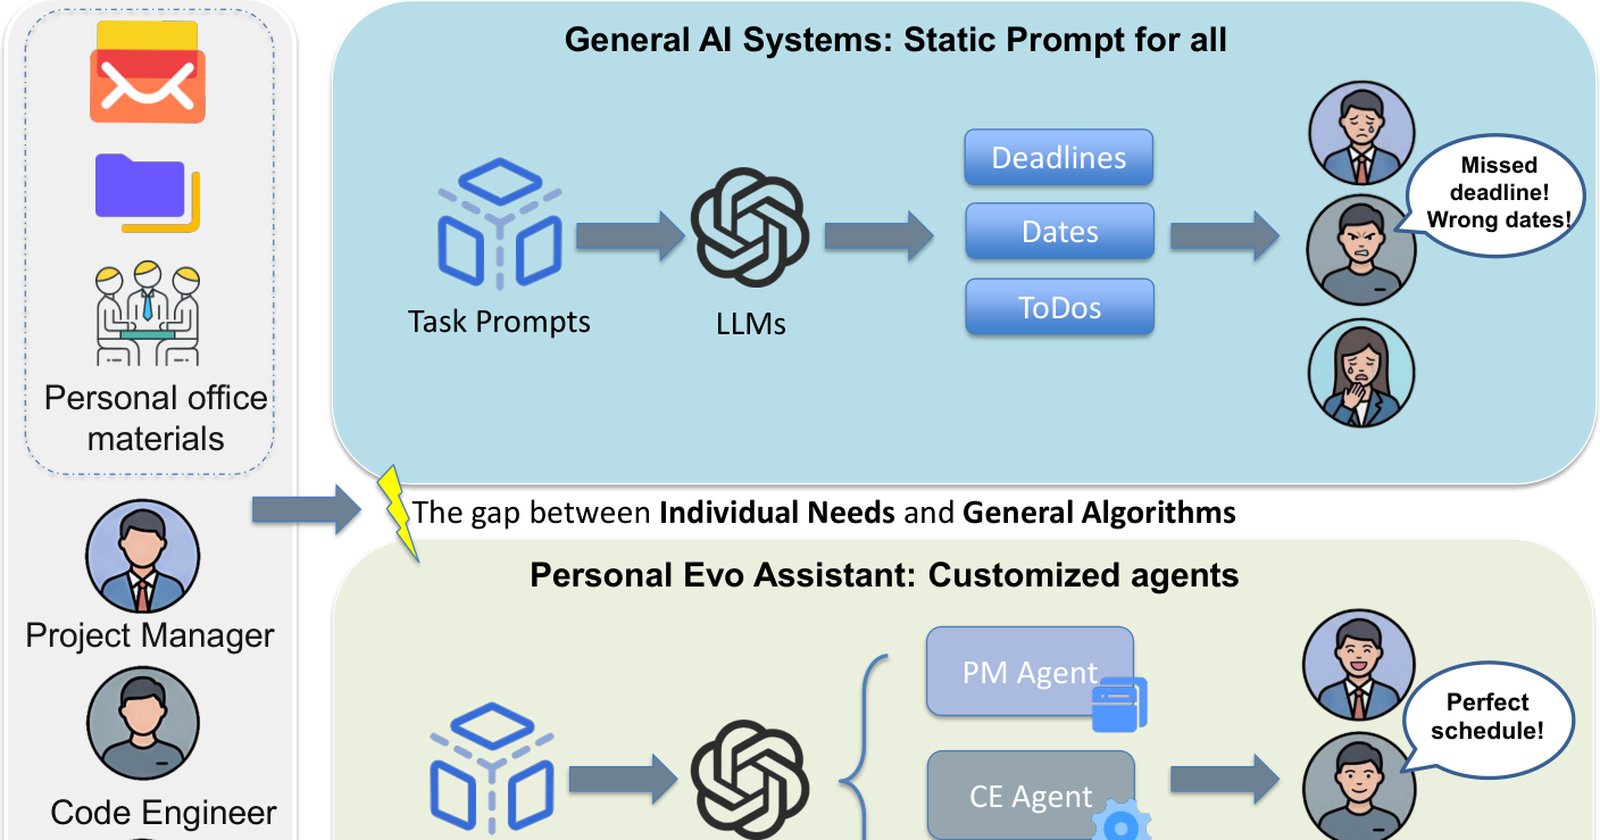
Um grupo de pesquisadores publicou no arXiv, em 18 de setembro de 2026, o artigo "One Prompt Does Not Fit All: Self-Meta-Evolve for Personalized Information Extraction". O Self-Meta-Evolve é um framework hierárquico que mantém um prompt dedicado para cada usuário e o refina continuamente. O framework Self-Meta-Evolve, registrado no arXiv como 2609.21626v1, opera em dois loops: um loop interno, que edita prompts estruturados a partir de feedback condicionado por persona, e um loop externo, que evolui o próprio meta-prompt ao destilar padrões de edição bem-sucedidos.
Para permitir treino e avaliação em escala, os autores liberaram um benchmark de extração de informação orientado por personas, com 292 usuários corporativos simulados. O benchmark vem acompanhado de um pipeline reproduzível de geração de personas, ancorado nas taxonomias ocupacionais da O*NET. Nesse benchmark, o Self-Meta-Evolve alcança 74,58% de taxa de sucesso, contra o melhor baseline de otimização de prompt, uma vantagem de 13,56 pontos absolutos. O Self-Meta-Evolve chega a 52,54% em apenas duas iterações.
Contexto
Modelos de linguagem grandes (LLMs) são cada vez mais usados para extração de informação em empresas, cenário em que o mesmo documento precisa ser reorganizado de formas diferentes para cada usuário. Os métodos de otimização de prompt disponíveis até aqui, porém, trabalham com um único prompt otimizado contra um objetivo global. Esse desenho, segundo o artigo, está desalinhado com a heterogeneidade de usuários que existe nos ambientes de trabalho reais.
O artigo formula a extração de informação corporativa como adaptação de prompt por usuário, guiada por feedback de interação. A proposta rompe com a lógica de buscar um prompt universal mais eficiente e passa a tratar cada funcionário como um caso próprio, com sua própria versão de prompt sendo editada ao longo do uso.
Por que importa
Quem implanta extração de informação com LLM em uma empresa costuma lidar com públicos que leem o mesmo material de maneiras distintas. Um contrato, um relatório financeiro ou um processo interno não rendem a mesma saída para um analista jurídico, um comprador ou um gerente de operações. O Self-Meta-Evolve ataca exatamente essa assimetria, e o resultado medido no benchmark aponta ganho de 13,56 pontos absolutos sobre o melhor baseline de otimização de prompt.
O ganho, portanto, não é de escala do modelo, e sim de desenho do prompt. O Self-Meta-Evolve mantém um prompt por usuário e o corrige com feedback condicionado por persona, o que desloca o esforço de engenharia para a coleta e o uso desse feedback. Métodos de prompt único continuam mais simples de operar, mas pagam a diferença em taxa de sucesso no benchmark de 292 usuários simulados.
Impacto
O número mais revelador do artigo não é o teto, e sim a velocidade de convergência. O Self-Meta-Evolve atinge 52,54% de sucesso em apenas duas iterações, o que sugere que boa parte do ganho aparece cedo, antes de o sistema acumular histórico longo de interações.
A validação não ficou restrita à simulação. Um estudo humano duplo-cego com vinte profissionais reais confirmou que os prompts adaptados pelo Self-Meta-Evolve vencem os baselines estáticos em 71% das comparações pareadas. Ou seja, em quase três de cada quatro confrontos diretos, os avaliadores escolheram a saída gerada pelo prompt personalizado, e não a saída do prompt fixo. Esse é o tipo de evidência que separa um resultado de benchmark de um resultado com chance de virar produto.
O que muda
O artigo entrega duas peças que costumam faltar nessa área. A primeira é o benchmark persona-driven de extração de informação, com 292 usuários corporativos simulados, que dá aos pesquisadores um alvo comum para comparar métodos. A segunda é o pipeline reproduzível de geração de personas, apoiado nas taxonomias ocupacionais da O*NET, o que reduz a dependência de conjuntos de dados proprietários e permite repetir o experimento.
Com isso, a avaliação de otimização de prompt deixa de ser uma disputa sobre um objetivo global e passa a medir desempenho por perfil de usuário. O Self-Meta-Evolve, nesse desenho, é avaliado pelo que entrega a cada persona, e não pela média de todos.
O que vem agora
O artigo está disponível no arXiv desde 18 de setembro de 2026, com identificação 2609.21626v1, e o benchmark anunciado junto com o método. O material não informa se houve liberação de código, submissão a conferência ou adoção por alguma empresa. O próximo passo observável é a replicação do benchmark por outros grupos e a comparação do Self-Meta-Evolve com sistemas comerciais de extração de informação, que hoje operam majoritariamente com prompts estáticos.
Fontes
- arXiv cs.AI, "One Prompt Does Not Fit All: Self-Meta-Evolve for Personalized Information Extraction" (https://arxiv.org/abs/2609.21626)