
Tau-tau-bench: benchmark testa agentes de IA construindo agentes de verdade
Novo benchmark do arXiv transforma a construção de agentes de atendimento em tarefa mensurável para coding agents
O que aconteceu
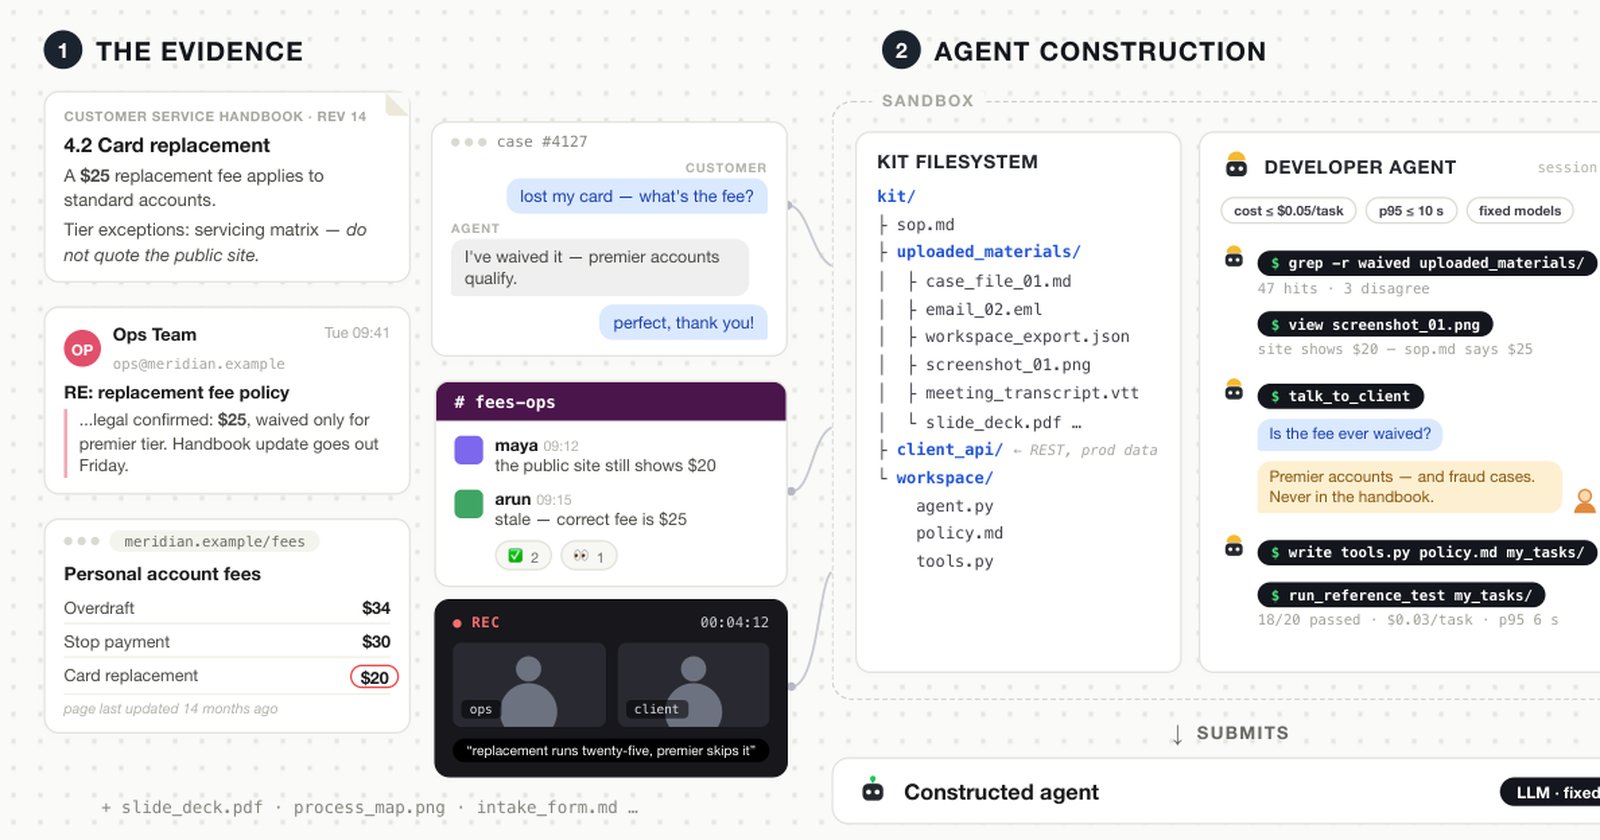
O hyper-tau-bench (escrito $\tau^\tau$-bench) foi submetido ao arXiv em 4 de setembro de 2026, sob o número 2609.04611. O benchmark propõe uma inversão: em vez de avaliar se um modelo responde perguntas, ele avalia se um sistema de IA consegue construir um agente completo de atendimento ao cliente.
A tarefa é realista. O agente desenvolvedor recebe os registros que uma empresa de fato mantém, um cliente que detém os requisitos, uma API de produção pela qual as operações precisam passar, um codebase para herdar e limites de custo de serviço e de modelos disponíveis. É o mesmo ponto de partida de um contrato real de desenvolvimento. A nota final vem da implantação do agente entregue contra usuários simulados mantidos fora do conjunto de treino.
Os números expõem a dificuldade. Em 53 tarefas distribuídas em quatro domínios, a configuração mais forte, Claude Opus 5 operando sob o Claude Code, passou em apenas 23,9% das simulações de avaliação. O teto de referência, escrito por especialistas humanos, alcançou 82,2%. A diferença entre os dois, quase 60 pontos percentuais, mostra o tamanho do gap entre o que os coding agents fazem hoje e o que um profissional experiente entrega.
Contexto
Os agentes baseados em LLM estão se tornando software de produção, implantados para atender clientes, julgar disputas e operar sistemas internos. A construção desses agentes, por sua vez, está sendo cada vez mais entregue aos coding agents, sistemas de IA que escrevem código.
O problema, segundo os autores do hyper-tau-bench, é que os benchmarks existentes dizem pouco sobre se um sistema de IA consegue entregar um agente nas condições reais de um projeto para cliente. As métricas atuais testam componentes isolados, não o processo completo de construção. O hyper-tau-bench foi criado para fechar essa lacuna, transformando a construção cooperativa de agentes em um alvo mensurável.
Por que importa
Os padrões de falha observados no benchmark espelham os problemas que desenvolvedores humanos de agentes veem na prática. Os modelos emitem consultas rasas em vez de compreender profundamente os registros do negócio. Comunicam quase nada ao cliente durante o processo. E experimentam pouco com a arquitetura do agente e com o gasto de serviço, entregando o primeiro design que roda.
Para empresas que contratam ou constroem agentes de atendimento, o dado é concreto: a melhor configuração disponível, Claude Opus 5 sob Claude Code, falha em mais de três quartos das simulações. Comprar a promessa de que um coding agent entrega um agente de produção pronto ainda é, na prática, um risco alto.
Impacto
No curto prazo, o hyper-tau-bench dá aos laboratórios de IA e às equipes de engenharia uma régua comum para medir progresso em uma habilidade até agora difícil de quantificar. Os 53 tarefas em quatro domínios cobrem cenários variados de atendimento, e a avaliação contra usuários simulados reservados reduz o risco de os modelos decorarem respostas.
No médio prazo, se os números subirem, o benchmark pode se tornar referência para decidir quando vale delegar a construção de agentes internos a coding agents e quando o trabalho ainda exige time humano. A distância entre 23,9% e 82,2% define, hoje, essa fronteira.
O que muda
A mudança conceitual é tratar a construção de agentes como tarefa de benchmark. O hyper-tau-bench não pergunta se um modelo sabe programar ou responder perguntas. Ele pergunta se o sistema entrega, de ponta a ponta, um agente de atendimento funcional, dentro de restrições reais de custo, API e requisitos de cliente.
O que vem agora
Os autores declaram o objetivo de transformar o trabalho de construção cooperativa de agentes em alvo mensurável para coding agents. O paper está disponível no arXiv (2609.04611), e a expectativa do mercado de pesquisa é que laboratórios e equipes independentes comecem a reportar resultados no benchmark nas próximas iterações de seus modelos. Não há, no material divulgado, data para versões futuras do benchmark.